云计算
一句话总结:云计算按需租用算力与存储,让 ML 团队无需自购硬件就能训练与部署大模型,核心是服务模型、容器编排、存储网络、Serverless 与成本控制的组合拳。
云计算按需提供 ML 负载所需的基础设施,让你不必自己拥有硬件。本节涵盖服务模型、主要云厂商、容器与 Kubernetes、存储、云网络、Serverless、成本管理以及基础设施即代码。
- 训练一个前沿模型要用几千块 GPU 跑好几个月。没有哪家创业公司自己拥有这么多硬件。云计算让你按小时租用,训练时扩上去,推理时缩下来,只为实际用量付费。想搞超出笔记本范围的 ML 系统,弄懂云基础设施是必修课。
云服务模型
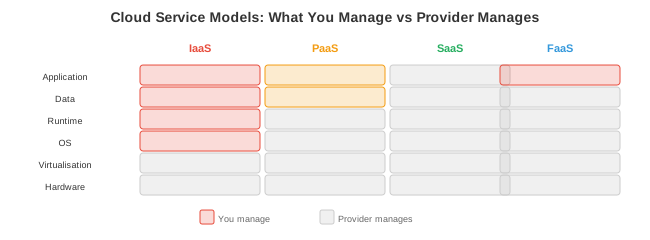
- 云服务按厂商托管的多寡分层:
| 模型 | 你管 | 厂商管 | 例子 |
|---|---|---|---|
| IaaS (基础设施) | 操作系统、运行时、应用 | 硬件、虚拟化、网络 | AWS EC2、GCP Compute Engine |
| PaaS (平台) | 应用、数据 | 操作系统、运行时、扩缩容、打补丁 | AWS SageMaker、GCP Vertex AI |
| SaaS (软件) | 什么都不用管 (直接用) | 全部 | OpenAI API、Weights & Biases |
| FaaS (函数) | 单个函数 | 其他一切 | AWS Lambda、GCP Cloud Functions |
- 对 ML 而言:大多数团队会混着用。IaaS 用于自定义训练 (对 GPU 实例有完全控制), PaaS 用于托管的训练与服务 (SageMaker、Vertex AI 帮你搞定编排), SaaS 用于工具 (W&B 做实验追踪,OpenAI API 做基线对比)。
主要云厂商
AWS (Amazon Web Services)
- 最大的云厂商 (约 32% 市场份额)。关键 ML 服务:
- EC2:虚拟机。GPU 实例:p4d (A100)、p5 (H100)、g5 (A10G,用于推理)。
- S3:对象存储 (Object Storage)。存数据集和模型权重的标配。容量近乎无限,约 $0.023/GB/月。
- SageMaker:托管 ML 平台。搞定训练、超参数调优、部署、监控一条龙。
- EKS:托管 Kubernetes。
- Lambda:无服务器 (Serverless) 函数。不适合 GPU 负载,但用于预处理和编排很好使。
GCP (Google Cloud Platform)
- 谷歌的云 (约 11% 市场份额)。关键 ML 服务:
- Compute Engine:虚拟机。GPU 实例支持 A100、H100。还有 TPU VM 提供 TPU 访问。
- GCS:对象存储 (类似 S3)。
- Vertex AI:托管 ML 平台。原生支持 JAX/TPU。
- GKE:托管 Kubernetes (最成熟的 K8s 服务,毕竟 Kubernetes 就是谷歌搞出来的)。
- Cloud TPU: GCP 独有。v5e 和 v5p 用于大规模训练。
Azure (Microsoft)
- 微软的云 (约 23% 市场份额)。关键 ML 服务:
- Azure VM: GPU 实例,支持 A100、H100。
- Azure Blob Storage:对象存储。
- Azure ML:托管 ML 平台。
- AKS:托管 Kubernetes。
- OpenAI Service:通过 Azure API 独家访问 OpenAI 模型。
容器与 Kubernetes
- 容器 (Docker) 和 Kubernetes 的概念我们在第 13 章 (操作系统) 讲过,实操在第 15 章 (部署) 也讲过。这里我们聚焦云上专用的模式:
面向 ML 的 Kubernetes
-
Kubernetes (K8s) 大规模编排容器。关键概念:
-
Pod:最小的可部署单元。包含一个或多个容器,共享网络和存储。一个模型服务 Pod 里可能有:模型服务容器 + 一个 sidecar 容器用于收集指标。
-
Deployment:管理一组相同的 Pod。指定期望副本数。Pod 挂了,K8s 自动补一个新的。
-
Service:一组 Pod 的稳定网络端点。客户端连到 Service, K8s 把请求路由到健康的 Pod。类型有:ClusterIP (内部)、NodePort (通过节点端口对外)、LoadBalancer (通过云厂商 LB 对外)。
-
StatefulSet:类似 Deployment,但用于有状态负载。每个 Pod 有持久化身份和稳定存储。用于数据库和分布式训练 (每个 worker 需要稳定身份用于通信)。
-
DaemonSet:在每个节点上跑一个 Pod。用于:监控代理 (Prometheus node exporter)、日志收集器 (Fluentd)、GPU 设备插件 (NVIDIA device plugin)。
-
-
K8s 里的 GPU 调度: NVIDIA 设备插件把 GPU 暴露为 K8s 资源。Pod 通过声明来请求 GPU:
- K8s 会把该 Pod 调度到有 2 块可用 GPU 的节点上。云上的 ML 平台就是这么给训练和推理分配 GPU 的。
自动扩缩容
-
水平 Pod 扩缩容 (Horizontal Pod Autoscaler, HPA):根据指标 (CPU 使用率、请求速率、GPU 利用率或队列深度等自定义指标) 扩缩 Pod 数量。
-
集群扩缩容器 (Cluster Autoscaler):扩缩节点数量。如果 Pod 因节点不够而调度不了,集群扩缩容器就从云厂商那里申请新的虚拟机。节点用不满时,它会把 Pod 迁走再把节点回收。
-
KEDA (Kubernetes Event-Driven Autoscaling):基于外部事件源 (Kafka 队列深度、HTTP 请求速率) 扩缩。特别适合推理:请求队列涨了就扩模型服务器,空了就缩下来。
存储
| 类型 | 特点 | 使用场景 | 例子 |
|---|---|---|---|
| 块存储 (Block) | 低延迟,挂到单台 VM | 系统盘、数据库 | AWS EBS、GCP Persistent Disk |
| 对象存储 (Object) | 容量无限,HTTP 访问 | 数据集、模型权重、日志 | AWS S3、GCS、Azure Blob |
| 文件存储 (File) | 跨 VM 共享,兼容 POSIX | 共享训练数据 | AWS EFS、GCP Filestore、NFS |
| 数据湖 (Data Lake) | 读时定 schema,存原始数据 | 分析、特征工程 | Delta Lake、Iceberg、Hudi |
-
ML 训练用什么:数据集存对象存储 (S3/GCS)。训练脚本从对象存储读数据到内存。要快速随机访问 (打乱后的数据加载),有三种办法:(1) 训练前把数据集下到本地 SSD; (2) 用高吞吐文件系统 (Lustre、FSx); (3) 用能高效流式加载并缓存的库 (WebDataset、FFCV)。
-
模型权重:存对象存储并带版本控制。一个 FP16 的 70B 模型大约 140 GB。从 S3 以 1 GB/s 加载要约 2.5 分钟。缓存到本地 SSD 能缩短推理的冷启动时间。
云网络
-
虚拟私有云 (Virtual Private Cloud, VPC):云内一个隔离的网络。你的 VM、数据库、服务在 VPC 内通信。外部流量通过负载均衡器或网关进来。
-
子网 (Subnet):把 VPC 切成若干段。公有子网有互联网访问 (给 API 服务器用)。私有子网没有 (给数据库、GPU worker 用)。这是网络版的"最小权限"安全原则。
-
安全组 (Security Groups) (AWS) / 防火墙规则 (Firewall Rules) (GCP):控制哪些流量被允许。"允许来自任意 IP 的 80 端口入站 HTTP。仅允许来自我 IP 的 22 端口入站 SSH。其他一律拦截。" 配错的安全组是云安全事故第一大原因。
-
服务网格 (Service Mesh) (Istio、Envoy):管理 K8s 内的服务间通信。提供:mTLS 加密 (每次服务间调用都加密)、流量路由 (A/B 测试:把 10% 流量导到新模型)、重试、超时、熔断以及可观测性 (谁调用了谁,花了多长时间)。
Serverless
-
Serverless (AWS Lambda、GCP Cloud Functions):你上传一个函数,云厂商在触发时运行它。没有服务器要管,也不用配扩缩容。按调用次数收费 (通常 100 万次调用 $0.20 + 计算时间)。
-
冷启动 (Cold Start):一段时间没调用后第一次触发会更慢 (厂商得分配容器并加载你的代码)。冷启动 0.5-5 秒,所以 Serverless 不适合对延迟敏感的 ML 推理。
-
对 ML 而言: Serverless 适合:预处理 (发给模型前把图片缩放)、后处理 (格式化模型输出、发通知)、编排 (新数据到达时触发训练流水线) 以及轻量级推理 (小模型且能容忍冷启动)。
-
Serverless 不适合: GPU 推理 (大多数 Serverless 平台不支持 GPU)、长时间训练任务 (Lambda 有 15 分钟超时)、有状态服务 (调用间没有持久化状态)。
成本管理
-
云成本是 ML 团队头号运维焦虑。一台 H100 实例约 $8/小时。一个 64 卡 GPU 训练跑起来约 $500/小时。一个月的训练大约 $360,000。成本优化是工程活儿,不是记账。
-
抢占式实例 (Spot/Preemptible Instances):云厂商卖不掉的闲置产能,打 60-90% 折。厂商可以在 30 秒到 2 分钟通知后把它收回去。适合:容错型训练 (勤存 checkpoint,在新实例上恢复)、批量推理、数据预处理。不适合:对延迟敏感的服务 (被中断 = 停机)。
-
预留实例 (Reserved Instances):承诺 1-3 年的用量,换 30-60% 折扣。适合:已知基线负载的稳态推理服务。
-
自动扩缩容:高峰扩上去,晚上/周末缩下来。一台模型服务器高峰期需要 10 块 GPU,夜间需要 2 块,用自动扩缩容比 24/7 跑 10 块 GPU 省约 60%。
-
规格匹配 (Right-sizing):别为一个 A10G 就够用的 7B 模型用 H100。GPU 要匹配负载。用性能剖析 (第 16 章) 确定哪块 GPU 最合适。
-
存储成本:对象存储便宜 (S3 Standard 每 GB 每月 $0.023), 但会累积。一个团队存了每次训练的 checkpoint (每个 10 GB, 一次实验 100 个, 50 次实验), 累积 50 TB = $1,150/月。设生命周期策略自动清老 checkpoint。
多区域部署
-
面向全球用户的 ML 系统,只部在一个区域意味着远端用户延迟高 (东京用户访问美国服务器多加约 150ms 网络往返) 且是单点故障 (区域挂了整个服务就下线)。
-
多区域模式:
-
主备 (Active-passive):一个主区域处理所有流量。次区域是热备 (数据已复制,随时接管)。主区域故障时 DNS 切到次区域。故障切换期间停机 30 秒到几分钟。
-
双活 (Active-active):两个区域同时处理流量。用户被路由到最近的区域。两个区域数据都是最新的 (异步或同步复制)。单区域故障期间无停机 —— 流量自动重路由。
-
-
数据复制:难点所在。模型权重容易复制 (往每个区域的 S3 上复制一份)。特征仓库数据要在可接受的时延内复制。用户数据可能有数据驻留要求 (GDPR:欧洲用户数据必须留在欧洲)。
-
GPU 云价格对比 (大致,2026):
| GPU | AWS | GCP | Azure | 典型用途 |
|---|---|---|---|---|
| A10G (24 GB) | $1.00/hr (g5) | $0.90/hr | $0.90/hr | 小模型推理 |
| A100 (80 GB) | $4.10/hr (p4d) | $3.70/hr | $3.40/hr | 训练、大模型推理 |
| H100 (80 GB) | $8.00/hr (p5) | $7.50/hr | $7.00/hr | 前沿训练 |
| TPU v5e | 无 | $1.20/hr | 无 | 大规模 JAX 训练 |
- 抢占式价格通常再打 60-70% 折。价格随区域和可用性波动。
基础设施即代码
-
基础设施即代码 (Infrastructure as Code, IaC) 用受版本控制的配置文件定义基础设施 (VM、网络、数据库、K8s 集群)。你不再去 AWS 控制台点按钮,而是写代码描述你想要什么,由工具去创建。
-
Terraform (HashiCorp):标准的 IaC 工具。所有主流云厂商都支持。声明式:你描述期望状态,Terraform 自己算出该创建/修改/删除什么来达到那个状态。
# main.tf —— 创建一台用于推理的 GPU VM
resource "aws_instance" "model_server" {
  ami           = "ami-0abcdef1234567890"  # 深度学习 AMI
  instance_type = "g5.xlarge"               # A10G GPU

  tags = {
    Name = "model-server-prod"
  }
}

resource "aws_s3_bucket" "model_weights" {
  bucket = "my-model-weights-prod"

  versioning {
    enabled = true
  }
}
terraform init      # 下载 provider 插件
terraform plan      # 查看将会有哪些变更
terraform apply     # 创建基础设施
terraform destroy   # 全部销毁
-
IaC 为什么重要:可复现 (从代码重建整套基础设施)、可审计 (git 历史看到谁改了什么)、灾难恢复 (用同一份配置在另一个区域重建)、环境一致性 (dev、staging、prod 用相同模板配不同参数)。
-
Pulumi:类似 Terraform,但用真正的编程语言 (Python、TypeScript、Go) 而不是 HCL。适合基础设施逻辑复杂的场景 (条件、循环、动态配置)。
📌 本节要点
- 服务模型分层: IaaS/PaaS/SaaS/FaaS 由多到少的自管责任,ML 团队通常混用。
- 三大云厂商特色: AWS 最大 (SageMaker)、GCP 有独家 TPU (Vertex AI)、Azure 独家 OpenAI Service。
- Kubernetes 编排: Pod/Deployment/Service/StatefulSet/DaemonSet 是核心概念,通过 NVIDIA 设备插件调度 GPU。
- 三种自动扩缩: HPA 扩 Pod, Cluster Autoscaler 扩节点,KEDA 按外部事件扩缩最适合推理。
- 存储四类:块 (低延迟)、对象 (无限容量,数据集首选)、文件 (共享)、数据湖 (原始数据分析)。
- 网络原则: VPC + 公私子网 + 安全组 + 服务网格,遵循最小权限原则。
- Serverless 界限:适合预处理/后处理/编排/轻推理,不适合 GPU 推理和长训练。
- 省钱四招:抢占式实例、预留实例、自动扩缩容、规格匹配,别忘设存储生命周期策略。
- 多区域权衡:主备便宜但有秒到分钟级停机,双活无缝但数据复制难;注意 GDPR 数据驻留。
- IaC 收益: Terraform/Pulumi 让基础设施可复现、可审计、可灾备、环境一致。