图神经网络
一句话总结:图神经网络通过消息传递让节点从邻居收集信息,由此在不规则图结构上完成节点、边、图三个层级的预测任务。
图神经网络 (Graph Neural Network, GNN) 从图结构化数据中学习:相连节点之间彼此传递消息。 本节覆盖消息传递框架、图卷积网络 (Graph Convolutional Network, GCN)、GraphSAGE、图同构网络 (Graph Isomorphism Network, GIN)、过度平滑、图池化以及节点/边/图三个层级的任务;这些核心架构撑起了分子性质预测、社交网络分析和推荐系统.
-
前两节我们打好了数学地基:几何深度学习 (第 1 节) 告诉我们要利用对称性,图论 (第 2 节) 给了我们节点、边、邻接的语言。 现在我们要直接在图上搭起神经网络。
-
核心难点:图数据是 不规则 的。 图像有固定网格,序列有固定顺序,而图既没有固定的节点数,也没有固定的连接方式,更没有一个"标准"的节点排序。 一个跑在图上的神经网络必须处理这一切,同时还要保持置换等变 (permutation-equivariant),也就是给节点重新贴标签,输出不能变。
消息传递框架
-
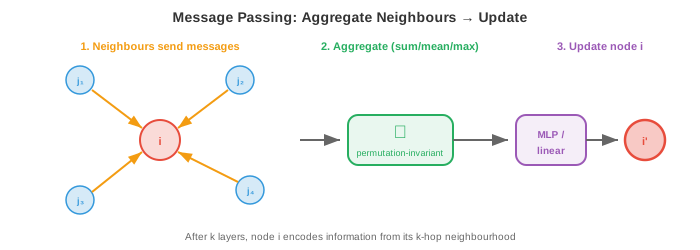
几乎所有 GNN 都遵循同一个套路,叫 消息传递 (message passing,也叫邻居聚合). 想法简单又优雅:每个节点通过收集邻居的信息来更新自己的表示。
-
在每一层 \(l\),每个节点 \(i\) 都做三件事:
- 消息:节点 \(i\) 的每个邻居 \(j\) 根据自己当前的特征算出一条消息 \(\mathbf{m}_{j \to i}\).
- 聚合:节点 \(i\) 收下所有进来的消息,用一个置换不变的函数 (求和、平均或取最大) 把它们合到一起。
- 更新:节点 \(i\) 把聚合后的消息与自己的特征结合起来,产生新的表示。
-
形式化写出来:
- 其中 \(\mathcal{N}(i)\) 是节点 \(i\) 的邻居集合,\(\bigoplus\) 是置换不变的聚合 (sum、mean、max), \(\phi\) 是消息函数,\(\psi\) 是更新函数,\(\mathbf{e}_{ij}\) 是可选的边特征。
-
聚合函数 \(\bigoplus\) 必须置换不变 (处理邻居的先后顺序不能影响结果),这样整体函数才是置换等变的。 这直接把第 1 节的对称性原则落地。
-
消息传递跑 \(k\) 层之后,每个节点的表示都编码了自己 \(k\) 跳邻域 的信息:也就是 \(k\) 条边以内能到达的所有节点。 第 1 层看到直接邻居,第 2 层看到邻居的邻居,以此类推。 局部信息就这样一步步扩散,拼出全局理解。
-
GNN 的感受野随深度增长,跟卷积神经网络 (Convolutional Neural Network, CNN) 的感受野随层数增长 (第 8 章) 是同一个道理。 但和跑在规则网格上的 CNN 不同,GNN 感受野的形状要看图的拓扑结构,每个节点各不相同。
图卷积网络 (GCN)
-
GCN (Kipf & Welling, 2017) 是奠基性的 GNN 架构。 它把 (第 2 节讲过的) 谱图卷积化简成一个优雅高效的公式。
-
从谱卷积 \(g_\theta \star \mathbf{x} = U \, \text{diag}(\hat{g}_\theta) \, U^T \mathbf{x}\) 出发,Kipf 和 Welling 用一阶切比雪夫多项式 (Chebyshev polynomial) 近似谱滤波器,完全避开了特征分解。 化简之后,逐层更新变成:
-
其中:
- \(H^{(l)} \in \mathbb{R}^{n \times d}\) 是第 \(l\) 层的节点特征矩阵
- \(W^{(l)} \in \mathbb{R}^{d \times d'}\) 是可学习的权重矩阵
- \(\hat{A} = \tilde{D}^{-1/2} \tilde{A} \tilde{D}^{-1/2}\) 是带自环的对称归一化邻接矩阵
- \(\tilde{A} = A + I\) 加上自环 (让每个节点也能收到自己的消息)
- \(\tilde{D}\) 是 \(\tilde{A}\) 的度矩阵
- \(\sigma\) 是非线性激活 (如修正线性单元 (Rectified Linear Unit, ReLU),见第 6 章)
-
矩阵乘法 \(\hat{A} H^{(l)}\) 就是聚合步:对每个节点,它算出邻居特征 (再加上自己,通过自环) 的加权平均。 权重矩阵 \(W^{(l)}\) 是可学习的变换,所有节点共享。 激活函数负责补上非线性。
-
简单得惊人:就是矩阵乘法,加一个可学习线性映射,再加一个激活。 整个 GCN 层用一行代码就能写完。 \(\tilde{D}^{-1/2}\) 的归一化能防止连接数多的节点占据主导:高度节点的消息会被缩小。
-
套进消息传递框架,GCN 是这样:
- 消息:\(\phi(\mathbf{h}_j) = \mathbf{h}_j\) (直接把自己的特征发出去)
- 聚合:按度归一化的求和
- 更新:线性变换 + 激活
GraphSAGE
-
GCN 是 直推式的 (transductive):训练时必须拿到整张图,也没法处理新的、没见过的节点。 社交网络里来了一个新用户,GCN 得在整张图上重新训练。 GraphSAGE (Hamilton et al., 2017) 用 归纳式 (inductive) 思路解决了这个问题。
-
关键思想是 邻居采样:不用全部邻居,而是采样一个固定大小的子集。 这样计算量就与整张图的规模无关,也能推广到没见过的节点和新的图。
-
GraphSAGE 对节点 \(i\) 的更新:
-
其中 \(\mathcal{S}(i)\) 是邻居的 采样 子集 (比如从 500 个邻居里随机抽 10 个). CONCAT 操作明确把节点自己的特征和聚合后的邻居特征分开,让网络能对"自己"和"邻域"学出不同的变换。
-
GraphSAGE 支持多种聚合函数:
- Mean: \(\text{AGG} = \frac{1}{|\mathcal{S}|} \sum_{j \in \mathcal{S}} \mathbf{h}_j\) (简单有效)
- LSTM:把采样到的邻居喂进一个长短期记忆网络 (Long Short-Term Memory, LSTM) (但这会引入顺序依赖,一定程度上破坏置换不变性)
- Pool: \(\text{AGG} = \max(\{\sigma(W_{\text{pool}} \mathbf{h}_j + \mathbf{b})\})\) (先非线性变换再取最大)
-
采样策略让 GraphSAGE 能扩展到超大规模的图。 训练用节点小批:对每个目标节点,第 1 层采 \(k_1\) 个邻居,然后第 2 层对上面每一个再采 \(k_2\) 个邻居。 取 \(k_1 = k_2 = 10\)、两层,每个节点的计算树最多 \(10 \times 10 = 100\) 个节点,与图的规模无关。
图同构网络 (GIN)
-
不同 GNN 架构的 表达能力 (expressive power) 不同:也就是它们区分结构不同的图的能力。 GCN 和 GraphSAGE 虽然在实践中好用,但在能区分哪些图结构这件事上,已经被证明有硬上限。
-
衡量 GNN 表达能力的理论工具是 魏斯费勒-勒曼 (Weisfeiler-Lehman, WL) 测试,这是一个用来检验图同构 (两张图结构是否一致) 的经典算法。 WL 测试通过对每个节点的标签和邻居标签的多重集一起做哈希,不断迭代精化节点标签。
-
GIN (Xu et al., 2019) 就是被设计成达到与 WL 测试同等表达能力的架构,因此是消息传递 GNN 里最强的 (在消息传递的理论上限内). 关键洞察:聚合函数必须在多重集上 单射 (injective) — 也就是不同的邻居特征多重集必须给出不同的聚合值。
-
求和聚合在多重集上是单射的 (\(\{1, 1, 2\}\) 求和是 4, \(\{1, 3\}\) 求和也是 4,但当特征向量维度足够高时,不同多重集的求和几乎总是不同的). Mean 和 max 都不是单射:mean 分不清 \(\{1, 1\}\) 和 \(\{2, 2\}\), max 分不清 \(\{1, 2, 3\}\) 和 \(\{1, 1, 3\}\).
-
GIN 的更新是:
- 其中 \(\epsilon\) 是可学习的标量 (或固定为 0),多层感知机 (Multi-Layer Perceptron, MLP) 提供非线性的单射映射。 求和聚合保留了多重集结构,MLP 则能学会区分任意两个不同的聚合值。
过度平滑
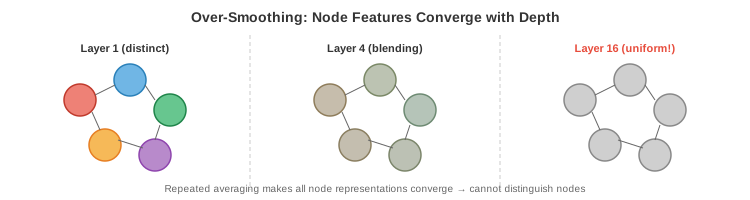
- GNN 的一大难题是 过度平滑 (over-smoothing):层数一多,所有节点的表示就统一收敛到同一个值,再也分不清彼此。
-
机制很直观。 每一层消息传递都在把节点特征和邻居的特征做平均。 平均多轮以后,每个节点都"见过"并混过了自己连通分量内的所有其他节点。 特征最终变成一个统一的平均,相当于把一张图像模糊太多次直到变成一整块单色。
-
从数学上看,反复应用归一化邻接 \(\hat{A}\) 会收敛到一个秩 1 矩阵 (每一行都变得和图上随机游走的稳态分布成正比). 这与幂迭代收敛到主特征向量 (第 2 章) 是同一种收敛。
-
过度平滑把 GNN 的深度限制在很浅的位置 (通常 2-4 层),与 CNN 和 Transformer 那种堆几十上百层还能受益完全不同。 这意味着每个节点只能看到有限的邻域,对需要长程信息的任务是个大麻烦。
-
缓解办法有:
- 残差连接 (来自 ResNet,第 8 章): \(\mathbf{h}_i^{(l+1)} = \mathbf{h}_i^{(l+1)} + \mathbf{h}_i^{(l)}\),把早期层的信息保留下来。
- Jumping knowledge:把所有层 (不只是最后一层) 的表示拼接或用注意力池化。
- DropEdge:训练时随机删边,减慢信息扩散。
- 图 Transformer (第 4 节):用全局注意力绕过局部消息传递的瓶颈。
图池化
-
对 图级任务 (预测整张图的某个性质,比如某个分子有没有毒),我们要把所有节点表示塌缩成一个图级向量。 这就是 图池化,相当于 CNN 里的全局平均池化 (第 8 章) 的图版本。
-
最简单的做法叫 读出 (readout):在所有节点特征这个集合上应用一个置换不变的函数:
-
这就是第 1 节讲过的 DeepSets 聚合,只不过用在最后一层 GNN 之后。 求和保留了大小信息 (100 个节点的图求和会比 10 个节点的图大得多),而平均则对大小做归一化。
-
层次池化 (hierarchical pooling) 逐步把图变粗,模仿 CNN 逐步下采样图像。 每一层里,一组节点被合并成"超节点":
-
DiffPool (Differentiable Pooling,可微池化) 学出一个软分配矩阵 \(S^{(l)} \in \mathbb{R}^{n_l \times n_{l+1}}\),把每个节点分配到一个簇里:
-
分配矩阵由另一个 GNN 预测出来,这样聚类过程端到端可微。 它构造了一个层级:原图 → 节点更少的粗图 → 更粗的图 → 最后一个节点 (整张图的表示).
-
TopKPool 用了一个更简单的路线:给每个节点学一个标量分数,保留分数排前 \(k\) 的节点,剩下的丢掉。 这是硬选择 (不是软分配),比 DiffPool 便宜得多。
异构图
-
到目前为止所有 GNN 都假设图是 同构图 (homogeneous graph):一种节点、一种边。 但现实世界里的图大多是 异构的 (heterogeneous):多种节点类型和多种边类型。 知识图谱有人节点、组织节点、地点节点,由"就职于"、"出生于"、"位于"这些边连起来。 推荐系统里有用户节点和物品节点,由"购买"、"浏览"、"评分"这些边相连。
-
异构图有一个 模式 (schema,也叫元图),定义了允许出现的节点类型和边类型。 每种边类型连接一个特定的源类型和目标类型。 比如"就职于"连接的是"人 → 组织".
-
关系图卷积网络 (Relational GCN, R-GCN) (Schlichtkrull et al., 2018) 处理异构边的做法,是每种边类型用一个单独的权重矩阵:
-
其中 \(\mathcal{R}\) 是所有边类型的集合,\(\mathcal{N}_r(i)\) 是节点 \(i\) 通过关系 \(r\) 相连的邻居集合,\(W_r\) 是关系 \(r\) 专属的权重矩阵。 自连接 \(W_0\) 单独处理节点自身的特征。
-
问题是:关系类型一多,参数量就爆炸 (每种关系一个 \(d \times d\) 矩阵). R-GCN 用 基分解 (basis decomposition) 来缓解:\(W_r = \sum_{b=1}^{B} a_{rb} V_b\),其中 \(V_b\) 是共享的基矩阵,\(a_{rb}\) 是每个关系专属的标量系数。 这类似于低秩分解 (第 2 章):关系专属的矩阵都活在一个低维子空间里。
-
异构图 Transformer (Heterogeneous Graph Transformer, HGT) (Hu et al., 2020) 把注意力机制搬到异构图上。 关键洞察是,注意力应该同时依赖节点类型和它们之间的边类型。 HGT 对查询、键、值都用类型专属的投影矩阵:
-
其中 \(\tau(i)\) 是节点 \(i\) 的类型,\(\phi(i,j)\) 是它们之间的边类型。 这样一来,模型对不同关系类型会用不同的注意力权重:论文关注它的作者时,应该用和它关注参考文献时不一样的权重。
-
基于元路径的方法 (metapath-based) 在模式里定义有意义的路径 (例如"作者 → 论文 → 作者"表示合作关系),然后沿这些路径聚合信息。 HAN (Heterogeneous Attention Network,异构注意力网络) 在两个层级都用注意力:在每条元路径内部 (这条路径上哪些邻居更重要?),以及跨元路径 (哪种关系模式更重要?).
链接预测与知识图谱补全
-
链接预测 (link prediction) 问的是:给定已有的边,哪些缺失的边有可能存在?这是知识图谱补全 (预测缺失事实)、推荐 (预测用户会喜欢哪些物品)、社交网络分析 (预测未来的朋友关系) 的核心任务。
-
基于嵌入的方法 给每个实体学一个向量、给每个关系学一个变换,然后按实体与关系搭不搭配来给候选边打分:
-
TransE 把关系建模为嵌入空间里的平移:如果 \((h, r, t)\) 是一条合法三元组 (头实体、关系、尾实体),那么 \(\mathbf{h} + \mathbf{r} \approx \mathbf{t}\). 打分函数是 \(f(h, r, t) = -\|\mathbf{h} + \mathbf{r} - \mathbf{t}\|\). 直观上说,关系向量把头实体在嵌入空间里"移"到尾实体那里。
-
RotatE 把关系建模为复空间里的旋转:\(\mathbf{t} = \mathbf{h} \circ \mathbf{r}\),其中 \(\circ\) 是逐元素复数乘法,\(|\mathbf{r}_i| = 1\) (单位复数就是旋转). 这样能建模 TransE 搞不定的对称、反对称、逆、组合等模式。
-
ComplEx 用复值嵌入加上厄米内积 (Hermitian dot product),由此能建模不对称的关系 (A 是 B 的老板,但 B 不是 A 的老板).
-
基于 GNN 的链接预测则用消息传递算出节点嵌入,再用两端节点的嵌入给边打分。 这结合了 GNN 的结构推理和嵌入方法的关系建模能力。 GNN 编码器能捕捉多跳邻域结构,这是单个嵌入方法拿不到的信息。
任务类型
-
GNN 解决三类任务:
-
节点级任务:给每个节点预测一个性质。 例子:给社交网络里的用户分类 (机器人还是真人)、预测蛋白质相互作用网络里每个蛋白的功能、半监督节点分类 (给少数几个节点打标签,预测其余节点). 输出就是节点嵌入 \(\mathbf{h}_i^{(L)}\) 过一个分类器。
-
边级任务:给每条边预测一个性质,或者预测边是否存在。 例子:链接预测 (这两个用户会成为好友吗?)、知识图谱补全 (这两个实体之间是否有这种关系?)、药物-药物相互作用预测。 输出通常用两端节点的嵌入:\(\hat{y}_{ij} = f(\mathbf{h}_i, \mathbf{h}_j)\),其中 \(f\) 是点积、拼接后过 MLP,或者别的组合方式。
-
图级任务:给整张图预测一个性质。 例子:分子性质预测 (这个分子有毒吗?)、图分类 (这个社交网络是不是机器人网络?)、图生成 (设计出满足特定性质的分子). 输出用图池化产出 \(\mathbf{h}_G\),再送去分类或回归。
编程练习 (用 CoLab 或 Notebook)
-
用归一化邻接矩阵从零实现一层 GCN. 把它应用到一张小图上,观察节点特征是如何被平滑的。
import jax import jax.numpy as jnp # 图: 5 个节点, 一条简单链带一个分叉 A = jnp.array([[0, 1, 0, 0, 0], [1, 0, 1, 0, 0], [0, 1, 0, 1, 1], [0, 0, 1, 0, 0], [0, 0, 1, 0, 0]], dtype=float) # 加上自环 A_hat = A + jnp.eye(5) D_hat = jnp.diag(A_hat.sum(axis=1)) D_inv_sqrt = jnp.diag(1.0 / jnp.sqrt(A_hat.sum(axis=1))) A_norm = D_inv_sqrt @ A_hat @ D_inv_sqrt # 节点特征: one-hot 单位阵 H = jnp.eye(5) # 权重矩阵 (随机初始化) rng = jax.random.PRNGKey(0) W = jax.random.normal(rng, (5, 3)) * 0.5 # GCN 层: H' = ReLU(A_norm @ H @ W) H_new = jax.nn.relu(A_norm @ H @ W) print("Original features (one-hot):") print(H) print("\nAfter GCN layer:") print(jnp.round(H_new, 3)) print("\nNotice: connected nodes now have similar representations") -
实现求和聚合 (GIN 风格) 的消息传递,与均值聚合 (GCN 风格) 做对比。 展示求和能区分均值区分不了的多重集。
import jax.numpy as jnp # 两个不同的邻居多重集, 但它们的均值相同 # 节点 A: 邻居特征 [1, 1, 1, 1] (四个邻居, 全为 1) # 节点 B: 邻居特征 [2, 2] (两个邻居, 全为 2) neighbours_A = jnp.array([[1.0], [1.0], [1.0], [1.0]]) neighbours_B = jnp.array([[2.0], [2.0]]) # 均值聚合 mean_A = neighbours_A.mean(axis=0) mean_B = neighbours_B.mean(axis=0) print(f"Mean A: {mean_A}, Mean B: {mean_B}, Same: {jnp.allclose(mean_A, mean_B)}") # 求和聚合 sum_A = neighbours_A.sum(axis=0) sum_B = neighbours_B.sum(axis=0) print(f"Sum A: {sum_A}, Sum B: {sum_B}, Same: {jnp.allclose(sum_A, sum_B)}") print("\nSum distinguishes these multisets; mean does not!") -
演示过度平滑。 反复应用归一化邻接,观察节点特征收敛。
import jax.numpy as jnp
import matplotlib.pyplot as plt

# 随机图
A = jnp.array([[0,1,1,0,0,0],
               [1,0,1,0,0,0],
               [1,1,0,1,0,0],
               [0,0,1,0,1,1],
               [0,0,0,1,0,1],
               [0,0,0,1,1,0]], dtype=float)

A_hat = A + jnp.eye(6)
D_inv_sqrt = jnp.diag(1.0 / jnp.sqrt(A_hat.sum(axis=1)))
A_norm = D_inv_sqrt @ A_hat @ D_inv_sqrt

# 初始特征: 每个节点各不相同
H = jnp.array([[1,0], [0,1], [1,1], [-1,0], [0,-1], [-1,-1]], dtype=float)

distances = []
for k in range(20):
    H = A_norm @ H
    # 衡量特征之间还有多不一样 (节点间的标准差)
    spread = jnp.std(H, axis=0).mean()
    distances.append(float(spread))

plt.plot(distances, "o-")
plt.xlabel("Number of message-passing rounds")
plt.ylabel("Feature spread (std across nodes)")
plt.title("Over-Smoothing: Features Converge with Depth")
plt.show()
📌 本节要点
- 消息传递框架:每层每个节点做消息、聚合、更新三步,是几乎所有 GNN 的统一套路。
- 置换等变性:聚合函数必须置换不变,才能保证给节点重命名不改变输出。
- \(k\) 跳感受野: \(k\) 层消息传递让每个节点看到 \(k\) 条边内的所有邻居,类比 CNN 的感受野。
- GCN:用对称归一化邻接矩阵做一步矩阵乘,加权重矩阵和激活,简洁但直推式。
- GraphSAGE:通过邻居采样把 GCN 变成归纳式,可以扩展到超大图和未见节点。
- GIN 与 WL 测试:求和聚合加 MLP 达到 Weisfeiler-Lehman 测试的表达力上限,是消息传递 GNN 里最强的。
- 过度平滑:层数一深,节点特征都被平均成同一个值,限制 GNN 通常只能堆 2-4 层。
- 图池化:读出、DiffPool、TopKPool 把节点表示塌缩成图级向量,支持图级预测。
- 异构图: R-GCN 用关系专属矩阵,HGT 用类型感知注意力,处理多类节点和多类边。
- 三类任务:节点级、边级、图级,分别用节点嵌入、双端嵌入、图池化嵌入作输出。