系统设计基础
一句话总结:系统设计是把 ML 从"训好的模型"变成"可用的产品"的工程学问,客户端-服务器、缓存、数据库、消息队列、一致性模型与韧性模式是它的基本积木。
🗺️ 本章导览
- 本章覆盖 ML 系统设计:基础 → 云计算 → 大规模基础设施 → ML 系统设计 → 设计案例
- 01. 系统设计基础 (本节):一致性、可用性、延迟、吞吐等构件
- 02. 云计算: AWS/GCP/Azure、Kubernetes、Serverless
- 03. 大规模基础设施:分布式存储、消息队列、缓存
- 04. ML 系统设计:特征仓库、模型仓库、A/B 测试
- 05. ML 设计案例:推荐、搜索、广告、反欺诈
系统设计,就是把软件构建得"在大规模下依然可靠地工作". 本节覆盖客户端-服务器架构、网络协议、DNS、代理、负载均衡、缓存、数据库、消息队列、一致性模型与韧性模式.
-
生产环境里的每一个 ML 系统都是分布式系统。 一个推荐引擎不只是一个模型 —— 它是一个 API 服务器、一个特征仓库 (feature store)、一个模型仓库 (model registry)、一个缓存层、一个消息队列、一个监控栈,通过网络彼此通信。 搞懂系统设计,才是把"我训了一个模型"和"我做了一个产品"分开的分水岭。
-
一线大厂 (Google、Meta、Amazon、OpenAI) 的系统设计面试,考的就是你能不能设计出这些系统。 本章给你构件 (本节)、云基础设施 (第 02 节)、扩展模式 (第 03 节)、ML 专用设计 (第 04 节),以及完整设计案例 (第 05 节).
客户端-服务器架构
-
最基础的模式:客户端 (client) 发请求,服务器 (server) 处理并返回响应。 你的浏览器 (客户端) 向 google.com (服务器) 发一个 HTTP 请求,服务器返回 HTML.
-
请求-响应模型 (request-response model):同步。 客户端等响应。 简单,但形成瓶颈:等的时候客户端闲着,服务器必须处理完当前请求才能干下一个。
-
无状态服务器 (stateless server):服务器不记得之前的请求。 每个请求自带全部处理所需的信息。 这让扩展变得容易:任何服务器都能处理任何请求,所以你可以在负载均衡器 (load balancer) 后面加更多服务器。
-
有状态服务器 (stateful server):服务器在请求之间保持状态 (如用户会话). 更难扩展,因为同一用户的请求必须打到同一台服务器 (会话粘性,session affinity). 现代系统避免服务端状态,把状态放到数据库或缓存里 (如 Redis).
网络协议
-
网络的基础我们在第 13 章讲过 (TCP/IP 分层、套接字). 这里聚焦系统设计里最常用的应用层协议:
-
HTTP/HTTPS: Web 和绝大多数 API 的协议。 请求方法:GET (读)、POST (创建/预测)、PUT (更新)、DELETE (删除). HTTPS 在 HTTP 上加了 TLS 加密 (第 13 章安全部分). REST API (第 15 章第 03 节) 就是建在 HTTP 之上。
-
WebSocket:客户端与服务器之间的持久双向连接。 不像 HTTP 那样"请求 → 响应 → 连接关闭", WebSocket 会保持连接打开,用于实时流。 典型用途:大语言模型 (Large Language Model, LLM) 的 Token 流式输出 (边生成边发)、实时仪表盘、聊天应用。
-
gRPC: Google 出的远程过程调用 (Remote Procedure Call, RPC) 框架。 基于 HTTP/2,用 Protocol Buffers 做二进制序列化 (比 JSON 小 10 倍左右,也更快). 支持服务端流、客户端流、双向流。 用于对性能敏感的内部服务间通信。 Triton Inference Server (第 15 章) 和 TensorFlow Serving 都用 gRPC.
-
Protocol Buffers:在
.proto文件里定义消息 schema:
message PredictRequest {
    repeated float features = 1;
    string model_version = 2;
}

message PredictResponse {
    float prediction = 1;
    float confidence = 2;
}

service ModelService {
    rpc Predict(PredictRequest) returns (PredictResponse);
}
- schema 编译到任何语言的客户端/服务端代码 (Python、C++、Go、Java). 类型安全、向后兼容和性能全都白送。
DNS
-
域名系统 (Domain Name System, DNS) 把人可读的域名翻译成 IP 地址 (第 13 章). 在系统设计里,DNS 还能:
-
DNS 层负载均衡:同一个域名返回不同 IP,把流量分散到多台服务器。 简单,但粒度粗 (DNS 结果会缓存几分钟到几小时,流量不能快速再均衡).
-
地理路由 (geographic routing):根据客户端所在地,返回最近的数据中心 IP. 东京的用户走日本机房,伦敦的用户走欧洲机房。
-
故障切换 (failover):服务器挂了,DNS 就不再返回它的 IP,新客户端会去健康的服务器。 但 DNS 缓存意味着有些客户端在几分钟内还会打到那台死机器 (这就是 TTL 问题).
代理
-
代理 (proxy) 是客户端和服务器之间的中间人:
-
反向代理 (reverse proxy) (放在服务器前面):客户端连的是代理,代理再把请求转给后端服务器。 客户端不知道具体是哪台服务器处理的。 Nginx 和 HAProxy 是标准反向代理。 它们提供:负载均衡 (分发请求)、SSL 卸载 (在代理层解 HTTPS,转发明文 HTTP 到后端)、缓存、限流和压缩。
-
API 网关 (API gateway):专门为 API 服务的反向代理。 处理鉴权、限流、请求路由 (不同路径 → 不同服务) 和 API 版本管理。 常见选择有 Kong、AWS API Gateway、Envoy.
-
用在 ML 服务上:API 网关放在你的模型服务器前面。 它验 API Key、对免费用户限速、把
/v1/predict路由到模型服务 A、把/v2/predict路由到模型服务 B,顺便采集用量指标。
负载均衡
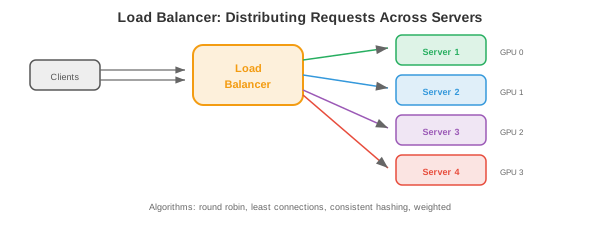
- 一旦你有多台服务器,负载均衡器 (load balancer) 就负责把请求分发过去。
-
算法:
- 轮询 (round robin):按顺序把请求发给服务器 (1, 2, 3, 1, 2, 3...). 简单公平,但没考虑服务器负载。
- 最少连接 (least connections):发给当前活跃连接数最少的服务器。 适合处理时长差异大的请求 (有些 LLM 请求只生成 10 个 Token,有些生成 1000 个).
- 加权轮询 (weighted round robin):容量大的服务器分到更多请求。 一台 80 GB 显存的 GPU 服务器,处理量是 40 GB 那台的 2 倍。
- 一致性哈希 (consistent hashing):把请求的键哈希到特定服务器。 同一个键总是打到同一台服务器。 用于:缓存 (同一用户的请求命中同一台缓存)、会话粘性、前缀缓存 (第 17 章:同一 system prompt 的请求都发给持有对应 KV-cache 的那台服务器).
-
L4 vs L7 负载均衡:
- L4 (传输层):按 IP 和端口路由。 快,但看不到请求内容。
- L7 (应用层):按 HTTP 路径、请求头或请求体路由。 能把
/api/chat路由到聊天服务,把/api/embed路由到嵌入服务。 慢一点,但更灵活。
缓存
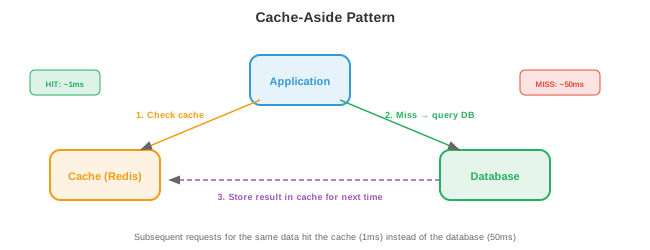
- 缓存 (caching) 把频繁访问的数据放到快速存储层 (内存) 里,避免重复计算或重复读取。
-
缓存模式:
- Cache-aside (惰性加载,lazy loading):应用先查缓存。 未命中则去数据库读,存进缓存,返回结果。 最常见的模式。
- Write-through (写穿透):每一次写同时写缓存和数据库。 保证缓存永远最新,但写入变慢。
- Write-back (写回):写只进缓存,缓存异步刷到数据库。 写最快,但缓存崩溃且尚未刷回时可能丢数据。
-
淘汰策略 (eviction policy) (缓存满了怎么办):
- 最近最少使用 (Least Recently Used, LRU):淘汰最长时间没被访问的条目。 最主流。
- 最不经常使用 (Least Frequently Used, LFU):淘汰访问次数最少的条目。 当某些内容长期热门时更好。
- 生存时间 (Time To Live, TTL):固定时长后条目过期。 用于会变旧的数据 (模型预测缓存 5 分钟、特征值缓存 1 小时).
-
内容分发网络 (Content Delivery Network, CDN):面向静态内容 (图片、JavaScript、CSS) 的全球分布式缓存。 全球 100+ 个节点从最近位置给用户送缓存内容。 用在 ML 上:模型权重可以放 CDN,加速下载。
-
Redis:事实上的标准内存缓存/数据库。 支持字符串、列表、集合、有序集合、哈希、Stream. 亚毫秒级延迟。 用于:缓存模型预测、存会话数据、限流 (统计每个用户每分钟的请求数)、实时特征服务。
-
用在 ML 服务上:缓存重复输入的预测结果。 如果很多用户都问"法国首都是哪"("What is the capital of France?"),算一次答案就够了,后面全走缓存。 聊天机器人场景 20-40% 的命中率很常见,GPU 成本按比例下降。
数据库
SQL (关系型)
-
SQL 数据库 (PostgreSQL、MySQL) 把数据存在行列组成的表里。 表之间的关系通过外键表达。 查询用 SQL. ACID 四大保证:
- 原子性 (Atomicity):事务要么完全提交,要么完全回滚。 没有半成品。
- 一致性 (Consistency):数据库从一个合法状态迁移到另一个合法状态。 约束 (唯一键、外键) 始终成立。
- 隔离性 (Isolation):并发事务互不干扰。
- 持久性 (Durability):已提交的数据能扛住崩溃 (写盘后才 ack).
-
SQL 数据库擅长:有关系的结构化数据、复杂查询 (Join、聚合)、强一致要求、数据完整性。
NoSQL
-
NoSQL 数据库牺牲部分 ACID 保证,换取扩展性和灵活性:
- 键值存储 (Redis、DynamoDB):最简单的模型。 按 Key 快速查。 用于缓存、会话存储、特征仓库。
- 文档存储 (MongoDB、Firestore):存类 JSON 文档。 Schema 灵活 (每个文档字段可以不同). 用于用户档案、商品目录、配置。
- 列族存储 (Cassandra、HBase):为写多和时间序列优化。 用于事件日志、指标、分析。
- 图数据库 (Neo4j):存节点和边。 为遍历查询优化。 用于社交网络、知识图谱、推荐系统。
- 向量数据库 (Pinecone、Milvus、Weaviate、FAISS):存高维嵌入并支持近似最近邻 (Approximate Nearest Neighbor, ANN) 检索。 是语义搜索、检索增强生成 (Retrieval-Augmented Generation, RAG) 和推荐系统的必需品。
CAP 定理
-
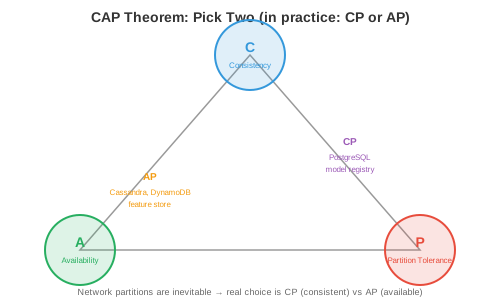
在分布式数据库里,以下三个属性你最多同时拥有两个:
- 一致性 (Consistency):每次读都拿到最新的写。
- 可用性 (Availability):每个请求都收到响应 (即使有些节点挂了).
- 分区容忍性 (Partition tolerance):网络分区 (节点之间通信中断) 时系统仍能工作。
-
由于分布式系统中网络分区不可避免,真正的选择是 CP (一致,但分区时可能不可用 —— 例如 PostgreSQL) vs AP (可用,但分区时可能返回旧数据 —— 例如 Cassandra、DynamoDB).
-
ML 场景:特征仓库一般选 AP (稍旧的特征值好过没预测). 模型仓库选 CP (发错模型版本是灾难性的).
分片
-
分片 (sharding) 把数据库切分到多台机器。 每个分片存一部分数据。
-
哈希分片 (hash sharding):对键做哈希决定分片。
shard = hash(user_id) % num_shards. 分布均匀,但范围查询做不了。 -
范围分片 (range sharding):每个分片存一段键范围 (A-G 在分片 1, H-N 在分片 2). 支持范围查询,但可能出热点 (比如很多用户名字都以 "S" 开头).
-
重分片问题 (resharding problem):加一个分片会让哈希映射全失效。 一致性哈希 (consistent hashing) 把数据搬移量降到最小:加第 n 个分片时只需搬约 1/n 的键。
数据库索引
-
索引 (index) 是一种数据结构,用额外存储和更慢的写换取更快的查。 没索引,一次查询要扫全表 (O(n)). 有索引,只要 O(log n) 就能找到。
-
B 树索引 (B-tree index) (默认):一棵平衡树 (第 13、14 章),每个节点存多个键和指针。 B 树对缓存友好 (宽节点正好塞进缓存行),支持范围查询 (
WHERE age BETWEEN 20 AND 30). 大多数 SQL 数据库用 B 树。 -
哈希索引 (hash index):用哈希函数把键映射到行位置。 查询是 \(O(1)\),但不支持范围查询。 用于精确匹配查询 (
WHERE id = 12345). -
组合索引 (composite index):在多列上建的索引。
CREATE INDEX ON users(country, city)能加速按 country 或按 country + city 过滤的查询,但不能加速只按 city 过滤 (查询里必须命中最左列). -
权衡:每个索引都加速读,但拖慢写 (每次 insert/update/delete 都要维护索引),也占存储 (每个索引大约是表大小的 10-30%). 别啥都建索引 —— 只给你频繁查询的列建。
-
ML 系统里:特征仓库的在线数据库需要在实体键 (user_id、item_id) 上建索引,才能快速取特征。 实验追踪数据库需要在 (experiment_id, metric_name) 上建索引,支撑仪表盘查询。
API 设计
-
系统之间通过 API 通信。 好的 API 设计让系统好用、好演进、好排障:
-
REST 约定:用名词表示资源 (
/users、/models),用 HTTP 方法表示动作 (GET = 读,POST = 建,PUT = 改,DELETE = 删),用状态码表示结果 (200 = OK, 201 = 已创建,400 = 请求非法,404 = 未找到,429 = 被限流,500 = 服务端错). -
分页 (pagination):返回列表的接口,永远不要一次全返回。 用游标分页 (
GET /items?cursor=abc&limit=50) 或偏移分页 (GET /items?offset=100&limit=50). 数据量大时游标更高效 (偏移分页需要跳过前面的行). -
版本管理 (versioning): API 路径前面加版本号 (
/v1/predict、/v2/predict). 这样能演进 API 而不打死老客户端。 客户端按自己节奏迁到 v2; v1 标记为 deprecated,但要等流量降下来才真正下线。 -
错误响应 (error responses):返回结构化错误,信息够用来排障:
{
    "error": {
        "code": "INVALID_INPUT",
        "message": "Feature 'user_age' must be a positive integer",
        "details": {"field": "user_age", "value": -5}
    }
}
消息队列
-
消息队列 (message queue) 把生产者 (生成任务的服务) 和消费者 (处理任务的服务) 解耦。 生产者把消息发到队列;消费者准备好后从队列拉。
-
为什么要用队列:没队列的时候,消费者慢了或挂了,生产者就得阻塞。 有队列后,生产者发完就走,队列把消息暂存,消费者准备好再取。
-
Apache Kafka:分布式、持久化、高吞吐的消息队列。 消息存在主题 (topic) 里,每个 topic 切成多个 partition 分布在多个 broker 上。 消费者从 partition 读,各自记录读到哪 (offset). Kafka 保证同一 partition 内的顺序,也能重放消息 (日志是持久化的).
-
发布/订阅 (pub/sub):发布者把消息发到 topic;该 topic 的所有订阅者都会收到一份拷贝。 用于事件驱动架构:"一个新模型已上线"这个事件,会同时触发监控服务、A/B 测试服务和日志服务。
-
用在 ML 上:一个预测请求走 HTTP 进来,落到 Kafka 队列,由 GPU worker 处理,结果通过回调或 WebSocket 返回。 队列吸收流量突刺,GPU worker 崩掉时也不丢请求。
一致性模型
-
分布式系统里,不同节点对数据可能有不同视图。 一致性模型 (consistency model) 定义系统给出什么样的保证:
-
强一致性 (strong consistency):写完之后,所有后续读 (从任意节点) 都能看到新值。 好想清楚,但慢 (需要节点间协调).
-
最终一致性 (eventual consistency):写完之后,一段时间内读可能拿到旧值,但最终会看到新值。 快 (不用协调),但应用得自己处理旧数据。
-
因果一致性 (causal consistency):如果操作 A 因果先于 B (比如"写 X 然后读 X"),系统保证 B 能看到 A 的结果。 但无关操作可以以任意顺序被观察到。
-
读己之写 (read-your-writes):用户永远立刻看到自己刚写的东西,哪怕别人还看到旧值。 大多数应用最起码需要这个。
韧性模式
-
限流 (rate limiting):限制每个用户在给定时间窗口内的请求数。 防滥用,保公平。 一般用 Redis 里的令牌桶或滑动窗口计数器实现。
-
熔断器 (circuit breaker):如果下游服务开始失败 (错误率超阈值),熔断器"打开",停止向它发请求 (立刻返回兜底响应). 超时后进入"半开",发一个试探请求。 试探成功就"关闭" (回到正常). 这样避免级联故障:特征仓库挂了,模型服务器返回不带特征的预测,而不是每个请求都超时。
-
背压 (backpressure):系统扛不住时,向上游发信号让它减速。 与其收下请求再失败,不如尽早拒绝多余请求 (返回 429 或 503). 客户端用指数退避重试。
-
指数退避重试 (retry with exponential backoff):请求失败,等 1 秒重试。 再失败等 2 秒。 然后 4、8、16…… 加抖动 (随机延迟),避免所有客户端同时重试 (即"雷鸣羊群"问题,thundering herd).
-
幂等性 (idempotency):一个操作是幂等的,意味着做两次和做一次效果一样。
PUT /user/123 {"name": "Alice"}是幂等的 (设两遍名字都是 Alice,没事).POST /payments不是 (支付两次就完蛋). 让操作幂等,才能安全地重试。
📌 本节要点
- 客户端-服务器:请求-响应同步模型,优先无状态设计以便水平扩展。
- 协议选型: HTTP 通用、WebSocket 实时流、gRPC 高性能内部通信。
- DNS:除域名解析外,还承担粗粒度负载均衡与地理路由,TTL 决定故障切换速度。
- 反向代理 / API 网关:集中处理 SSL 卸载、鉴权、限流、路由,ML 服务的入口。
- 负载均衡算法:轮询公平,最少连接适合长短不均的 LLM 请求,一致性哈希用于缓存/KV-cache 亲和。
- 缓存模式: Cache-aside 最主流;LRU/LFU/TTL 三种淘汰策略按场景选;LLM 场景命中率 20-40%.
- CAP 定理:分区必然发生,只能在 CP 与 AP 中二选一;特征仓库选 AP,模型仓库选 CP.
- 索引权衡: B 树支持范围查询、哈希索引只支持精确匹配,索引加速读但拖慢写。
- 消息队列: Kafka 用 topic + partition + offset 保证同分区有序与可重放,用于解耦与削峰。
- 韧性四件套:限流、熔断、背压、指数退避重试;让操作幂等才敢重试。