扩展与部署
一句话总结:把大模型服务给百万用户,靠的是多卡并行、投机解码、前缀缓存、成熟框架与精细监控,每一个百分点的效率都直接换成千万美元的账单。
把大模型服务给数百万用户,需要跨多块 GPU 分布式推理、在需要之前就预测好 token、缓存共享的上下文,并挑对框架。 本节覆盖推理时的并行、投机解码、前缀缓存、推理框架、成本优化与监控.
- 一块 H100 GPU (Graphics Processing Unit, GPU) 服务一个 70B 模型,大概能以交互延迟撑住 100 个并发用户。 要服务 1000 万用户,就得 100000 块 GPU —— 每年云端算力开销约 30 亿美元。 每提升一个百分点的效率,就省下几千万美元。 这就是为什么推理优化不是纸上谈兵:它直接决定了 AI 产品的经济账。
推理时的模型并行
- 当模型大到单块 GPU 装不下时,就必须把它拆到多块 GPU 上。 训练阶段 (第 6 章) 的并行策略在推理时同样适用,只是权衡点不一样。
张量并行
- 张量并行 (tensor parallelism, Megatron 风格,见第 6 章) 把单个权重矩阵切分到多块 GPU 上。 对一个线性层 \(Y = XW\),权重矩阵 \(W\) 按列切分到 \(N\) 块 GPU 上。 每块 GPU 算一个部分结果,然后一次 all-reduce 把它们聚合起来:
-
推理时,张量并行是"模型放不下单卡"场景的默认解。 一个 FP16 精度的 70B 模型需要 140 GB —— 用张量并行拆到 2 块 80 GB 的 GPU 上就行。
-
延迟影响:张量并行每一层都要多做一次 all-reduce 通信。 在 NVLink (900 GB/s) 上,这大约每层加 0.1 ms. 在 PCIe (32 GB/s) 上,每层加 3 ms. 一个 80 层的 70B 模型放在 2 块 GPU 上:NVLink 总共加 8 ms, PCIe 加 240 ms. 这就是 NVLink 对多卡推理为什么举足轻重的原因。
流水线并行
-
流水线并行 (pipeline parallelism) 把不同的层分给不同的 GPU. GPU 1 负责 0-39 层,GPU 2 负责 40-79 层。 token 顺着流水线依次流过。
-
推理时,流水线并行的延迟比张量并行更高 (每个 token 都得走完整条流水线),但通信开销更低 (GPU 之间只传激活值,不需要 all-reduce). 当 GPU 之间是慢速互联 (跨节点、没有 NVLink) 时,更倾向于用它。
序列并行
-
对超长序列来说,即便模型能塞进单卡,KV 缓存 (KV cache) 本身也可能装不下。 序列并行 (sequence parallelism) 把 KV 缓存分片到多块 GPU 上:每块 GPU 只保存序列中缓存的一部分键与值。
-
计算注意力时,每块 GPU 在自己那段缓存上算部分注意力分数,然后做一次 reduction 把结果合起来。 长上下文推理 (128K+ token) 里,KV 缓存超出单卡内存时,就会用这招。
投机解码
- 投机解码 (speculative decoding) 是最有影响力的大语言模型 (Large Language Model, LLM) 推理优化之一。 洞察点在于:解码之所以慢,是因为它一次只能生成一个 token,每个 token 都要走一遍大模型的完整前向传播。 但一个小模型可以生成候选 token 快得多,而大模型可以并行地验证多个候选。
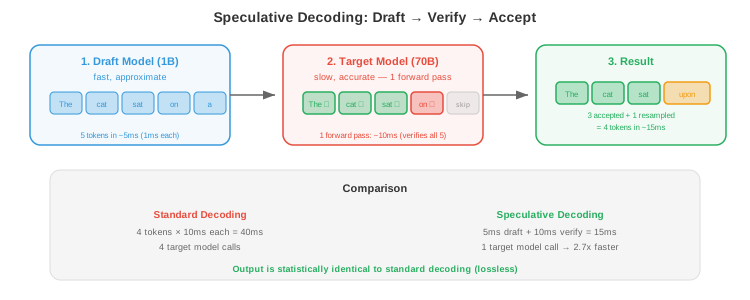
- 算法:
- 一个 draft 模型 (小而快 —— 例如 1B 参数) 自回归地生成 \(k\) 个候选 token.
- 目标模型 (大而准 —— 例如 70B) 对整段候选序列做一次前向,算出每个候选 token 的概率。
- 目标模型认可的候选就接受 (它给这个 token 的概率足够高). 被拒绝的候选则从目标模型的分布中重新采样。
- 平均下来,每一次验证能接受多个 token,加速比正比于接受率。
-
为什么它无损:拒绝采样方案保证输出分布与目标模型完全一致。 投机解码是无损的 —— 输出在统计上与"单跑目标模型"没有区别,只是更快。
-
变体:
- Medusa (Cai et al., 2024):不用独立的 draft 模型,而是在目标模型上加几个轻量"头",同时预测未来的多个 token. 不需要额外模型。
- EAGLE (Li et al., 2024):训练一个轻量 draft 头,利用目标模型的隐藏状态来预测未来 token. 接受率比独立 draft 模型更高。
- 自投机解码 (self-speculative decoding):目标模型自己用早退 (early exit) 生成 draft (只跑前几层做 draft,再用完整模型验证).
- 并行解码:并行生成多条候选延续 (候选构成一棵树),一次验证整棵树。 吞吐更高,但分叉的 KV 缓存占用更多显存。
前缀缓存
-
很多请求共享相同前缀:系统提示词、少样本示例、或常见的查询模式。 前缀缓存 (prefix caching) 把这些前缀的 KV 缓存存下来,让不同请求复用。
-
系统提示词缓存:如果每个请求都以同一段 2000 token 的系统提示词开头,那这 2000 token 的 KV 缓存只需算一次,所有请求共享。 对一个 80 层的 70B 模型,这样每个请求能省下约 200 MB.
-
基数树缓存 (radix tree caching, SGLang):把缓存的前缀组织成一棵基数树 (trie). 新请求来时,找出最长匹配的缓存前缀,从那里开始生成,跳过匹配前缀的计算。
-
影响:对于长共享前缀的应用 (带系统提示词的聊天机器人、共享检索段落的检索增强生成 (Retrieval-Augmented Generation, RAG)),前缀缓存能把首 token 延迟 (Time To First Token, TTFT) 降低 50-90%, GPU 算力也按比例节省。
KV 缓存驱逐
-
除了量化 KV 缓存 (见第 01 节) 与用 GQA/MLA 缩小 KV 缓存 (见第 02 节) 之外,KV 缓存驱逐 (KV-cache eviction) 策略会主动把那些将来不太可能被关注到的缓存 token 剔除掉。
-
H2O (Heavy-Hitter Oracle, Zhang et al., 2023) 观察到注意力分数呈幂律分布:一小部分 token ("重头戏") 拿走了大部分注意力,而绝大多数 token 拿到的注意力可以忽略不计。 H2O 保留:
- 最近的 token (最近 \(w\) 个 token 的滑动窗口,类似 StreamingLLM).
- 重头戏 token (按过去所有解码步骤累计注意力分数排前 \(k\) 的 token).
-
既不最近、也不是重头戏的 token 被驱逐。 这样能维持一个固定大小的 KV 缓存,同时保住那些真正影响生成的 token. H2O 只用 20% 的显存,就能达到接近完整 KV 缓存的质量。
-
Scissorhands (Liu et al., 2023) 走的是类似路线,但用了更精细的重要性指标:当前这一步拿到高注意力的 token 保留,而连续 \(T\) 步都没被关注到的 token 被驱逐。 这让它能适应生成过程中不断变化的注意力模式。
-
动态驱逐 + StreamingLLM:把注意力锚点 (永久保留最前面几个 token) 和动态驱逐 (保留最近 + 重头戏 token) 结合起来。 这是超长生成场景下最省显存的做法,能在质量下降可控的前提下实现"无限长"生成。
-
所有驱逐方法共同的洞察:LLM 注意力在实际中是稀疏的 —— 尽管架构会对所有缓存 token 计算注意力,但实际的注意力权重集中在一小撮子集上。 剔除其余 token 对输出质量影响很小。
推理框架
- LLM 服务生态已经收敛到几个主流框架:
| 框架 | 强项 | 最适合 |
|---|---|---|
| vLLM | PagedAttention、连续批处理、高吞吐 | 通用 LLM 服务,最高吞吐 |
| TensorRT-LLM | NVIDIA 定制内核、FP8、in-flight 批处理 | 榨干 NVIDIA GPU 性能 |
| SGLang | 前缀缓存 (RadixAttention)、快速结构化生成 | 共享前缀应用、受限输出 |
| llama.cpp | CPU/Metal/CUDA/Vulkan、GGUF 量化、可移植 | 消费级硬件、端上推理 |
| TGI (HuggingFace) | 简单 API (Application Programming Interface, API)、部署便利、Model Hub 集成 | 快速部署、HuggingFace 生态 |
| Ollama | 一条命令下载并服务模型 | 个人使用、本地开发 |
| ExLlamaV2 | 极致量化优化 (EXL2 格式) | 显存受限的 GPU 推理 |
-
vLLM 是生产环境 LLM 服务的默认选择。 它支持连续批处理、PagedAttention、张量并行、投机解码、LoRA (Low-Rank Adaptation, LoRA) 服务,以及大多数开源模型。
-
TensorRT-LLM 在 NVIDIA 硬件上跑出最高的原始性能 (同 GPU 下比 vLLM 快 10-30%),但灵活性差、定制难度大。
-
SGLang 在结构化输出应用 (JSON、特定格式的代码) 或共享前缀场景下最出彩,得益于它的基数注意力缓存与受限解码引擎。
成本优化
-
在大规模下,推理成本占据了 ML 预算的大头。 降本策略:
-
合适规格的 GPU 选择:不是所有模型都需要 H100. 量化过的 7B 模型在 A10G (~\(1/小时) 上就跑得不错, 不用 H100 (~\)8/小时). 让 GPU 匹配负载。
-
抢占式实例 (spot instances):云厂商以 60-90% 折扣卖没用完的 GPU 容量 (AWS Spot、GCP Preemptible). 抢占式实例随时可能被回收,所以适合批量推理,不适合延迟敏感的服务。 配合抢占处理 (保存状态、在新实例上恢复),抢占式实例也能服务交互流量。
-
自动扩缩容 (autoscaling):根据流量伸缩 GPU 数量。 高峰扩容,夜间缩容。 Kubernetes HPA (Horizontal Pod Autoscaler) 或云原生自动扩缩 (AWS SageMaker、GCP Vertex AI) 能搞定这事。
-
批处理 + 利用率: 30% 与 90% GPU 利用率之间,单 token 成本差 3 倍。 连续批处理、智能调度、PagedAttention 都能提升利用率。
-
量化: INT4 相对 FP16 少用 4 倍显存 → 能塞进更小的 GPU → 成本降 2-4 倍。 加上更多请求能塞进同一个批次 → 吞吐更高 → 单 token 成本更低。
-
单 token 成本基准 (估算,2026 年):
| 配置 | 每 100 万 token 成本 |
|---|---|
| GPT-4o API | $2.50 |
| Claude 3.5 Sonnet API | $3.00 |
| Llama-70B on H100 (vLLM, FP16) | $0.50 |
| Llama-70B on H100 (TRT-LLM, INT8) | $0.25 |
| Llama-8B on A10G (vLLM, INT4) | $0.05 |
| Llama-3B on-device (llama.cpp) | $0 (硬件成本已摊销) |
监控
-
生产推理需要持续监控,在用户受影响之前抓到性能退化:
-
延迟监控:跟踪 TTFT 与每输出 token 时延 (Time Per Output Token, TPOT) 在 p50、p95、p99 上的表现。 p99 超过 SLO (服务等级目标) 就告警。 p99 突刺通常意味着:KV 缓存显存压力 (抖动)、某个长请求霸占了批次,或 GPU 温度过高在降频。
-
吞吐监控:跟踪每 GPU 每秒 token 数。 一下降通常意味着:批次效率下降 (太多短请求 → 批次利用率低)、序列变长 (每请求 KV 缓存占更多显存),或硬件问题 (GPU 进入 ECC 纠错模式,变慢).
-
GPU 利用率:跟踪流式多处理器 (SM) 占用、显存利用率、显存带宽。 SM 占用低 + 显存利用高 = 内存受限 (需要更大带宽或量化). SM 占用高 + 显存利用低 = 计算受限 (需要更多 FLOPS 或换更小模型).
-
模型质量监控:跟踪单请求指标 (响应长度、留出集上的困惑度、用户反馈信号). 模型质量退化可能来自:数据漂移 (进入的请求分布变了)、KV 缓存量化误差在长对话中累积,或服务流水线里的 bug.
-
成本监控:按模型、按 GPU 类型跟踪单 token 成本。 如果成本上升但吞吐没变,就要去查效率退化 (新模型版本显存占用变高、批次配置不佳,或 GPU 没用满).
-
工具: Prometheus + Grafana (第 15 章) 做基础设施指标,vLLM/TRT-LLM 自带的指标端点,加上模型层的自定义日志。
编程任务 (用 CoLab 或 notebook)
-
模拟投机解码。 用一个快的 "draft" 函数和一个慢的 "target" 函数,测出一次生成并验证多个 token 的加速效果。
import random import time def target_model(tokens): """慢但准确的模型. 返回每个候选 token 的概率.""" time.sleep(0.01) # 模拟每次前向 10ms # 模拟场景: 偶数 token 被接受 return [0.9 if t % 2 == 0 else 0.1 for t in tokens] def draft_model(): """快但近似的模型. 生成一个候选 token.""" time.sleep(0.001) # 模拟每 token 1ms return random.randint(0, 9) def standard_decoding(n_tokens): """用目标模型一次一个地生成 token.""" tokens = [] for _ in range(n_tokens): time.sleep(0.01) # 目标模型生成 1 个 token tokens.append(random.randint(0, 9)) return tokens def speculative_decoding(n_tokens, k=4): """生成 k 个 draft token, 用目标模型验证, 接受或拒绝.""" tokens = [] total_target_calls = 0 while len(tokens) < n_tokens: # Draft: 快速生成 k 个候选 candidates = [draft_model() for _ in range(k)] # 验证: 一次目标模型调用处理全部 k 个候选 probs = target_model(candidates) total_target_calls += 1 # 一直接受, 直到有一个被拒绝 for i, (tok, prob) in enumerate(zip(candidates, probs)): if random.random() < prob: tokens.append(tok) if len(tokens) >= n_tokens: break else: # 从目标分布重新采样 tokens.append(tok + 1) # 简化的重采样 break return tokens, total_target_calls n = 50 start = time.time() _ = standard_decoding(n) standard_time = time.time() - start start = time.time() _, target_calls = speculative_decoding(n, k=5) spec_time = time.time() - start print(f"Standard: {standard_time:.2f}s ({n} target calls)") print(f"Speculative: {spec_time:.2f}s ({target_calls} target calls)") print(f"Speedup: {standard_time / spec_time:.1f}x") -
估算不同优化策略应用到 LLM 服务部署时的成本节省。
def serving_cost_analysis(
    model_name, params_B, precision_bits,
    gpu_name, gpu_mem_gb, gpu_cost_per_hr,
    target_throughput_tps,
):
    """估算 LLM 部署的服务成本."""
    model_size_gb = params_B * 1e9 * precision_bits / 8 / 1e9
    gpus_for_model = max(1, int((model_size_gb * 1.2) / gpu_mem_gb + 0.99))  # 1.2x 留给 KV 缓存

    # 粗略吞吐估算 (显存带宽受限)
    tokens_per_gpu = 500 / (params_B * precision_bits / 16)  # 以 7B FP16 下 500 tok/s 归一化
    total_throughput = tokens_per_gpu * gpus_for_model

    replicas = max(1, int(target_throughput_tps / total_throughput + 0.99))
    total_gpus = gpus_for_model * replicas
    cost_per_hr = total_gpus * gpu_cost_per_hr
    cost_per_1M_tokens = cost_per_hr / (total_throughput * replicas * 3600 / 1e6)

    print(f"{model_name} @ {precision_bits}-bit on {gpu_name}:")
    print(f"  Model size: {model_size_gb:.0f} GB → {gpus_for_model} GPU(s)/replica")
    print(f"  Throughput: {total_throughput:.0f} tok/s/replica")
    print(f"  Replicas for {target_throughput_tps} tok/s: {replicas}")
    print(f"  Total GPUs: {total_gpus}")
    print(f"  Cost: ${cost_per_hr:.0f}/hr, ${cost_per_1M_tokens:.2f}/1M tokens")
    print()

print("=== Cost Comparison ===\n")

# 基线: H100 上的 FP16
serving_cost_analysis("Llama-70B", 70, 16, "H100", 80, 8.0, 1000)

# 量化: H100 上的 INT8
serving_cost_analysis("Llama-70B", 70, 8, "H100", 80, 8.0, 1000)

# 量化: A100 上的 INT4
serving_cost_analysis("Llama-70B", 70, 4, "A100", 80, 4.0, 1000)

# 更小模型: A10G 上的 8B
serving_cost_analysis("Llama-8B", 8, 4, "A10G", 24, 1.0, 1000)
📌 本节要点
- 张量并行:按列切权重矩阵,每层一次 all-reduce, NVLink 上开销小、PCIe 上代价重。
- 流水线并行:按层切分,通信更省但每 token 要走完全流水线,适合跨节点慢互联。
- 序列并行:把 KV 缓存分片,用于 128K+ 上下文单卡装不下 KV 缓存的场景。
- 投机解码:用 draft 小模型生成候选,目标大模型并行验证,无损换 2-3 倍加速。
- Medusa / EAGLE / 自投机 / 并行解码:投机解码的主流变体,分别去掉独立 draft、用隐藏态、早退或候选树。
- 前缀缓存:复用共享前缀的 KV 缓存,SGLang 的基数树能把 TTFT 砍 50-90%.
- KV 缓存驱逐: H2O、Scissorhands、StreamingLLM 利用注意力稀疏,用 20% 显存保住接近满 KV 的质量。
- 框架矩阵: vLLM 通用最高吞吐,TensorRT-LLM 榨 NVIDIA 极限,SGLang 前缀共享,llama.cpp 端上,Ollama 本地。
- 成本杠杆:选对 GPU、Spot、自动扩缩、批处理利用率、量化,组合起来能把单 token 成本压 10 倍以上。
- 监控四维:延迟 (p50/p95/p99)、吞吐、GPU 利用率、模型质量与成本,各自对应不同的退化根因。