文本到语音与声音
一句话总结:文本到语音 (Text-to-Speech, TTS) 把文字合成成自然语音,现代神经 TTS 沿"文本归一化 → 音素 → 声学模型 → 声码器"四段流水线展开,又被 Tacotron / FastSpeech / VITS / WaveNet / HiFi-GAN / 编解码语言模型 (VALL-E) 等架构推向近人类自然度。
文本到语音合成把 ASR 流水线反过来跑,从书面文本生成自然的语音。本节覆盖 TTS 流水线 (文本归一化、字素到音素、声学模型、声码器)、Tacotron、WaveNet、HiFi-GAN、声音克隆、声音转换以及语音活动检测 (Voice Activity Detection, VAD)。
-
在第 01 节里,我们搭好了信号处理的工具箱:波形、频谱图、梅尔滤波器组、梅尔频率倒谱系数 (Mel-Frequency Cepstral Coefficients, MFCC)。第 02 节里,我们把语音转成了文字。现在把箭头反过来:给定一段文本,合成自然听感的语音。这就是 文本到语音 (Text-to-Speech, TTS),顺带打开了通往声音转换 (voice conversion)、声音克隆 (voice cloning) 和语音活动检测的大门。
-
把 TTS 想成一场舞台演出。剧本是输入文本。导演 (声学模型) 决定每一句怎么念——音高、时长、重音。乐队 (声码器) 再按谱演奏,生成观众真正听到的声波。现代神经 TTS 抛掉了规则系统那种僵硬的机器人腔,演出水准已经可以和真人对飙。
-
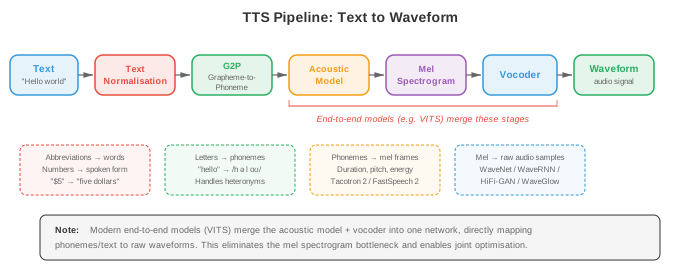
文本到语音流水线:标准 TTS 流水线有四步——(1) 文本归一化 (text normalisation), (2) 音素转换 (phoneme conversion), (3) 声学模型 (acoustic model), (4) 声码器 (vocoder)。有些现代系统把第 3、4 步合成一个端到端模型,但概念上分开看依然清晰好用。
-
文本归一化 把原始文本转成可发音的形式。缩写要展开 ("Dr." → "Doctor"),数字变单词 ("1984" → "nineteen eighty-four"),货币符号要念出来 ("$5" → "five dollars"), URL 和特殊字符也要处理。这一步通常用带语言特定语法的规则系统,也存在神经归一化模型。这里出的错会一路传到下游:如果 "St." 被读成 "saint" 而不是 "street",整句都毁了。
-
字素到音素转换 (Grapheme-to-Phoneme, G2P) 把归一化后的文本映射成音素序列。英语出了名的不规律 ("though"、"through"、"tough" 里的 "ough" 发音都不同),所以常见词走词典查找 (如 CMU 发音词典),未登录词交给神经序列到序列模型处理 (第 06 章的编码器-解码器,或第 07 章的 Transformer)。拼写规则浅的语言 (西班牙语、芬兰语) 用更简单的 G2P 就够。输出通常是国际音标 (International Phonetic Alphabet, IPA) 序列,或等价的内部音素集。
-
声学模型 吃进音素序列,吐出一个中间声学表示,几乎清一色是 梅尔频谱图 (mel-spectrogram) (见第 01 节)。梅尔频谱图刻画每一帧上的频谱包络,编码了声码器重建波形所需的感知相关信息。声学模型要决定时长 (每个音素持续多久)、音高 (基频 \(F_0\)) 和能量 (响度)。
-
声码器 吃进梅尔频谱图,输出原始音频波形。这本质是一个不适定的反演问题:同一张频谱图对应多种波形,因为相位信息被丢掉了。传统声码器 (Griffin-Lim、WORLD) 用迭代法或信号模型,但如今神经声码器在音质上已占主导。
-
声码器:WaveNet (van den Oord et al., 2016) 是第一个能合成到几乎听不出是机器的神经声码器。它对波形做自回归建模,每个采样点 \(x_t\) 都以之前所有采样点为条件预测:
-
其中 \(c\) 是条件信号 (梅尔频谱图)。每个采样点是 16 位,直接在 65536 个值上做 softmax 不现实。WaveNet 用 mu-law 压扩 (mu-law companding) 把量化级数降到 256,后来的变体则用 logistic 分布的混合。
-
WaveNet 的核心构件是 膨胀因果卷积 (dilated causal convolution)。因果 (causal) 意味着滤波器权重只看过去的采样点 (不泄露未来)。膨胀 (dilated) 意味着滤波器跳着采样,间隔指数级增大:膨胀因子 \(1, 2, 4, 8, \ldots, 512\)。这样感受野呈指数级增长,参数量却只线性上升。
-
每一层的门控激活是:
-
其中 \(W_f\)、\(W_g\) 分别是滤波器与门控卷积权重,\(\ast\) 表示膨胀因果卷积,\(\odot\) 是逐元素乘。这一门控机制 (来自第 06 章的 LSTM) 让网络能控制信息流。
-
WaveNet 音质出众,但推理慢得让人绝望:生成 1 秒 24 kHz 音频要跑 24000 次串行前向。这直接催生了后来所有声码器研究。
-
WaveRNN (Kalchbrenner et al., 2018) 用一个单层循环网络替掉 WaveNet 的深层卷积栈。它把 16 位采样点拆成粗 (高 8 位) 和细 (低 8 位) 两个部分,各用一个 GRU 预测 (见第 06 章)。这种双 softmax 大幅降低计算量,同时保住高音质。经过精心的核优化,WaveRNN 甚至能在移动 CPU 上实时跑。
-
WaveGlow (Prenger et al., 2019) 是一种 基于流 (flow-based) 的声码器,完全避开自回归。它用一串可逆变换 (仿射耦合层,即第 06 章的归一化流) 把一个简单高斯分布映射到波形分布。训练时用变量替换公式最大化精确的对数似然:
-
其中 \(z = f(x)\) 是把 \(x\) 过一遍流得到的潜变量。推理时采样 \(z \sim \mathcal{N}(0, I)\),用逆流一次并行推过去。WaveGlow 用模型体积 (耦合层要大网络) 换生成速度。
-
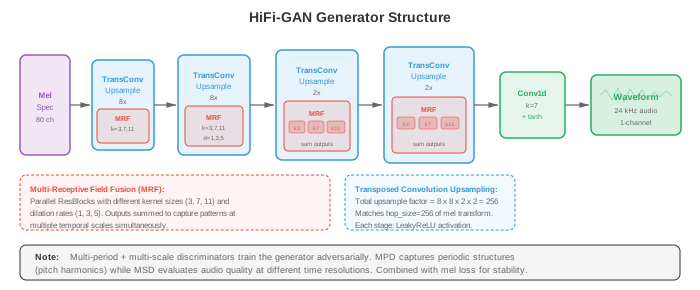
HiFi-GAN (Kong et al., 2020) 用 生成对抗网络 (Generative Adversarial Network, GAN) 从梅尔频谱图合成波形。生成器通过一串转置卷积把梅尔频谱图上采样,每层后接一个 多感受野融合 (Multi-Receptive Field fusion, MRF) 模块。MRF 模块并行跑多个卷积核大小和膨胀率不同的残差块,再把它们的输出加起来。这样生成器能同时抓住多种时间尺度上的模式。
-
HiFi-GAN 用两类判别器。多周期判别器 (Multi-Period Discriminator, MPD) 把 1D 波形按不同周期 (2, 3, 5, 7, 11) 折叠成 2D,再用 2D 卷积处理。这抓的是不同基频下的周期性结构。多尺度判别器 (Multi-Scale Discriminator, MSD) 直接在原始波形、2 倍下采样、4 倍下采样三个版本上做,抓不同时间分辨率下的模式。
-
训练目标结合了对抗损失、梅尔频谱重建损失 (合成音频与真值音频的梅尔频谱之间的 L1 距离),以及 特征匹配损失 (判别器中间层特征的 L1 距离):
-
HiFi-GAN 合成音质可比肩 WaveNet,速度却快 1000 倍以上,单卡 GPU 就能做到实时生成。
-
神经源-滤波器 (Neural Source-Filter, NSF) 模型 把传统信号处理和神经网络结合起来。在经典的源-滤波器模型里,浊音由源激励 (基频 \(F_0\) 上的周期性脉冲序列) 通过声道滤波器 (频谱包络) 产生。NSF 模型把手工滤波器换成神经网络,但保留了显式的源信号。输入的 \(F_0\) 轮廓给了细粒度的音高控制,而纯数据驱动的声码器有时在这一点上打不准。
-
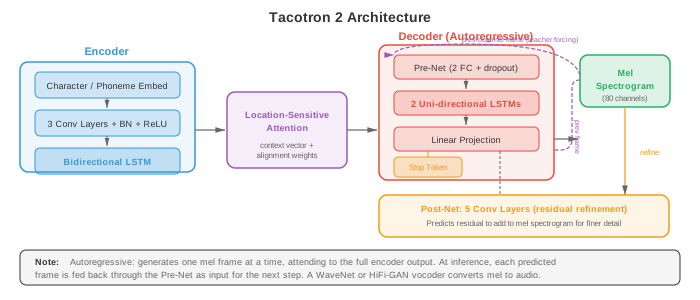
声学模型:Tacotron (Wang et al., 2017) 是第一个端到端的神经 TTS 系统,直接把字符序列转成梅尔频谱图。它用带注意力的编码器-解码器架构 (第 07 章)。编码器用一个卷积组 (convolution bank)、高速公路网络 (highway network) 和双向 GRU 处理字符 / 音素序列。解码器是一个自回归 GRU,每次预测一帧梅尔,输入是上一帧和注意力上下文。
-
Tacotron 2 (Shen et al., 2018) 把架构做了大幅精简与优化。编码器是 3 层 1D 卷积栈接一个双向 LSTM (第 06 章)。解码器是一个 2 层 LSTM,用 位置敏感注意力 (location-sensitive attention),它不仅按编码器输出和解码器状态计算注意力,还额外条件于之前所有步骤的累计注意力权重。这样能防住注意力"跳字 / 重复字"这种常见故障。
- 位置敏感注意力在解码步 \(i\)、编码位置 \(j\) 上的能量为:
-
其中 \(s_{i-1}\) 是上一步解码器状态,\(h_j\) 是编码器在位置 \(j\) 的输出,\(f_{i,j}\) 是位置特征,由累计注意力权重 \(\sum_{k<i} \alpha_{k,j}\) 与一个 1D 卷积核卷积得到。注意力权重为 \(\alpha_{i,j} = \text{softmax}(e_{i,j})\)。
-
Tacotron 2 的解码器还在每一步预测一个 停止 token (stop token) 概率,用来判断梅尔频谱图是否已经写完。输出的梅尔频谱图再交给声码器 (原论文用 WaveNet,后来常换成 HiFi-GAN 之类)。
-
Tacotron 2 的自回归本性意味着合成速度受帧数限制。以每秒 80 帧的典型梅尔频谱图为例,一段 5 秒的语音要跑 400 次串行解码。
-
FastSpeech (Ren et al., 2019) 用 非自回归 (non-autoregressive) 声学模型解决了速度问题。它不再一帧一帧生成,而是并行生成所有帧。关键难点是:每个音素该对应多少帧梅尔?FastSpeech 用 时长预测器 (duration predictor) 搞定。
-
时长预测器是个小卷积网络,输入音素嵌入,输出每个音素的整数时长 (帧数)。训练时,真值时长由一个预训练好的自回归教师模型 (Tacotron 2) 的注意力对齐提取。推理时,用预测的时长通过 长度调节器 (length regulator) 把音素级隐状态扩展到帧级——就是把每个音素的隐向量重复所预测的帧数。
-
FastSpeech 2 (Ren et al., 2021) 在 FastSpeech 基础上砍掉了师徒蒸馏。它直接用强制对齐 (来自第 02 节的声学模型框架) 抽取真值时长,并在时长之外再加上音高 (\(F_0\)) 和能量的 方差适配器 (variance adaptor)。每个适配器都是一个小型卷积预测器,其输出条件化解码器:
-
其中 \(h_i\) 是音素 \(i\) 的编码器隐状态。训练时用真值,推理时用预测值——这就把韵律的显式控制交到了用户手里。可控性是 FastSpeech 2 的一大优势:想调音高、语速、能量?直接缩放预测器的输出就行。
-
FastSpeech 2 的推理通常比 Tacotron 2 快 10-20 倍,而且避开了自回归系统常见的坑——跳词、重复、注意力崩塌。
-
VITS (Kim et al., 2021) 是一个 端到端 (end-to-end) TTS 模型,从文本直接生成波形,把独立的声码器阶段整个吃掉。VITS 把条件变分自编码器 (第 06 章)、归一化流和对抗训练拼在一起。后验编码器把真值梅尔频谱图映射到潜空间;先验编码器把音素 (经 Transformer 文本编码器 + 时长预测器) 映射到同一潜空间;解码器 (基于 HiFi-GAN) 从潜样本生成波形。
-
VITS 的训练目标由四部分组成:
- 重建损失 (reconstruction loss): VAE 强迫潜分布编码声学信息
- KL 散度 (KL divergence):让文本条件先验对齐音频条件后验
- 对抗损失 (adversarial loss):判别器把关波形质量
- 时长损失 (duration loss):训练随机时长预测器
-
VITS 的音质高于两阶段系统 (FastSpeech 2 + HiFi-GAN),因为声学模型和声码器是联合优化的,避开了两阶段系统里"预测梅尔"和"真值梅尔"不匹配所带来的劣化。
-
VALL-E (Wang et al., 2023) 干脆把 TTS 重新定义成 在离散音频 token 上的语言建模问题 (language modelling problem)。它用一个神经音频编解码器 (EnCodec) 把语音表示成一串来自多个码本层的离散码。给定文本提示和一段 3 秒的注册语音 (也编码成离散 token), VALL-E 用 Transformer 语言模型自回归预测音频 token。
-
VALL-E 用了两个模型:一个 自回归 (AutoRegressive, AR) 模型逐 token 生成第一层码本;一个 非自回归 (Non-AutoRegressive, NAR) 模型以第一层为条件,并行预测剩余的码本层。这种编解码语言模型的路数带来了惊人的零样本声音克隆能力:只要 3 秒样本,就能复刻说话人的音色、嗓音,甚至情绪。
-
StyleTTS (Li et al., 2022) 和 StyleTTS 2 把语音解耦成内容和风格两部分。风格编码器从参考音频里抽出一个风格向量,捕捉说话人身份、韵律和录音条件。推理时,风格可以从学到的先验分布采样,也可以从参考语音迁移过来。StyleTTS 2 用扩散模型 (第 08 章) 做风格先验,生成的韵律既多样又自然。
-
Kokoro (2024) 是一个轻量、高质量的开源 TTS 模型,亮点在于体积小 (约 82M 参数) 却自然度惊人。它借鉴 StyleTTS 2 结构,配合基于扩散的风格先验和微调过的 ISTFTNet 声码器——后者直接预测短时傅里叶变换系数 (见第 01 节) 而不是原始波形采样。虽然只是 VALL-E 这类模型的零头,Kokoro 在英语、日语、法语、韩语和中文上都能做到接近人类的自然度,证明了精心筛选的训练数据 + 高效的架构设计完全可以和暴力堆规模掰手腕。Kokoro 体积小,特别适合本地和边缘部署。
-
Orpheus (Canopy Labs, 2025) 是一组开源 TTS 模型 (1B 和 3B 参数),建在 VALL-E 开创的 编解码语言模型 (codec language model) 范式上。Orpheus 把这一思路推得更远:用一个大语言模型骨干 (微调过的 Llama 3) 直接生成 SNAC 音频编解码 token。它的标志性能力是拟人化的情感表现力:笑、叹气、犹豫、情感韵律都处理得极为自然。Orpheus 支持在输入文本中插入
[laugh]或[sigh]之类的标签,对副语言表达 (paralinguistic expression) 做细粒度控制。 -
Dia (Nari Labs, 2025) 是一个开源对话 TTS 模型,从单段文本转录生成逼真的多说话人对话。它建在一个 1.6B 参数的编码器-解码器 Transformer 上,能处理轮换、说话人特定音色、以及对话中的非语言线索 (笑声、停顿)。它还支持从一小段音频提示做声音克隆,从而在对话上下文中实现零样本说话人生成。
-
Sesame CSM (Conversational Speech Model, 2025) 主打自然的多轮对话式语音。它不是奔着"朗读式"TTS 去的,而是建模真实对话的动态:插话反馈 ("uh huh")、打断、说话人之间的节奏切换,以及情绪回应。模型用 Transformer 骨干,条件于对话上下文 (文本 + 音频历史),让语音风格随对话流动自适应。
-
Fish Speech (Fish Audio, 2024) 是一个开源 TTS 系统,采用双自回归架构:一个大语言模型从文本生成语义 token,一个更小的模型把这些 token 转成 VQGAN 声学 token,再交给声码器解码成波形。Fish Speech 支持从 10-15 秒的参考做零样本声音克隆,延迟低到能用在实时应用里。它的模块化设计允许各组件 (比如声码器) 独立替换。
-
ChatTTS (2024) 是一个开源的对话 TTS 模型,面向聊天机器人和虚拟助手这类对话应用。它生成自然的、对话感的语音,并通过嵌在文本里的特殊 token 对韵律特征 (笑声、停顿、语气词) 做细粒度控制。ChatTTS 支持中英文混合合成和多说话人生成。
-
Bark (Suno, 2023) 是一个基于 Transformer 的开源模型,从文本提示生成语音、音乐和音效。它用三阶段 Transformer 流水线 (文本 → 语义 token → 粗声学 token → 细声学 token),支持声音克隆、多语种合成,以及音乐和环境音这类非语音音频。Bark 的通用性代价是可控性:它比专职 TTS 系统精准度低,但更灵活。
-
Parler-TTS (Hugging Face, 2024) 走的是 自然语言描述 (natural language description) 路线来做声音控制:不需要参考音频片段,用户直接给一段文本描述,例如"一个女性说话人,声音温暖、富有表现力,在安静的房间里"。Parler-TTS 是在标注了说话风格自然语言描述的语料上训的,让不带任何参考音频的直觉化控制成为可能。
-
Neuphonic 是一个基于 API 的 TTS 平台,专门为超低延迟语音合成优化,目标是实时语音智能体和对话式 AI 应用。它通过流式架构做到首音频时间在 100 ms 以下——文本还没输入完就开始生成音频。Neuphonic 主要卷的是部署和延迟优化层,而不是新架构本身,提供围绕现代神经 TTS 的生产级基础设施。
-
KittenTTS 是一个紧凑、高速的 TTS 模型,面向效率与低资源部署。它把最小延迟和小模型体积摆在第一位,为边缘和嵌入式应用服务,用一点自然度换 CPU 和移动设备上的实时性能。
-
现代 TTS 版图正在分裂成两大范式:(1) 编解码语言模型 (codec language models) (VALL-E, Orpheus, Fish Speech),把语音生成当作离散音频码上的下一个 token 预测,吃 LLM 的缩放红利;(2) 流 / 扩散模型 (flow/diffusion-based models) (VITS, StyleTTS 2, Kokoro),通过迭代细化生成连续的梅尔频谱图或波形。编解码语言模型胜在零样本克隆和表达力;流 / 扩散模型往往更小更快。两条路都在迅速逼近人类级自然度。
-
韵律建模 (prosody modelling) 控制语音的"音乐性":音高、时长、能量、节奏和语调。没有好的韵律,就算每个音素都清清楚楚,合成语音也会平板得像机器。把韵律想成"单调 GPS 导航"和"表现力十足的有声书朗读者"之间的区别。
-
音高 (pitch) 也就是基频 \(F_0\),是人耳感知的语音高低。它在问句末尾升起,在陈述句末尾降下,在情感语音中连续变化。\(F_0\) 可以用 CREPE (神经音高追踪器) 或 YIN (基于自相关,见第 01 节) 之类的算法从音频里抽取。TTS 里的音高要么由声学模型显式预测 (FastSpeech 2 的音高预测器),要么被隐式学出来 (Tacotron 2)。
-
时长 (duration) 决定语速和节奏。重读音节更长,功能词被缩短,停顿标出短语边界。非自回归模型 (FastSpeech) 显式建模时长,自回归模型 (Tacotron) 则由注意力对齐隐式决定时长。
-
能量 (energy) 也就是响度,承担重音。"I didn't say HE stole it" 和 "I didn't say he STOLE it" 表达的意思完全不同,靠的就是能量模式。
-
风格嵌入 (style embeddings) 抓的是更高层的韵律模式。全局风格 token (Global Style Token, GST) 框架 (Wang et al., 2018) 学一组风格 token (在一组学到的嵌入上做软注意力),用来表达"兴奋"、"悲伤"或"低语"等说话风格。风格嵌入从参考语音里抽出来,加到编码器输出上,允许推理时做风格迁移。
-
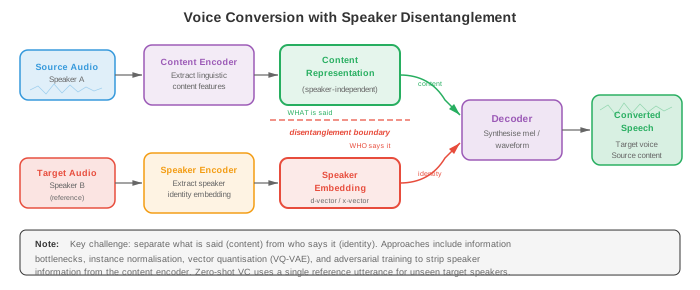
声音转换 (Voice Conversion, VC) 把一段语音的说话人身份换掉,但保留其中的语言内容。想象你录了一段自己的话,输出听起来就像某个特定的目标说话人。VC 要求把说话人身份和内容解耦开来。
-
说话人嵌入 (speaker embeddings) (第 04 节详述) 把说话人身份编码成一个固定维度的向量。它们可以来自一个预训练的说话人验证模型 (x-vectors, ECAPA-TDNN)。在 VC 里,源语音被编码成与说话人无关的内容表示,再拿目标说话人嵌入去解码。
-
解耦表示 (disentangled representations) 把语音拆成互相独立的因子:内容 (音素)、说话人身份、音高和节奏。常见做法有:
- 信息瓶颈 (information bottleneck):把内容表示压得极紧,让说话人信息塞不进去 (AutoVC)
- 对抗训练 (adversarial training):在内容表示上训一个说话人分类器,再用梯度反转去掉说话人信息
- 向量量化 (vector quantisation): VQ-VAE 让内容走离散瓶颈,天然剥离说话人身份 (因为码本条目代表音素类别,而不是说话人特征)
-
声音克隆 (voice cloning) 用目标说话人的声音合成语音。多说话人 TTS (multi-speaker TTS) 在多说话人数据上训练,用说话人嵌入条件化模型。推理时从注册音频中抽出新说话人的嵌入,用它条件化生成。
-
少样本声音克隆 (few-shot voice cloning) 用少量数据 (几分钟) 适配到一个新说话人。说话人编码器从注册音频抽嵌入,TTS 模型条件于该嵌入生成语音。SV2TTS (Jia et al., 2018) 就走这条路:单独训一个说话人编码器,一个条件于说话人嵌入的 Tacotron 2 合成器,加一个 WaveRNN 声码器。
-
零样本声音克隆 (zero-shot voice cloning) 完全不需要适配:一段短语音 (3-30 秒) 就够了。VALL-E 用把注册音频当作语言模型 prompt 的方式做到这一点。模型学会用同一嗓音继续生成,是因为它在大规模多说话人数据上训练时,一段语音内部嗓音一致本就是统计规律。
-
语音活动检测 (Voice Activity Detection, VAD) 回答一个简单的二分类问题:每一帧上,是不是有人在说话?别看简单,VAD 是 ASR (第 02 节)、说话人分离 (第 04 节) 和降噪 (第 05 节) 的关键预处理步骤。一个好的 VAD 能跳过静默段省算力,也能防止噪声被当成语音处理拉低精度。
-
传统 VAD 用能量阈值 (语音比静默响)、过零率 (语音有特征化的过零模式) 和频谱特征。这些方法在信噪比低的噪声环境里失灵。
-
神经 VAD (neural VAD) 模型把问题当作帧级二分类。一个小 RNN 或 CNN 吃声学特征 (第 01 节的对数梅尔能量),输出语音 / 非语音概率。
-
WebRTC VAD (Google) 是一个经典的轻量 VAD,在简单频谱特征上用基于 GMM 的分类器。它有四档激进等级 (0-3),快得离谱,但对音乐、非语音发声和低信噪比环境比较吃力。凭着零依赖的简单,它至今仍被广泛当作基线。
-
Silero VAD (Silero Team, 2021) 是生产环境里事实上的神经 VAD 标杆。它的架构是一小串深度可分离 1D 卷积 (第 08 章 MobileNet 思想用在音频上) 后接一层 LSTM 做时间上下文,最后一个线性头输出每帧的语音概率。整个模型不到 2MB (约 1M 参数),处理 30-100 ms 的音频块。
- 输入: 16 kHz 原始音频 (不用手工提特征——卷积前端直接从波形学自己的特征)。
- 窗口化有状态推理: LSTM 隐状态跨块保留,模型无需重跑历史就能处理流式音频。每次调用处理 30、60 或 100 ms 的块,返回一个 \([0, 1]\) 范围内的语音概率。
- 自适应阈值:不是单一固定阈值,Silero VAD 分开使用起始阈值和结束阈值,并配合最小语音 / 静默时长,防止在噪声边界上快速抖动。一段语音必须在起始阈值之上持续最短时间才能确认,静默必须在结束阈值之下持续足够时间才能收尾。
- 性能: Silero VAD 在 CPU 上以 1-2% 的实时因子运行 (处理 1 秒音频约 10-20 ms),非常适合边缘设备、手机和实时流水线。它在嘈杂 / 富含音乐的音频上明显优于 WebRTC VAD,又小到可以塞进设备端部署。
- Silero VAD 常被用作 Whisper (第 02 节) 的前端,把长音频切成一句一段再转写;也用于说话人分离流水线 (第 04 节),在抽取说话人嵌入之前先圈出语音区域。
-
声学活动检测 (Acoustic Activity Detection, AAD) 把 VAD 泛化到检测任何声学活动,不只是语音。这在智能家居设备、安防系统和野生动物监测中都很有用。AAD 模型检测玻璃碎裂、狗叫、警报声等事件,常用第 04 节介绍的音频分类框架。
-
TTS 的评估指标 既要衡量客观音质,也要衡量主观自然度:
- 平均意见分 (Mean Opinion Score, MOS):人类听众按 1-5 打分给自然度。金标准,但贵而慢。
- 梅尔倒谱失真 (Mel Cepstral Distortion, MCD):度量合成音频与参考音频梅尔倒谱之间的距离。越低越好,但和感知不总是同步。
- PESQ / POLQA:最初为电话语音设计的标准感知评估指标。
- 说话人相似度 (speaker similarity):合成音频和参考音频说话人嵌入之间的余弦相似度 (对声音克隆场景相关)。
- 可懂度 (intelligibility):把合成音频喂给一个 ASR 系统 (第 02 节),计算词错误率 (Word Error Rate, WER)。
Coding Tasks (use CoLab or notebook)
- 任务 1:用梅尔频谱图跑 Griffin-Lim 声码器。 实现 Griffin-Lim 迭代相位重建算法,把梅尔频谱图还原成波形。这个任务展示了声码器问题的本质,以及为什么需要神经声码器。
import jax
import jax.numpy as jnp
import matplotlib.pyplot as plt

# 生成合成波形 (谐波之和, 模拟一个元音)
sr = 16000
duration = 1.0
t = jnp.linspace(0, duration, int(sr * duration))
f0 = 220.0  # 基频
waveform = (
    0.6 * jnp.sin(2 * jnp.pi * f0 * t) +
    0.3 * jnp.sin(2 * jnp.pi * 2 * f0 * t) +
    0.1 * jnp.sin(2 * jnp.pi * 3 * f0 * t)
)

# 计算 STFT
n_fft = 1024
hop_length = 256
window = jnp.hanning(n_fft)

def stft(signal, n_fft, hop_length, window):
    """计算短时傅里叶变换。"""
    n_frames = 1 + (len(signal) - n_fft) // hop_length
    frames = jnp.stack([
        signal[i * hop_length : i * hop_length + n_fft] * window
        for i in range(n_frames)
    ])
    return jnp.fft.rfft(frames, n=n_fft)

def istft(stft_matrix, hop_length, window, length):
    """带重叠相加的逆 STFT。"""
    n_fft = (stft_matrix.shape[1] - 1) * 2
    n_frames = stft_matrix.shape[0]
    frames = jnp.fft.irfft(stft_matrix, n=n_fft)
    frames = frames * window[None, :]
    output = jnp.zeros(length)
    for i in range(n_frames):
        start = i * hop_length
        end = start + n_fft
        if end <= length:
            output = output.at[start:end].add(frames[i])
    return output

# 前向 STFT
S = stft(waveform, n_fft, hop_length, window)
magnitude = jnp.abs(S)

# 梅尔滤波器组
n_mels = 80
mel_low = 0.0
mel_high = 2595 * jnp.log10(1 + (sr / 2) / 700)
mel_points = jnp.linspace(mel_low, mel_high, n_mels + 2)
hz_points = 700 * (10 ** (mel_points / 2595) - 1)
freq_bins = jnp.floor((n_fft + 1) * hz_points / sr).astype(int)

mel_filterbank = jnp.zeros((n_mels, n_fft // 2 + 1))
for m in range(n_mels):
    f_left = freq_bins[m]
    f_center = freq_bins[m + 1]
    f_right = freq_bins[m + 2]
    for k in range(f_left, f_center):
        mel_filterbank = mel_filterbank.at[m, k].set(
            (k - f_left) / max(f_center - f_left, 1)
        )
    for k in range(f_center, f_right):
        mel_filterbank = mel_filterbank.at[m, k].set(
            (f_right - k) / max(f_right - f_center, 1)
        )

# 到梅尔域再回来 (伪逆)
mel_spec = magnitude @ mel_filterbank.T
magnitude_reconstructed = mel_spec @ jnp.linalg.pinv(mel_filterbank.T)
magnitude_reconstructed = jnp.maximum(magnitude_reconstructed, 1e-7)

# Griffin-Lim 算法
def griffin_lim(magnitude, n_iter, hop_length, window, signal_length):
    """迭代相位重建。"""
    n_fft = (magnitude.shape[1] - 1) * 2
    key = jax.random.PRNGKey(42)
    phase = jax.random.uniform(key, magnitude.shape, minval=-jnp.pi, maxval=jnp.pi)

    for _ in range(n_iter):
        complex_spec = magnitude * jnp.exp(1j * phase)
        signal = istft(complex_spec, hop_length, window, signal_length)
        reanalysis = stft(signal, n_fft, hop_length, window)
        phase = jnp.angle(reanalysis)

    complex_spec = magnitude * jnp.exp(1j * phase)
    return istft(complex_spec, hop_length, window, signal_length)

reconstructed = griffin_lim(magnitude_reconstructed, n_iter=60, hop_length=hop_length,
                            window=window, signal_length=len(waveform))

# 画图对比
fig, axes = plt.subplots(3, 1, figsize=(12, 8))

axes[0].plot(t[:1000], waveform[:1000], color='#3498db', linewidth=0.8)
axes[0].set_title('Original Waveform')
axes[0].set_ylabel('Amplitude')

axes[1].imshow(jnp.log1p(mel_spec.T), aspect='auto', origin='lower', cmap='magma')
axes[1].set_title('Mel Spectrogram (intermediate representation)')
axes[1].set_ylabel('Mel bin')

axes[2].plot(t[:1000], reconstructed[:1000], color='#e74c3c', linewidth=0.8)
axes[2].set_title('Griffin-Lim Reconstructed Waveform (60 iterations)')
axes[2].set_xlabel('Time (s)')
axes[2].set_ylabel('Amplitude')

plt.tight_layout()
plt.show()

# 计算重建误差
mse = jnp.mean((waveform[:len(reconstructed)] - reconstructed[:len(waveform)]) ** 2)
print(f"MSE between original and reconstructed: {mse:.6f}")
print("Note: phase information loss through mel inversion causes artifacts.")
- 任务 2:时长预测器 (FastSpeech 风格)。 训练一个小卷积时长预测器,把音素嵌入映射到时长。这是非自回归 TTS 的核心组件。
import jax
import jax.numpy as jnp
import jax.random as jr
import matplotlib.pyplot as plt

# 模拟带真值时长的音素序列
# 真实 TTS 中, 时长来自强制对齐或教师注意力
def generate_synthetic_data(key, n_samples=200, max_phonemes=30, embed_dim=64):
    """生成合成音素嵌入与时长。"""
    keys = jr.split(key, 4)
    lengths = jr.randint(keys[0], (n_samples,), 5, max_phonemes)

    all_embeddings = []
    all_durations = []
    all_masks = []

    for i in range(n_samples):
        L = int(lengths[i])
        emb = jr.normal(keys[1], (max_phonemes, embed_dim))
        # 时长: 元音 (偶数索引) 更长, 辅音更短
        base_dur = jnp.where(jnp.arange(max_phonemes) % 2 == 0, 8.0, 4.0)
        noise = jr.normal(jr.fold_in(keys[2], i), (max_phonemes,)) * 1.5
        dur = jnp.clip(base_dur + noise, 1.0, 20.0).astype(jnp.float32)
        mask = (jnp.arange(max_phonemes) < L).astype(jnp.float32)

        all_embeddings.append(emb)
        all_durations.append(dur * mask)
        all_masks.append(mask)

    return (jnp.stack(all_embeddings), jnp.stack(all_durations),
            jnp.stack(all_masks))

key = jr.PRNGKey(42)
embeddings, durations, masks = generate_synthetic_data(key)

# 时长预测器: 2 层 1D 卷积 + 线性投影
def init_duration_predictor(key, embed_dim=64, hidden_dim=128, kernel_size=3):
    """初始化时长预测器权重。"""
    keys = jr.split(key, 4)
    scale1 = jnp.sqrt(2.0 / (embed_dim * kernel_size))
    scale2 = jnp.sqrt(2.0 / (hidden_dim * kernel_size))
    params = {
        'conv1_w': jr.normal(keys[0], (kernel_size, embed_dim, hidden_dim)) * scale1,
        'conv1_b': jnp.zeros(hidden_dim),
        'conv2_w': jr.normal(keys[1], (kernel_size, hidden_dim, hidden_dim)) * scale2,
        'conv2_b': jnp.zeros(hidden_dim),
        'linear_w': jr.normal(keys[2], (hidden_dim, 1)) * jnp.sqrt(2.0 / hidden_dim),
        'linear_b': jnp.zeros(1),
    }
    return params

def duration_predictor(params, x):
    """从音素嵌入预测对数时长。x: (batch, seq, embed)。"""
    # 卷积层 1 + ReLU
    h = jax.lax.conv_general_dilated(
        x.transpose(0, 2, 1),  # (batch, embed, seq)
        params['conv1_w'].transpose(2, 1, 0),  # (out, in, kernel)
        window_strides=(1,), padding='SAME'
    ).transpose(0, 2, 1) + params['conv1_b']  # 回到 (batch, seq, hidden)
    h = jax.nn.relu(h)

    # 卷积层 2 + ReLU
    h = jax.lax.conv_general_dilated(
        h.transpose(0, 2, 1),
        params['conv2_w'].transpose(2, 1, 0),
        window_strides=(1,), padding='SAME'
    ).transpose(0, 2, 1) + params['conv2_b']
    h = jax.nn.relu(h)

    # 线性投影到标量
    log_dur = (h @ params['linear_w'] + params['linear_b']).squeeze(-1)
    return log_dur

# 损失: 对数时长上的 MSE (FastSpeech 标准做法)
def loss_fn(params, embeddings, durations, masks):
    log_dur_pred = duration_predictor(params, embeddings)
    log_dur_true = jnp.log(jnp.clip(durations, 1.0, None))
    sq_err = (log_dur_pred - log_dur_true) ** 2 * masks
    return jnp.sum(sq_err) / jnp.sum(masks)

grad_fn = jax.jit(jax.value_and_grad(loss_fn))

# 训练循环
params = init_duration_predictor(jr.PRNGKey(0))
lr = 1e-3
losses = []

for epoch in range(300):
    loss_val, grads = grad_fn(params, embeddings, durations, masks)
    params = jax.tree.map(lambda p, g: p - lr * g, params, grads)
    losses.append(float(loss_val))

# 在样本上评估
log_dur_pred = duration_predictor(params, embeddings[:1])
dur_pred = jnp.exp(log_dur_pred[0])
dur_true = durations[0]
mask = masks[0]
valid_len = int(jnp.sum(mask))

fig, axes = plt.subplots(1, 2, figsize=(14, 5))

axes[0].plot(losses, color='#3498db', linewidth=1.5)
axes[0].set_xlabel('Epoch')
axes[0].set_ylabel('MSE Loss (log-duration)')
axes[0].set_title('Duration Predictor Training')
axes[0].set_yscale('log')

x_pos = jnp.arange(valid_len)
width = 0.35
axes[1].bar(x_pos - width/2, dur_true[:valid_len], width, color='#27ae60',
            label='Ground truth', alpha=0.8)
axes[1].bar(x_pos + width/2, dur_pred[:valid_len], width, color='#e74c3c',
            label='Predicted', alpha=0.8)
axes[1].set_xlabel('Phoneme index')
axes[1].set_ylabel('Duration (frames)')
axes[1].set_title('Duration Prediction vs Ground Truth')
axes[1].legend()

plt.tight_layout()
plt.show()
- 任务 3:用上采样卷积搭一个简易神经声码器。 搭一个 HiFi-GAN 风格的极简生成器,用转置卷积和残差块把梅尔频谱图上采样成波形。
import jax
import jax.numpy as jnp
import jax.random as jr
import matplotlib.pyplot as plt

def init_residual_block(key, channels, kernel_size, dilation):
    """初始化一个膨胀残差卷积块。"""
    k1, k2 = jr.split(key)
    scale = jnp.sqrt(2.0 / (channels * kernel_size))
    return {
        'conv1_w': jr.normal(k1, (kernel_size, channels, channels)) * scale,
        'conv1_b': jnp.zeros(channels),
        'conv2_w': jr.normal(k2, (kernel_size, channels, channels)) * scale,
        'conv2_b': jnp.zeros(channels),
        'dilation': dilation
    }

def residual_block(params, x):
    """x: (batch, time, channels)。带 LeakyReLU 的膨胀卷积残差块。"""
    h = jax.nn.leaky_relu(x, negative_slope=0.1)
    # 简化: 用标准卷积 (膨胀在概念上处理)
    h = jax.lax.conv_general_dilated(
        h.transpose(0, 2, 1),
        params['conv1_w'].transpose(2, 1, 0),
        window_strides=(1,),
        padding='SAME',
        rhs_dilation=(params['dilation'],)
    ).transpose(0, 2, 1) + params['conv1_b']
    h = jax.nn.leaky_relu(h, negative_slope=0.1)
    h = jax.lax.conv_general_dilated(
        h.transpose(0, 2, 1),
        params['conv2_w'].transpose(2, 1, 0),
        window_strides=(1,),
        padding='SAME'
    ).transpose(0, 2, 1) + params['conv2_b']
    return x + h

def init_generator(key, n_mels=80, upsample_rates=(8, 8, 4),
                   channels=128):
    """初始化极简 HiFi-GAN 风格生成器。"""
    keys = jr.split(key, 10)
    params = {}

    # 输入投影: mel 通道 -> channels
    params['input_w'] = jr.normal(keys[0], (7, n_mels, channels)) * 0.02
    params['input_b'] = jnp.zeros(channels)

    # 上采样块 (转置卷积)
    in_ch = channels
    for i, rate in enumerate(upsample_rates):
        k_size = rate * 2
        scale = jnp.sqrt(2.0 / (in_ch * k_size))
        out_ch = in_ch // 2
        params[f'up{i}_w'] = jr.normal(keys[i+1], (k_size, in_ch, out_ch)) * scale
        params[f'up{i}_b'] = jnp.zeros(out_ch)
        # 每个尺度上的残差块
        params[f'res{i}_0'] = init_residual_block(jr.fold_in(keys[i+4], 0),
                                                    out_ch, 3, 1)
        params[f'res{i}_1'] = init_residual_block(jr.fold_in(keys[i+4], 1),
                                                    out_ch, 3, 3)
        in_ch = out_ch

    # 输出投影到单声道波形
    params['output_w'] = jr.normal(keys[8], (7, in_ch, 1)) * 0.02
    params['output_b'] = jnp.zeros(1)
    params['upsample_rates'] = upsample_rates

    return params

def generator_forward(params, mel):
    """mel: (batch, time, n_mels) -> waveform: (batch, time * prod(rates), 1)。"""
    # 输入投影
    h = jax.lax.conv_general_dilated(
        mel.transpose(0, 2, 1),
        params['input_w'].transpose(2, 1, 0),
        window_strides=(1,), padding='SAME'
    ).transpose(0, 2, 1) + params['input_b']

    for i, rate in enumerate(params['upsample_rates']):
        h = jax.nn.leaky_relu(h, negative_slope=0.1)
        # 转置卷积上采样
        k_size = rate * 2
        h = jax.lax.conv_transpose(
            h.transpose(0, 2, 1),
            params[f'up{i}_w'].transpose(2, 1, 0),
            strides=(rate,),
            padding='SAME'
        ).transpose(0, 2, 1) + params[f'up{i}_b']
        # 残差块
        h = residual_block(params[f'res{i}_0'], h)
        h = residual_block(params[f'res{i}_1'], h)

    h = jax.nn.leaky_relu(h, negative_slope=0.1)
    out = jax.lax.conv_general_dilated(
        h.transpose(0, 2, 1),
        params['output_w'].transpose(2, 1, 0),
        window_strides=(1,), padding='SAME'
    ).transpose(0, 2, 1) + params['output_b']

    return jnp.tanh(out)

# 构造合成梅尔频谱图 (模拟一个元音)
n_mels = 80
n_frames = 50
mel = jnp.zeros((1, n_frames, n_mels))
# 在低频梅尔通道注入能量 (模拟共振峰)
mel = mel.at[:, :, 5:15].set(1.0)
mel = mel.at[:, :, 20:25].set(0.6)

# 初始化并运行生成器
key = jr.PRNGKey(42)
params = init_generator(key, n_mels=n_mels, upsample_rates=(8, 8, 4),
                         channels=128)
waveform = generator_forward(params, mel)

print(f"Input mel shape:  {mel.shape}")
print(f"Output waveform shape: {waveform.shape}")
print(f"Upsample factor: {8 * 8 * 4} = {8*8*4}x")

fig, axes = plt.subplots(2, 1, figsize=(12, 6))

axes[0].imshow(mel[0].T, aspect='auto', origin='lower', cmap='magma')
axes[0].set_title('Input Mel Spectrogram')
axes[0].set_ylabel('Mel bin')
axes[0].set_xlabel('Frame')

waveform_np = waveform[0, :, 0]
axes[1].plot(waveform_np[:2000], color='#9b59b6', linewidth=0.5)
axes[1].set_title('Generator Output Waveform (untrained - random noise)')
axes[1].set_ylabel('Amplitude')
axes[1].set_xlabel('Sample')

plt.tight_layout()
plt.show()
print("Note: The output is noise because the generator is untrained.")
print("In practice, adversarial + mel loss training shapes this into speech.")
- 任务 4:用简单 RNN 做语音活动检测。 在合成音频特征上训一个基于 GRU 的小型 VAD 模型,逐帧分类语音 / 静默。
import jax
import jax.numpy as jnp
import jax.random as jr
import matplotlib.pyplot as plt

# 生成合成对数梅尔能量特征, 带语音 / 静默标签
def generate_vad_data(key, n_sequences=100, n_frames=200, n_features=40):
    """模拟对数梅尔特征: 语音区能量更高且有结构。"""
    keys = jr.split(key, 5)
    all_features = []
    all_labels = []

    for i in range(n_sequences):
        k = jr.fold_in(keys[0], i)
        k1, k2, k3 = jr.split(k, 3)

        # 随机语音 / 静默模式
        label = jnp.zeros(n_frames)
        n_segments = jr.randint(k1, (), 2, 6)
        for seg in range(int(n_segments)):
            start = jr.randint(jr.fold_in(k2, seg), (), 0, n_frames - 20)
            length = jr.randint(jr.fold_in(k3, seg), (), 10, 50)
            end = jnp.minimum(start + length, n_frames)
            label = label.at[int(start):int(end)].set(1.0)

        # 特征: 语音帧能量更高 + 频谱结构
        noise = jr.normal(jr.fold_in(keys[1], i), (n_frames, n_features)) * 0.3
        speech_pattern = jnp.outer(label, jnp.exp(-jnp.arange(n_features) / 15.0))
        features = speech_pattern * 2.0 + noise + 0.1

        all_features.append(features)
        all_labels.append(label)

    return jnp.stack(all_features), jnp.stack(all_labels)

key = jr.PRNGKey(123)
features, labels = generate_vad_data(key)
train_features, train_labels = features[:80], labels[:80]
test_features, test_labels = features[80:], labels[80:]

# 基于 GRU 的简易 VAD 模型
def init_vad_model(key, input_dim=40, hidden_dim=64):
    keys = jr.split(key, 6)
    scale_ih = jnp.sqrt(2.0 / input_dim)
    scale_hh = jnp.sqrt(2.0 / hidden_dim)
    return {
        'W_z': jr.normal(keys[0], (input_dim, hidden_dim)) * scale_ih,
        'U_z': jr.normal(keys[1], (hidden_dim, hidden_dim)) * scale_hh,
        'b_z': jnp.zeros(hidden_dim),
        'W_r': jr.normal(keys[2], (input_dim, hidden_dim)) * scale_ih,
        'U_r': jr.normal(keys[3], (hidden_dim, hidden_dim)) * scale_hh,
        'b_r': jnp.zeros(hidden_dim),
        'W_h': jr.normal(keys[4], (input_dim, hidden_dim)) * scale_ih,
        'U_h': jr.normal(keys[5], (hidden_dim, hidden_dim)) * scale_hh,
        'b_h': jnp.zeros(hidden_dim),
        'W_out': jr.normal(jr.fold_in(keys[0], 99), (hidden_dim, 1)) * 0.1,
        'b_out': jnp.zeros(1),
    }

def gru_step(params, h, x):
    """单步 GRU。"""
    z = jax.nn.sigmoid(x @ params['W_z'] + h @ params['U_z'] + params['b_z'])
    r = jax.nn.sigmoid(x @ params['W_r'] + h @ params['U_r'] + params['b_r'])
    h_tilde = jnp.tanh(x @ params['W_h'] + (r * h) @ params['U_h'] + params['b_h'])
    h_new = (1 - z) * h + z * h_tilde
    return h_new

def vad_forward(params, x):
    """x: (batch, time, features) -> logits: (batch, time)。"""
    batch_size, n_frames, _ = x.shape
    hidden_dim = params['W_z'].shape[1]
    h = jnp.zeros((batch_size, hidden_dim))

    outputs = []
    for t in range(n_frames):
        h = gru_step(params, h, x[:, t, :])
        logit = (h @ params['W_out'] + params['b_out']).squeeze(-1)
        outputs.append(logit)

    return jnp.stack(outputs, axis=1)

def bce_loss(params, features, labels):
    """VAD 的二元交叉熵损失。"""
    logits = vad_forward(params, features)
    probs = jax.nn.sigmoid(logits)
    probs = jnp.clip(probs, 1e-7, 1 - 1e-7)
    loss = -(labels * jnp.log(probs) + (1 - labels) * jnp.log(1 - probs))
    return jnp.mean(loss)

grad_fn = jax.jit(jax.value_and_grad(bce_loss))

# 训练
params = init_vad_model(jr.PRNGKey(0))
lr = 5e-3
losses = []

for epoch in range(200):
    loss_val, grads = grad_fn(params, train_features, train_labels)
    params = jax.tree.map(lambda p, g: p - lr * g, params, grads)
    losses.append(float(loss_val))
    if epoch % 50 == 0:
        print(f"Epoch {epoch}: loss = {loss_val:.4f}")

# 在测试集上评估
test_logits = vad_forward(params, test_features)
test_preds = (jax.nn.sigmoid(test_logits) > 0.5).astype(jnp.float32)
accuracy = jnp.mean(test_preds == test_labels)
print(f"\nTest accuracy: {accuracy:.4f}")

# 可视化一个测试样例
idx = 0
fig, axes = plt.subplots(3, 1, figsize=(14, 7))

axes[0].imshow(test_features[idx].T, aspect='auto', origin='lower', cmap='magma')
axes[0].set_title('Log-Mel Energy Features')
axes[0].set_ylabel('Mel bin')

axes[1].fill_between(range(200), test_labels[idx], alpha=0.4, color='#27ae60',
                     label='Ground truth')
axes[1].plot(jax.nn.sigmoid(test_logits[idx]), color='#e74c3c',
             linewidth=1.5, label='Predicted probability')
axes[1].axhline(0.5, color='gray', linestyle='--', linewidth=0.8)
axes[1].set_ylabel('Speech probability')
axes[1].legend()
axes[1].set_title('VAD Predictions')

axes[2].fill_between(range(200), test_labels[idx], alpha=0.4, color='#27ae60',
                     label='Ground truth')
axes[2].fill_between(range(200), test_preds[idx], alpha=0.4, color='#f39c12',
                     label='Predicted (threshold=0.5)')
axes[2].set_ylabel('Speech / Silence')
axes[2].set_xlabel('Frame')
axes[2].legend()
axes[2].set_title('VAD Binary Decision')

plt.tight_layout()
plt.show()
📌 本节要点
- TTS 四段流水线:文本归一化 → G2P → 声学模型 → 声码器,现代端到端系统可将后两段合一
- WaveNet 与膨胀因果卷积:自回归预测每个采样点,用指数膨胀获得大感受野,但推理极慢
- HiFi-GAN:用 GAN 从梅尔频谱图并行合成波形,MRF + MPD/MSD 判别器,比 WaveNet 快 1000 倍
- Tacotron 2 与位置敏感注意力:自回归编码器-解码器,位置特征防止跳字与重复
- FastSpeech 系列:非自回归 + 时长预测器 + 方差适配器,10-20 倍加速且可控韵律
- VITS 端到端: VAE + 归一化流 + 对抗训练联合优化声学模型与声码器,消除两阶段失配
- 编解码语言模型 (VALL-E / Orpheus / Fish Speech):把 TTS 变成离散音频 token 上的 LM,支持零样本克隆
- 声音克隆三层:多说话人 → 少样本 (SV2TTS) → 零样本 (VALL-E, 3 秒即可)
- 韵律要素:音高 (\(F_0\))、时长、能量,加上 GST 之类的风格嵌入
- Silero VAD:深度可分离卷积 + LSTM, <2MB,实时因子 1-2%,是生产级 VAD 事实标准
- 两大范式并行进化:编解码 LM (强克隆 / 表达) vs. 流 / 扩散 (轻量 / 快),都在快速接近人类自然度