视觉语言模型
一句话总结:视觉语言模型把视觉编码器和大语言模型缝合起来,让机器既能看图又能说话,统一支撑图像描述、视觉问答、指代定位等一整套任务。
视觉语言模型联合理解图像与文本,支撑视觉问答、图像描述与视觉推理等任务。 本节涵盖 VQA、图像描述、视觉定位,以及 VisualBERT、BLIP、LLaVA、Flamingo、PaLI、Qwen-VL 等把视觉编码器与大语言模型融合起来的架构.
-
想象一位博物馆讲解员,他看一幅画就能说出全部信息:画里有什么物体、讲了什么故事、传达了什么情绪,参观者随便怎么问都能应对。 视觉语言模型 (Vision-Language Model, VLM) 就是它的计算版本 —— 一个能联合理解图像和文本的系统,既能描述视觉场景、回答关于图像的问题、遵循视觉指令,甚至在给出自然语言查询时把图中特定物体定位出来。
-
VLM 恰好位于第 8 章视觉编码器与第 7 章语言模型的交叉点上。 核心的工程挑战是:如何在两种差异巨大的表示世界之间架桥 —— 一边是视觉骨干网络产出的空间上、连续的特征图,一边是语言模型使用的顺序、离散的 Token 嵌入。 本节里的每一种架构,说到底都是在回答同一个问题:视觉和语言到底怎么融合?
视觉问答
-
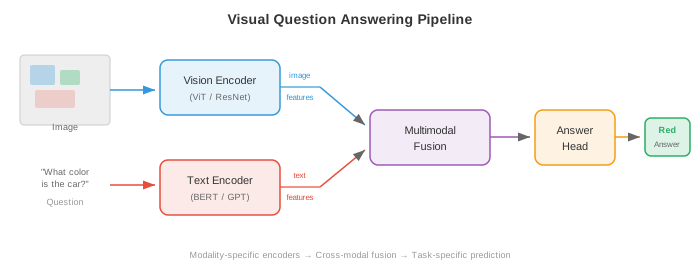
想象一下,有人拿出一张照片问你 "公园里有几只狗?" 你会毫不费力地解析图像、找到狗、数出来,然后给出答案。 视觉问答 (Visual Question Answering, VQA) 就是把这件事形式化:给定图像 \(I\) 和自然语言问题 \(q\),预测答案 \(a\).
-
这个任务有几种建模方式。 最常见的把 VQA 视为开放式分类:模型从一个固定的高频答案词表中选一个 (例如 VQA v2 里前 3,129 个答案). 另一种把它视为生成式回答,模型直接产出一段自由格式文本 —— 这也是现代 VLM 采用的路子。
-
形式化地讲,我们要学一个函数 \(f(I, q) \to a\),让正确答案的似然最大。 在分类框架下就变成:
-
其中 \(v\) 是视觉特征向量 (来自 CNN 或 ViT), \(h\) 是问题编码 (来自 LSTM 或 Transformer), \(g\) 是把二者合起来的融合函数。 真正体现架构创造力的地方,就在 \(g\) 怎么设计。
-
VQA v1 (Antol 等,2015) 提出了这个基准,基于 MS COCO 上 20.4 万张图像出了 61.4 万个问题。 研究者很快发现:模型可以靠语言先验拿到出乎意料高的准确率 —— 遇到 "how many" 直接回答 "2",遇到 "is there" 直接回答 "yes",根本不看图。
-
VQA v2 (Goyal 等,2017) 修正了这一点:每个问题都配两张相似但答案不同的图,迫使模型必须真的把推理落到视觉内容上。 这种配对结构大致把数据集翻倍,也让纯语言捷径基本失效。
-
其他重要的 VQA 数据集包括:GQA (Hudson 与 Manning, 2019),问题是组合式的,需要多步推理;OK-VQA (Marino 等,2019),要求用图外知识;TextVQA (Singh 等,2019),答案取决于读出图中的文字。
-
早期 VQA 模型用的是简单策略:从预训练的 CNN 提取图像特征 (通常是第 8 章 ResNet 或 VGGNet 的倒数第二层),用 LSTM 编码问题 (第 6 章),然后组合。 组合函数 \(g\) 演化得很快:从简单的逐元素相乘,到双线性池化,再到多模态 Tucker 分解。 双线性注意力计算 \(v^T W h\),其中 \(W\) 是可学习的交互矩阵,但完整双线性形式有 \(O(d_v \times d_h)\) 个参数,大到用不了。 MLB (多模态低秩双线性池化) 把它分解成两个低秩投影,让计算变得可行。
-
VQA 的突破点是注意力。 堆叠注意力网络 (Stacked Attention Networks) (Yang 等,2016) 用问题编码去关注图像的空间区域,迭代地精修 "该看图的哪里". 这个想法 —— 让问题 "看向" 相关的图像区域 —— 后来变成标配。
图像描述
-
想象朋友翻你的度假照片,边看边说:"一只金毛在阳光明媚的沙滩上接飞盘." 图像描述 (image captioning) 就是给一张图生成自然语言描述。 和 VQA 不同,这里没有问题 —— 模型得自己决定哪些东西值得描述。
-
Show and Tell (Vinyals 等,2015) 确立了图像描述的经典编码器-解码器架构。 一个 CNN 编码器 (例如 Inception 或 ResNet) 产出一个单一的图像特征向量 \(v\),这个向量当作 LSTM 解码器的初始隐藏状态,然后自回归地逐词生成描述:
-
整个模型端到端训练,最大化真实描述的对数似然。 推理时用集束搜索 (beam search,第 7 章) 找高概率描述。
-
Show and Tell 的问题在于:整张图被压成一个向量。 场景复杂时,一个向量装不下所有关键细节。 空间信息也丢了 —— 模型在生成不同词的时候没法 "回头看" 图像的具体位置。
-
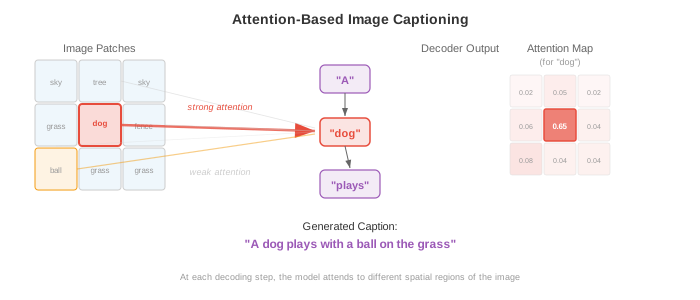
Show, Attend and Tell (Xu 等,2015) 用图像区域上的注意力解决了这个问题。 它不再把图像编成一个向量,CNN 产出的是一个空间特征网格 (例如 VGGNet 最后一层卷积输出的 \(14 \times 14 \times 512\)). 每个解码步,模型在这些空间位置上计算注意力权重,得到一个上下文向量,突出当前词最相关的区域。
-
回想一下第 6 章的注意力机制:解码器隐藏状态当查询,空间特征当键和值,注意力权重告诉模型该往哪儿看。 作者提出了两种变体:软注意力 (可微,对所有区域加权平均) 和硬注意力 (随机采样一个区域,用 REINFORCE 训练).
-
这类模型产出的注意力图非常有可解释性:生成 "dog" 时注意力峰值落在狗上,生成 "beach" 时移到沙和水。 这是最早令人信服地说明 "注意力自带可解释性" 的例子之一。
-
CIDEr (Vedantam 等,2015)、METEOR、BLEU、SPICE 是图像描述的标准评价指标。 CIDEr 计算生成描述与参考描述之间基于 TF-IDF 加权的 n-gram 相似度,是专为图像描述评估设计的。 现代 VLM 通常在 MS COCO Captions、NoCaps 等基准上用 CIDEr 评估。
-
后来的图像描述模型引入了自底向上注意力 (bottom-up attention) (Anderson 等,2018):先用目标检测器 (Faster R-CNN,第 8 章) 提取显著图像区域,图像描述模型再在这些区域特征上注意,而不是在均匀网格上。 在基于 ViT 的编码器接管之前,这是主流做法。
架构范式
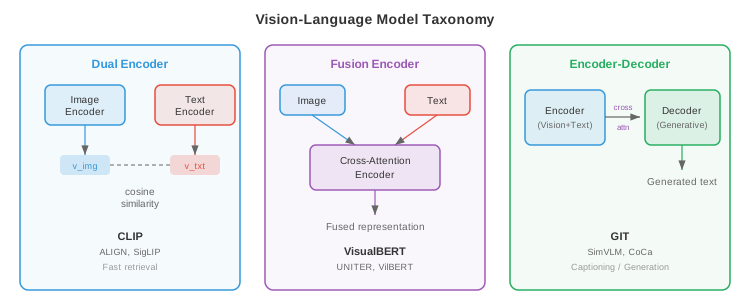
- 每个 VLM 都必须回答一个根本的设计问题:视觉和语言在什么时候开始交互?答案决定了模型的架构家族。 主要有三种范式,各有取舍。
双编码器
-
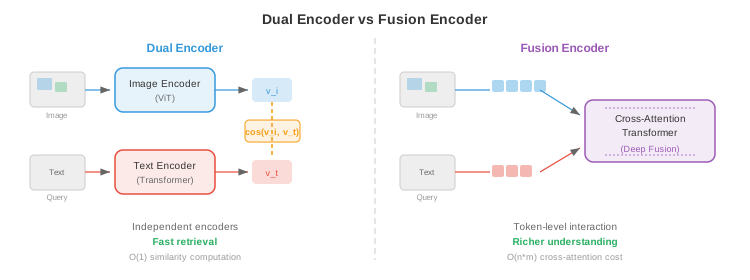
想象两位翻译独立工作 —— 一位读法语文档,一位读英语文档 —— 各自用同一种 "通用语言" 写摘要。 翻译过程中他们从不交流,但两份摘要可以直接比对。 这就是双编码器 (dual encoder) 范式。
-
一个视觉编码器 \(f_v\) 和一个文本编码器 \(f_t\) 各自把输入映射到一个共享的 \(d\) 维嵌入空间。 图像嵌入是 \(v = f_v(I) \in \mathbb{R}^d\),文本嵌入是 \(t = f_t(q) \in \mathbb{R}^d\). 相似度用点积或余弦相似度:\(\text{sim}(I, q) = v^T t / (\|v\| \|t\|)\).
-
CLIP (Radford 等,2021),在上一节多模态表示中介绍过,是双编码器的典型代表。 它用对比目标 (InfoNCE) 在从互联网上爬来的 4 亿图文对上训练。 因为两个编码器互相独立,你可以把所有图像嵌入预先算好并缓存,检索起来极其高效 —— 搜索时只需要编码查询文本。
-
双编码器的弱点在于视觉和语言从不在特征层面交互。 模型没法做细粒度的跨模态推理:比如它没法判断某个词是否对应图像中某个具体区域。 这限制了它在 VQA 或带定位的图像描述这类任务上的表现。
融合编码器
-
现在换个场景:两位翻译在同一个房间,就着两份文档积极讨论。 他们可以指出具体段落、互相提问、建立起共同理解。 这就是融合编码器 (fusion encoder) 范式。
-
两种模态先各自编码,然后通过交叉注意力层融合,让一种模态的 Token 关注另一种模态的 Token. 图像先经视觉编码器变成一序列图块或区域 Token \(V = [v_1, \ldots, v_N]\);文本分词后得到 \(T = [t_1, \ldots, t_M]\). 在融合层里,文本 Token 通过交叉注意力关注图像 Token:
- 这样就实现了细粒度交互:每个文本 Token 都能关注它所需要的那些图像区域。 VisualBERT、VilBERT、UNITER 都用这种范式。 代价是你没法为检索预先算独立嵌入 —— 每对图文都得完整跑一遍融合层。
编码器-解码器
-
编码器-解码器 (encoder-decoder) 范式把视觉编码器和文本解码器组合起来,后者自回归地生成输出 Token,类似第 7 章的 seq2seq 模型。 视觉编码器产出上下文化的图像表示,文本解码器边生成边对它们做交叉注意力。
-
这种范式天然适合生成式任务:图像描述、开放式回答的 VQA、视觉对话。 GIT (Generative Image-to-text Transformer, Wang 等,2022)、CoCa (Contrastive Captioner, Yu 等,2022)、PaLI 都用这种架构。 CoCa 更妙的是把双编码器和编码器-解码器揉在一起:文本解码器前半段的层当作单模态文本编码器 (用于对比学习),后半段的层交叉注意到图像特征 (用于生成式图像描述),两种范式的优点都占到了。
-
三种范式的选择取决于目标任务。 大规模检索用双编码器最合适;细粒度理解用融合编码器最好;生成式任务用编码器-解码器最灵活。 现代最先进的 VLM 越来越多采用编码器-解码器或仅解码器 (decoder-only) 范式,把每个视觉语言任务都当作文本生成来做。
Flamingo:少样本多模态学习
-
想象一位既懂艺术又懂文学的老手,拿到一种从没见过的绘画风格,只要看一两个例子就能滔滔不绝地讲解。 Flamingo (Alonso 等,2022, DeepMind) 就是照这个原则搭的:用强大的预训练语言模型和预训练视觉编码器,中间用轻量的架构组件把它们连起来,从而在多模态任务上实现少样本 (few-shot) 学习。
-
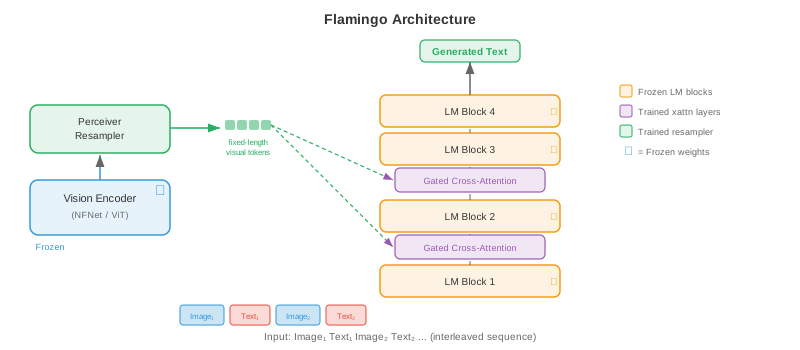
Flamingo 的设计哲学既保守又有效:保持预训练的视觉编码器 (NFNet) 和语言模型 (Chinchilla) 冻结,只学习连接它们的 "胶水". 胶水由两部分组成:一个 Perceiver Resampler 和若干门控交叉注意力 (gated cross-attention) 层.
-
Perceiver Resampler 接收视觉编码器变长的输出 (长度取决于图像分辨率),把它压缩成固定数量的 \(N\) 个视觉 Token (通常 \(N = 64\)). 做法是初始化 \(N\) 个可学习查询向量,用交叉注意力让这些查询关注视觉编码器的全部输出。 本质上就是把 Perceiver 架构 (Jaegle 等,2021) 当作瓶颈用 —— 无论输入图像多大,都产出紧凑、固定大小的视觉表示。
- 门控交叉注意力层穿插在冻结的语言模型层之间。 每一层里,语言模型的文本 Token 都会交叉注意到 Perceiver Resampler 产出的视觉 Token. 关键在于,每个门控交叉注意力层都有一个可学习的标量门 \(\alpha\),初始化为零,在把交叉注意力的输出加到残差流之前先乘上去:
- 把 \(\alpha\) 初始化成 0 意味着训练开始时交叉注意力贡献为零,模型行为和原始冻结语言模型一模一样。 门在训练过程中逐渐打开,平滑地把视觉信息注入进去,不会打乱语言模型的预训练表示。
-
Flamingo 原生支持图文交错序列. 你可以喂给它一个含多张图、图之间夹着文字的提示,例如:"[图 1] 这是猫。 [图 2] 这是狗。 [图 3] 这是 ___." 模型对每张图跑一次视觉编码器和 Perceiver Resampler,得到的视觉 Token 插到文本序列的对应位置。 语言模型的因果注意力掩码保证每个文本 Token 只能关注到当前及之前那些图像的视觉 Token.
-
这种交错方式支撑起了强大的少样本多模态学习. 只要在上下文里提供几对图文示例,Flamingo 就能在不做任何梯度更新的情况下执行新任务。 在 VQAv2、OK-VQA、图像描述等基准上,800 亿参数的 Flamingo 达到了当时最强的少样本表现,只用 4 到 32 个示例就常常追平甚至超过专门微调过的特定任务模型。
LLaVA 与视觉指令微调
-
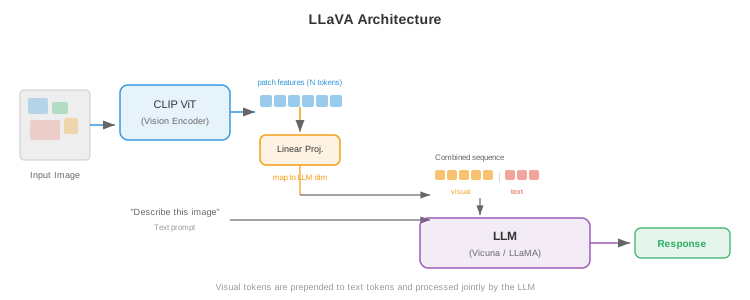
想象你有一位杰出的语言专家 (一个 LLM) 和一位杰出的艺术评论家 (一个视觉编码器). 如果你能让艺术评论家 "说语言专家的语言",两人就能无缝合作。 LLaVA (Large Language and Vision Assistant, Liu 等,2023) 做的就是这件事:用一个简单的线性层把视觉特征投影到 LLM 的 Token 嵌入空间,然后在指令跟随数据上对整个系统微调。
-
LLaVA 的架构简洁得惊人。 图像被预训练的 CLIP ViT-L/14 视觉编码器编码成一个图块特征网格 \(V \in \mathbb{R}^{N \times d_v}\),其中 \(N = 256\) 个图块 (336px 图像配 14px 图块). 一个投影层 \(W\) 把这些视觉特征映射到 LLM 的嵌入维度:
- 投影后的视觉 Token \(H_v\) 直接和文本 Token 嵌入拼接,当成一个整体序列喂给 LLM (Vicuna,一个微调过的 LLaMA). LLM 用标准的因果自注意力处理它们 —— 没有专门的交叉注意力层,没有 Perceiver,就是简单拼接。 视觉 Token 被当作恰好携带视觉信息的 "文本 Token" 来对待。
-
视觉指令微调 (visual instruction tuning) 是 LLaVA 的关键训练创新。 作者用 GPT-4 基于 COCO 图像生成了 15.8 万条多模态指令跟随样本。 每个样本包含一张图和一条对话式指令 (例如 "详细描述这张图"、"这张图哪里不寻常?"、"如果我是来这地方旅游的游客,应该注意些什么?"),模型的训练目标是在给定图像和指令的条件下生成 GPT-4 撰写的回答。
-
训练分两阶段。 阶段 1 (预训练):只训投影层 \(W\),数据是图像-描述对 (CC3M 里的 59.5 万条),视觉编码器和 LLM 都冻结。 这一步教 \(W\) 把视觉特征对齐到 LLM 的嵌入空间。 阶段 2 (微调):投影层和 LLM 一起在指令跟随数据上微调,视觉编码器仍冻结。 这一步教模型去执行复杂的视觉指令。
-
LLaVA-1.5 在原版基础上做了三处关键改动:把单层线性投影换成两层 MLP (更强的映射能力);使用更高分辨率的图像 (336px 而不是 224px,产出更多图块 Token);训练数据里加入学术 VQA 数据集。 这些看似不起眼的修改,带来了基准表现的大幅跃升。
-
LLaVA 的做法说明:你不需要 Flamingo 那种 Perceiver Resampler 或门控交叉注意力这类复杂的架构创新。 一个简单的线性投影,配上高质量的指令微调数据,就足以把视觉编码器有效地接到 LLM 上。 这种简洁让 LLaVA 影响力极大 —— 后来的大多数开源 VLM 都沿用类似配方。
视觉语言模型的规模化
- 领域迅速从概念验证型 VLM 走向了工业规模系统 —— 在数十亿图文对上训练。 下面三个模型家族代表了三种不同的规模化路线。
PaLI
-
PaLI (Pathways Language and Image model, Chen 等,2022, Google) 同时扩展视觉编码器和语言模型。 PaLI 用 ViT-e (40 亿参数) 作视觉编码器,mT5 (130 亿参数) 作语言模型,总参数 170 亿。 图像被编码成一序列图块 Token,前置到文本 Token 前面,一起送入编码器-解码器架构的 mT5.
-
PaLI 的核心洞见是:扩展视觉编码器和扩展语言模型同样重要. 之前的工作通常用一个固定的中等规模视觉骨干 (例如 ViT-B 或 ViT-L),把所有参数预算砸给 LLM. PaLI 表明:一个在 JFT-4B (40 亿有标签图像) 上预训练的 40 亿参数 ViT-e 能显著提升 OCR 和空间推理这类细粒度视觉任务的表现。
-
PaLI 训练用的是 WebLI,一个含 100 亿图文对、覆盖 109 种语言的数据集,因此天生多语。 模型在预训练时用多任务混合:图像描述、VQA、图文匹配,全部都当作 T5 范式 (第 7 章) 里的文本到文本生成来做。 PaLI-X (550 亿参数) 和 PaLI-3 (50 亿参数,视觉编码器换成 SigLIP) 是后续版本。
Qwen-VL
-
Qwen-VL (Bai 等,2023,阿里巴巴) 在 Qwen 大语言模型的基础上加了一个 ViT 视觉编码器和一个单层交叉注意力模块 (类似 Flamingo 的 Perceiver Resampler),把视觉编码器输出压缩成固定的 256 个视觉 Token. 视觉 Token 和文本 Token 拼在一起,由 Qwen LLM 处理。
-
Qwen-VL 的训练用三阶段配方。 阶段 1:在 14 亿弱监督图文对上预训练,只放开视觉编码器。 阶段 2:多任务预训练,数据包括 VQA、图像描述、定位、OCR 等更高质量数据集,全模型放开。 阶段 3:在指令跟随和对话数据上做有监督微调。 这种从噪声网络数据到精选指令数据的渐进精修,是现代 VLM 普遍采用的模式。
-
Qwen2-VL (2024) 引入了动态分辨率支持:不再把所有图像缩到固定尺寸,而是按图像原生分辨率处理,动态调整视觉 Token 数量。 高分辨率图像产出更多 Token,低分辨率图像产出更少。 这在文档理解、细粒度识别等对细节敏感的任务上明显加分,又不会把算力浪费在低分辨率输入上。
InternVL
-
InternVL (Chen 等,2024,上海人工智能实验室) 大刀阔斧地扩展视觉编码器,用 InternViT-6B —— 一个 60 亿参数的 Vision Transformer —— 配一个语言模型。 关键的架构贡献是动态高分辨率处理:图像切成 448x448 像素的瓦片,每块独立过视觉编码器,再把这些瓦片特征和整图的缩略图特征拼起来。 这样模型就能处理任意宽高比和分辨率的图像。
-
InternVL-2 又引入了渐进对齐训练:先用对比目标 (类似 CLIP) 对齐视觉编码器,再用轻量 MLP 连接器把它接到 LLM,最后在指令数据上端到端微调。 这种渐进策略防止视觉编码器的预训练表示被灾难性遗忘。
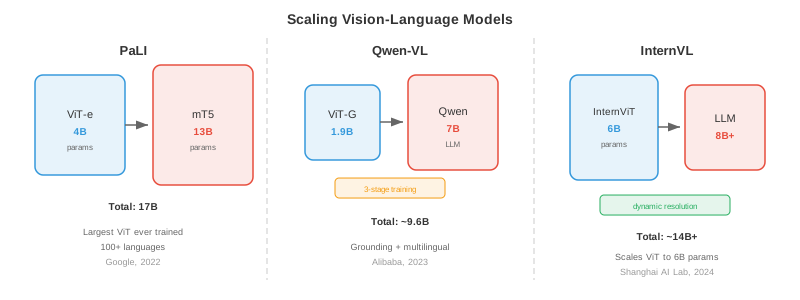
- 三个家族共同的主题是训练数据的精修. 从网络爬来的原始图文对噪声大且对齐差。 后续训练阶段逐步过滤和精修数据,从数十亿的噪声对推进到数百万的高质量指令样本。 最终微调数据的质量,往往比模型的原始参数量更重要。
定位与指代
-
想象你在人群中指着一个人说 "那个戴红色帽子的女人". 你在用语言指代一个特定的空间区域。 视觉定位 (visual grounding) 是反向问题:给定图像和自然语言表达,模型要识别 (定位) 被指代的物体。 指代表达理解 (referring expression comprehension) 产出边界框;指代表达分割 (referring expression segmentation) 产出像素掩码。
-
形式化地讲,给定图像 \(I\) 和指代表达 \(r\) (例如 "左边那只大棕狗"),模型预测一个边界框 \(b = (x, y, w, h)\) 或一组坐标,把指代对象定位出来。 数据集包括 RefCOCO、RefCOCO+、RefCOCOg,每个都含多物体图像,且为每张图都提供了无歧义的指代表达。
-
早期定位模型走的是两阶段路线:先生成候选区域 (来自 Faster R-CNN 之类),再用融合模型给每个候选和语言查询打分,最高分的区域就是预测结果。 计算开销大,且受候选质量制约。
-
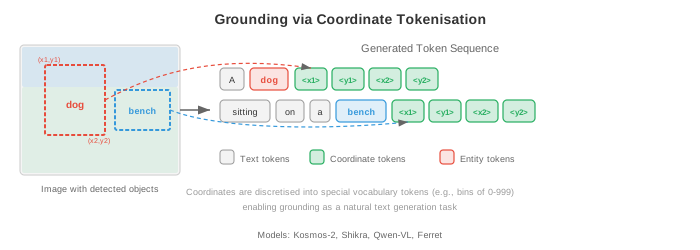
现代 VLM 把定位直接融进生成式框架。 关键想法是把边界框坐标表示为文本 Token. 把连续坐标空间离散化成若干个 bin (例如 \(x, y, w, h\) 每个 1000 个 bin),在词表里加入
<loc_342>这样的特殊位置 Token. 模型只需输出一串位置 Token 就生成了一个边界框:
-
这种 Token 化技巧让任何自回归语言模型都能做定位,完全不用改架构 —— 它只是学着 "说坐标". Pix2Seq (Chen 等,2022) 开创性地把它用到目标检测上,后续 Qwen-VL、Ferret、Kosmos-2 等模型把它扩展到指代表达理解和短语定位。
-
Kosmos-2 (Peng 等,2023, Microsoft) 给多模态 LLM 加上了定位能力,把空间位置表示为嵌入到生成文本中的特殊 Token. 比如它可以生成:"A
<phrase>golden retriever</phrase><box><loc_102><loc_215><loc_487><loc_398></box>is catching a frisbee." 这种把文本和空间 Token 交错的方式,让描述和定位同时发生。
- 指点 (pointing) 把定位再推进一步:不给边界框,而是预测一个点 (通常是被指代物体的中心). 这在交互式应用里很有用,比如用户问 "最近的出口在哪里?",模型就返回一个覆盖在图像上的坐标点。 Shikra、Ferret 等模型除了基于边界框的定位,还支持基于点的指代。
无 OCR 的文档理解
-
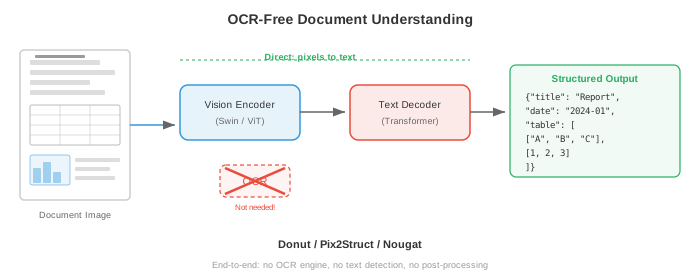
传统文档理解流水线很复杂:先跑 OCR 引擎抽文字和版式,再把抽出来的文字喂给语言模型。 这种多阶段做法很脆弱 —— OCR 错误会向下游传播,空间版式信息也常常丢失或表示得很糟。 如果模型能像人一样直接从像素读文字呢?
-
Donut (Document Understanding Transformer, Kim 等,2022) 彻底扔掉了 OCR. 它用 Swin Transformer (第 8 章) 作视觉编码器处理文档图像,用一个 BART 风格的 Transformer 解码器直接从视觉特征生成结构化文本输出。 解码器可以按任务需求产出 JSON、键值对或纯文本。
-
Donut 的训练分两阶段。 预训练:模型通过做合成 OCR 学会 "读" —— 给一张文档图,生成它的全部文本内容。 训练数据是从文本语料渲染出的数百万合成文档图像,让视觉编码器认字符、字体和版式。 微调:模型适配到收据解析、表单理解、文档分类等具体下游任务,训练它生成任务特定的结构化输出。
-
Donut 解码器用一种特别的提示方案:任务由一个提示 Token 指定 (例如分类用
<doc_class>,收据解析用<parse_receipt>),模型基于这个提示生成输出。 这种统一接口让一个模型能处理多种文档理解任务。 -
Pix2Struct (Lee 等,2023, Google) 把无 OCR 的思路推广到网页理解和图表/图形理解。 关键的预训练目标是截图解析:给一张网页的被遮挡截图,模型要生成可见区域对应的 HTML 代码。 这让模型学会视觉渲染与结构化标记之间的关系。
-
Pix2Struct 引入了可变分辨率输入处理:不再把所有图像缩到固定尺寸 (那会扭曲宽高比、毁掉细小文字),而是在保留原始宽高比的前提下,把图像打包成固定数量的图块。 又高又窄的文档就产出又高又窄的图块网格。 这对文档理解至关重要,因为宽高比本身携带语义信息 (收据窄而高,表格宽而短).
-
Nougat (Blecher 等,2023, Meta) 把 Donut 架构专门用于学术论文,直接从 PDF 页面图像生成完整的 LaTeX 标记。 它能处理复杂数学公式、表格和插图 —— 传统 OCR 流水线在这些任务上表现很差。 模型在 PDF 页面图像和对应 LaTeX 源码的配对上训练。
-
无 OCR 模型的成功说明了深度学习的一个更广泛的原则:直接从原始输入 (像素) 学习的端到端模型往往比复杂的多阶段流水线表现更好,因为它可以联合优化所有组件,学到专门为最终任务定制的表示。 中间那步 OCR 是个瓶颈,限制了模型能学到什么。
视觉 Token 流水线
-
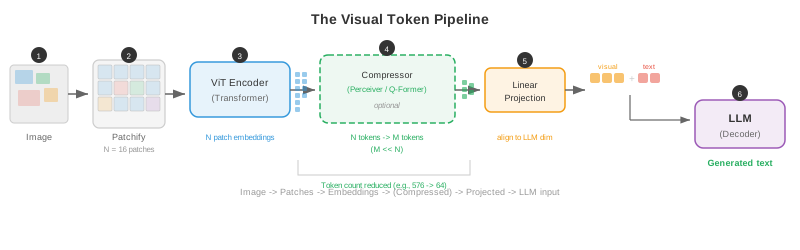
不管属于哪种架构家族,每个 VLM 都得把图像转成一序列 Token,让语言模型能处理。 弄清这条流水线很关键。 具体过程因模型而异,但整体流程如下:
-
第 1 步:图块提取. 把图像 (高 \(H\),宽 \(W\)) 切成不重叠的 \(P \times P\) 图块,产出 \(N = HW / P^2\) 个图块。 336x336 图像配 14x14 图块,就得到 \(N = 576\) 个。
-
第 2 步:视觉编码. 每个图块先线性投影再过视觉编码器 (通常是 ViT). 输出是一序列上下文化的图块嵌入 \(V = [v_1, \ldots, v_N] \in \mathbb{R}^{N \times d_v}\). 这些嵌入既携带局部外观信息,也 (通过自注意力) 携带全局上下文。
-
第 3 步:Token 压缩 (可选). 一些模型把 \(N\) 个视觉 Token 压成更少的 \(M \ll N\) 个,好给语言模型减负。 Flamingo 用 Perceiver Resampler (\(M = 64\)); Qwen-VL 用交叉注意力 (\(M = 256\)); Q-Former (BLIP-2 里用,Li 等,2023) 用 \(M = 32\) 个可学习查询 Token,通过交叉注意力吸收视觉编码器输出。
-
第 4 步:投影. 视觉 Token (无论压缩前后) 通过一个线性层或 MLP 投影到语言模型的嵌入空间。 投影后,视觉 Token 就和文本 Token 嵌入维度一致,可以直接拼接。
-
第 5 步:注入到 LLM. 投影后的视觉 Token 被插到 Token 序列中一个特殊的
<image>占位 Token 位置,组合后的序列由语言模型处理。 LLM 的自注意力让文本 Token 能注意视觉 Token,反之亦然。
-
视觉 Token 的数量直接决定计算开销。 每个视觉 Token 都要参与 LLM 的自注意力,而自注意力的复杂度是序列长度的平方。 一张高分辨率图像切下来的图块可能是几百到几千,直接占爆 LLM 的上下文窗口。 所以 Token 压缩很重要:把 576 个视觉 Token 压到 64 个,视觉部分对注意力的贡献大约减少 9 倍。
-
BLIP-2 (Li 等,2023) 的桥接策略特别高效。 它引入了一个轻量的 Q-Former (一个带可学习查询的小 Transformer),夹在冻结的视觉编码器和冻结的 LLM 之间。 Q-Former 是唯一可训练的部分 —— 视觉编码器和 LLM 都保持冻结。 它分两阶段预训练:先用图文对比、匹配、图像描述目标 (对接视觉编码器),再用语言生成目标 (对接 LLM). 这种模块化设计让 BLIP-2 可以把任意视觉编码器和任意 LLM 组合起来。
训练目标
-
根据架构范式的不同,VLM 用多种目标组合训练:
-
图文对比损失 (image-text contrastive loss, ITC): 让图像表示与文本表示在共享嵌入空间中对齐,就像 CLIP. 这是双编码器的主要目标,也常作为融合模型的预训练目标之一。 损失就是上一节介绍的 InfoNCE 损失。
-
图文匹配 (image-text matching, ITM): 一个二分类目标 —— 给一张图和一段文本,预测它们是否匹配。 用难负样本 (语义相似但配了别的图的文本) 能把这任务变难,逼模型学会细粒度对齐。
-
语言建模 (language modelling, LM): 就是标准的自回归语言建模目标 —— 给定所有前文 Token,预测下一个。 对 VLM 而言,"前文 Token" 里包含视觉 Token,所以模型学会在视觉输入条件下生成文本。 这是编码器-解码器和仅解码器 VLM 的主要目标。
-
前缀语言建模 (prefix language modelling): LM 的一种变体,图像和一段文本前缀作为上下文 (不计损失),模型只训练生成延续部分。 PaLI、SimVLM 等模型用它。
-
大多数现代 VLM 在预训练时组合多个目标 (例如 BLIP 里的 ITC + ITM + LM, CoCa 里的 ITC + LM),再在指令数据上用纯 LM 目标微调。
编程任务 (用 CoLab 或 notebook)
-
实现一个简单的、基于注意力的图像描述解码器。 用随机 "图像特征" 作为编码器输出,训练解码器生成一个固定描述,观察每个解码步的注意力权重在空间位置上如何移动。
import jax import jax.numpy as jnp import matplotlib.pyplot as plt # 模拟一个 4x4 空间网格的图像特征 (16 个区域, 每个 32 维) key = jax.random.PRNGKey(42) k1, k2, k3 = jax.random.split(key, 3) img_features = jax.random.normal(k1, (16, 32)) # 16 个空间区域, 32 维 # 词表: 0=<start>, 1="a", 2="red", 3="car", 4=<end> vocab_size, embed_dim, hidden_dim = 5, 16, 32 W_embed = jax.random.normal(k2, (vocab_size, embed_dim)) * 0.1 W_attn_q = jax.random.normal(k3, (hidden_dim, 32)) * 0.1 # 查询投影 def attend(h, img_feats, W_q): """给定解码器状态 h, 在图像特征上算软注意力.""" query = h @ W_q # (32,) scores = img_feats @ query # (16,) weights = jax.nn.softmax(scores) # (16,) context = weights @ img_feats # (32,) return context, weights # 简单的类 GRU 单步 (演示用, 就是一个线性 + tanh) W_h = jax.random.normal(jax.random.PRNGKey(0), (embed_dim + 32, hidden_dim)) * 0.1 def decode_step(h, word_idx, img_feats): context, attn_weights = attend(h, img_feats, W_attn_q) word_emb = W_embed[word_idx] # (16,) inp = jnp.concatenate([word_emb, context]) # (48,) h_new = jnp.tanh(inp @ W_h) # (32,) return h_new, attn_weights # 按序列解码: <start> -> "a" -> "red" -> "car" -> <end> target_seq = [0, 1, 2, 3, 4] h = jnp.zeros(hidden_dim) all_attn = [] for word_idx in target_seq[:-1]: h, attn_w = decode_step(h, word_idx, img_features) all_attn.append(attn_w) # 可视化每步的注意力图 (reshape 成 4x4 网格) words = ["<start>", "a", "red", "car"] fig, axes = plt.subplots(1, 4, figsize=(14, 3)) for i, (ax, w) in enumerate(zip(axes, words)): ax.imshow(all_attn[i].reshape(4, 4), cmap='viridis') ax.set_title(f'Attending when\ngenerating after "{w}"') ax.axis('off') plt.suptitle('Attention Over Image Regions at Each Decoding Step') plt.tight_layout(); plt.show() # 试试改 img_features 看注意力模式怎么变! -
模拟视觉 Token 流水线:把图像切成图块、投影到嵌入空间、和文本 Token 嵌入拼接,再在合并后的序列上跑一层自注意力。
import jax import jax.numpy as jnp import matplotlib.pyplot as plt key = jax.random.PRNGKey(7) # 造一张 8x8、3 通道的合成 "图像" k1, k2, k3, k4 = jax.random.split(key, 4) image = jax.random.uniform(k1, (8, 8, 3)) # 第 1 步: 切成 4x4 图块 -> 4 个图块 patch_size = 4 patches = image.reshape(2, patch_size, 2, patch_size, 3) patches = patches.transpose(0, 2, 1, 3, 4).reshape(4, patch_size * patch_size * 3) # (4, 48) print(f"Number of patches: {patches.shape[0]}, patch dim: {patches.shape[1]}") # 第 2 步: 把图块投影到嵌入维度 (d=16) d_model = 16 W_patch = jax.random.normal(k2, (patches.shape[1], d_model)) * 0.1 visual_tokens = patches @ W_patch # (4, 16) # 第 3 步: 构造文本 Token 嵌入 (模拟 3 个文本 Token) text_tokens = jax.random.normal(k3, (3, d_model)) * 0.1 # 第 4 步: 拼接视觉 + 文本 Token combined = jnp.concatenate([visual_tokens, text_tokens], axis=0) # (7, 16) print(f"Combined sequence length: {combined.shape[0]} (4 visual + 3 text)") # 第 5 步: 在合并序列上跑单头自注意力 W_Q = jax.random.normal(k4, (d_model, d_model)) * 0.1 k5, k6 = jax.random.split(k4) W_K = jax.random.normal(k5, (d_model, d_model)) * 0.1 W_V = jax.random.normal(k6, (d_model, d_model)) * 0.1 Q = combined @ W_Q K = combined @ W_K V = combined @ W_V attn_scores = (Q @ K.T) / jnp.sqrt(d_model) attn_weights = jax.nn.softmax(attn_scores, axis=-1) # (7, 7) output = attn_weights @ V # (7, 16) # 可视化跨模态的注意力模式 labels = ['V1', 'V2', 'V3', 'V4', 'T1', 'T2', 'T3'] fig, ax = plt.subplots(figsize=(6, 5)) im = ax.imshow(attn_weights, cmap='Blues') ax.set_xticks(range(7)); ax.set_xticklabels(labels) ax.set_yticks(range(7)); ax.set_yticklabels(labels) ax.set_xlabel('Key'); ax.set_ylabel('Query') ax.set_title('Self-Attention: Visual (V) and Text (T) Tokens') plt.colorbar(im, ax=ax); plt.tight_layout(); plt.show() # 观察: 文本 Token 会关注视觉 Token (跨模态注意力)! -
实现视觉定位里的坐标 Token 化。 给定边界框,把它转成离散 Token;给定离散 Token,重建边界框。 可视化不同 bin 分辨率下的量化误差。
import jax.numpy as jnp
import matplotlib.pyplot as plt

def encode_bbox(bbox, num_bins=1000):
    """把 [0,1] 内的连续 bbox (x, y, w, h) 转成离散 Token."""
    tokens = jnp.round(jnp.array(bbox) * (num_bins - 1)).astype(jnp.int32)
    return tokens

def decode_bbox(tokens, num_bins=1000):
    """把离散 Token 转回连续 bbox."""
    return tokens.astype(jnp.float32) / (num_bins - 1)

# 真值边界框 (归一化到 [0, 1])
gt_bbox = jnp.array([0.123, 0.456, 0.333, 0.222])

# 在不同 bin 分辨率下测试量化
bin_sizes = [10, 50, 100, 500, 1000]
errors = []
for n_bins in bin_sizes:
    tokens = encode_bbox(gt_bbox, n_bins)
    reconstructed = decode_bbox(tokens, n_bins)
    error = jnp.max(jnp.abs(gt_bbox - reconstructed))
    errors.append(float(error))
    print(f"Bins={n_bins:>5d} | Tokens={tokens} | "
          f"Reconstructed={reconstructed} | Max error={error:.6f}")

fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(bin_sizes, errors, 'o-', color='#e74c3c', linewidth=2, markersize=8)
ax.set_xlabel('Number of Bins'); ax.set_ylabel('Max Quantisation Error')
ax.set_title('Bounding Box Quantisation Error vs Bin Resolution')
ax.set_xscale('log'); ax.set_yscale('log')
ax.grid(True, alpha=0.3); plt.tight_layout(); plt.show()
# 试试: bin 非常少 (比如 5) 会怎样? 误差多低才可接受?
📌 本节要点
- 视觉语言模型 (VLM):把视觉编码器与语言模型缝合起来,联合处理图像和文本,统一支撑描述、问答、定位等任务。
- VQA:给定图像和问题输出答案,VQA v2 通过配对相似图像消除语言先验捷径。
- 图像描述:从 Show and Tell 的单向量编码,演进到 Show, Attend and Tell 的空间注意力,再到基于自底向上区域特征的描述。
- 双编码器:图文各自独立编码到共享空间,适合大规模检索,CLIP 是代表;缺点是无法做细粒度跨模态推理。
- 融合编码器:通过交叉注意力让文本 Token 精细关注图像区域,适合细粒度理解,但每对图文都要跑完整前向。
- 编码器-解码器 / 仅解码器:天然适合生成式任务,现代 SOTA VLM 越来越倾向把所有任务当文本生成来做。
- Flamingo:冻结视觉编码器与 LLM,只学 Perceiver Resampler 和门控交叉注意力,门 \(\alpha\) 从 0 逐步打开,支持图文交错的少样本学习。
- LLaVA:用一个线性投影把 CLIP 视觉特征映射到 LLM 嵌入空间,再做视觉指令微调,简单粗暴但极其有效,成为开源 VLM 的通用配方。
- 规模化家族 (PaLI / Qwen-VL / InternVL):分别代表视觉编码器扩容、动态分辨率、动态高分辨率瓦片三条路线;训练数据从噪声网络对逐步精修到高质量指令数据。
- 坐标 Token 化:把边界框离散成词表里的
<loc_*>Token,让自回归 LLM 不改架构就能做视觉定位与短语落地。 - 无 OCR 文档理解: Donut / Pix2Struct / Nougat 直接从像素生成结构化输出,联合优化胜过多阶段 OCR 流水线。
- 视觉 Token 流水线:图块 → ViT 编码 → 可选压缩 (Perceiver / Q-Former) → 投影 → 与文本 Token 拼接注入 LLM; Token 数量直接决定注意力的平方开销。
- 训练目标组合:图文对比 (ITC)、图文匹配 (ITM)、语言建模 (LM)、前缀 LM 常混合使用,现代 VLM 多在预训练混合目标后,用纯 LM 目标做指令微调。