服务与批处理
一句话总结:服务大模型不只是加载权重跑推理,而是要靠 prefill/decode 拆分、连续批处理、PagedAttention、调度与路由把 GPU 利用率榨干,才能在低延迟下扛住上万并发。
把大语言模型服务给上千并发用户,光把模型加载起来跑推理是不够的。 本节讨论 prefill/decode 拆分、连续批处理、PagedAttention 与 vLLM、调度策略、分离式服务、多模型与 LoRA 服务,以及真正重要的那些指标.
- 单次大语言模型 (Large Language Model, LLM) 推理请求本身很简单:输入 token,生成输出 token. 但要把一个 LLM 服务给 10,000 个并发用户,同时保证低延迟和高吞吐,这就是一个系统问题了。 朴素做法 (一次处理一个请求) 会浪费 90% 以上的 GPU 算力。 聪明的批处理和调度可以在不加硬件的前提下把吞吐提升 10-50 倍。
Prefill 与 Decode:两个截然不同的阶段
-
LLM 推理有两个计算特征截然不同的阶段:
-
Prefill (提示词处理):同时处理所有输入 token. 这是一次大规模矩阵乘法:\(O(\text{prompt\_length} \times d_{\text{model}}^2)\). 提示词可以并行处理 (所有 token 都已知). Prefill 是计算受限的:瓶颈在 GPU 的算术逻辑单元 (Arithmetic Logic Unit, ALU).
-
Decode (token 生成):一次生成一个 token,自回归地进行。 每生成一个新 token 都要通过 KV 缓存 (KV cache) 关注所有之前的 token. Decode 是内存带宽受限的:GPU 大部分时间都在从内存里加载模型权重和 KV 缓存,而不是在算。 每一步 decode 只产出一个 token,却必须把整个模型都加载一遍 (70B 模型在 FP16 下大约 140 GB).
-
这意味着:
| Prefill | Decode | |
|---|---|---|
| Token 处理方式 | 一次全部 (并行) | 一次一个 (串行) |
| 瓶颈 | 计算 (FLOPS) | 内存带宽 |
| 算术强度 | 高 | 极低 |
| GPU 利用率 | 高 (50-80%) | 无批处理时很低 (1-10%) |
| 延迟指标 | 首 token 时延 (Time to First Token, TTFT) | 每 token 输出时延 (Time Per Output Token, TPOT) |
- TTFT 关系到用户体验 (响应开始流式输出前要等多久). TPOT 决定了用户感受到的生成速度。 用户能容忍较高的 TTFT (1-5 秒),但期望 TPOT 很快 (对话应用要求每 token 30-100 毫秒).
静态批处理 (朴素做法)
-
最简单的批处理方式:收集 \(B\) 个请求,把它们填充到相同长度,作为一个批次一起处理。
-
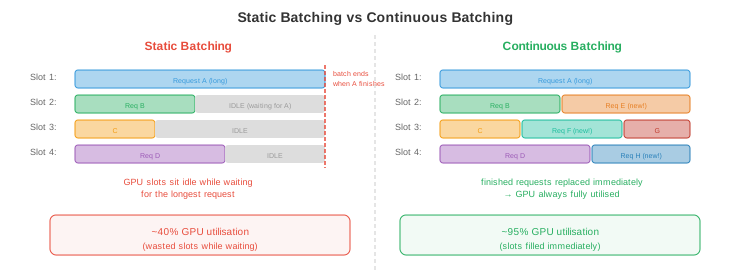
问题 1:请求的提示词长度不一样,生成的输出 token 数也不一样。 短请求提前跑完,但必须等这批里最长的那个请求跑完,下一批才能开始。 GPU 就在那儿闲着,只为最后剩下的那个长请求继续生成。
-
问题 2:填充浪费算力。 如果最长的提示词是 2000 token,最短的只有 50,整个批次都要填充到 2000. GPU 得替短请求处理 1950 个填充 token —— 纯浪费。
连续批处理
-
连续批处理 (continuous batching) (也叫迭代级批处理) 通过在单步 decode 的粒度上运作 (而不是整个请求) 来同时解决这两个问题。
-
每一步 decode 时:
- 所有正在处理的请求并行生成一个 token (作为一个批次).
- 完成的请求 (生成 EOS token 的) 立即从批次中移除.
- 队列里的新请求立即插入被腾出的槽位。
-
批次大小每一步都在动态变化。 GPU 从不因等落伍者而空闲,也没有浪费的填充 (每个请求只占它需要的槽位).
-
效果:连续批处理相比静态批处理通常能把吞吐提升 2-10 倍,而且不影响模型质量,也不显著增加延迟。
PagedAttention 与 vLLM
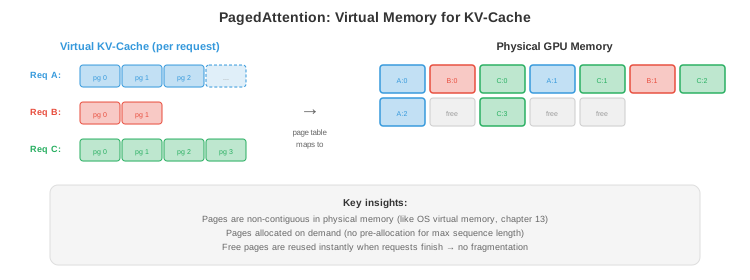
- KV 缓存带来了一个内存管理噩梦。 每个请求都有一个随生成 token 增长的 KV 缓存。 不同请求处于不同阶段 (缓存大小不同). 给每个请求分配连续内存会浪费空间 (必须按最大可能长度分配,就算这个请求只生成几个 token).
-
PagedAttention (Kwon et al., 2023) 把操作系统里的虚拟内存概念 (见第 13 章) 应用到 KV 缓存上。 缓存被切成固定大小的页 (page,一块 token 位置的连续区). 页按需分配,在物理 GPU 内存里可以是不连续的。
-
好处:
- 无碎片:页大小统一,所以请求之间不会留下"空洞"式的内存浪费。
- 懒分配:只在 token 真正生成时才分配内存,而不是预先按最大长度分配。
- 写时复制 (copy-on-write):共享同一前缀的请求 (比如相同的系统提示词) 共享同一批 KV 缓存页。 只有当请求开始出现分歧时,页才会被复制。
-
vLLM 是围绕 PagedAttention 构建的推理引擎。 通过几乎彻底消除 KV 缓存的内存浪费,它比静态分配的服务方案 (比如没有 paged attention 的 HuggingFace text-generation-inference) 吞吐高 2-4 倍。
SGLang 与 RadixAttention
-
vLLM 的 PagedAttention 解决了页级碎片,但没解决跨请求的前缀共享问题。 现实里大量请求共享公共前缀:同一个系统提示词、少样本示例、代理循环里的对话历史、树搜索里的分支。 每次都重算这段前缀的 KV 缓存,就是纯浪费。
-
SGLang (Zheng et al., 2023) 引入 RadixAttention:把所有活跃请求的 KV 缓存组织成一棵基数树 (radix tree). 每个节点是一段 token 序列,共享前缀的请求走同一条路径;分叉发生在第一个不同的 token. 命中时直接复用已缓存的 KV,免去 prefill 的重算。
-
与 vLLM 前缀缓存的差别:vLLM 的 copy-on-write 是页粒度的静态共享 (相同的 KV 页去重),且缓存生命周期与请求绑定;RadixAttention 是跨请求持久化的树结构,配上最近最少使用 (Least Recently Used, LRU) 淘汰策略,后到的请求可以直接命中前面请求留下的前缀缓存,命中率显著更高。
-
结构化生成 (structured generation): SGLang 把 Outlines 那种 FSM 掩码思路做了两项优化 —— (1) 压缩 FSM:遇到 JSON 里
"key":这种固定文本,一次前进多个字符而不是一次一个 token; (2) 跳跃前进 (jump-forward decoding):当 FSM 只允许唯一后继 token 时,直接跳过采样步骤。 两者叠加,让结构化输出对 TPOT 的开销从 20-40% 降到接近零,同时与 RadixAttention 复用相同的前缀缓存。 -
适用场景:代理循环 (每步共享历史)、少样本推理 (共享示例前缀)、束搜索 / 思维树 (共享父节点),相比 vLLM 通常吞吐再翻 1.5-5 倍。
TensorRT-LLM:从 v0.x 到 v1.x
-
TensorRT-LLM 是 NVIDIA 官方的推理引擎,走的是"编译到 CUDA 核函数 + 深度优化"路线,单卡吞吐通常比 vLLM 更高,但历史上门槛也更高。
-
v0.x 时代 (2023-2024):以 C++ 运行时为核心,Python 侧只是薄壳。 每换一个模型或改一处配置,都要重新编译引擎 (engine build),产出一个针对特定 GPU、特定并行度、特定最大序列长度的二进制文件。 好处是极致性能 (定制核函数、TensorRT 图优化),代价是迭代慢、调试难、动态形状支持弱。
-
v1.x (2025):引入 PyTorch 原生后端 (PyTorch backend) 作为默认路径,免去大部分预编译步骤 —— 模型直接从 HuggingFace 权重加载即可跑。 同时暴露高层 LLM API (类似 vLLM 的 Python 接口),让"下载权重 → 起服务"从几个小时缩到几分钟。 老的 C++ TensorRT 引擎路径仍保留,用于对性能有极限要求的生产部署。
-
其他关键变化:分块预填充 (chunked prefill) 与运行中批处理 (in-flight batching) 成为默认;KV 缓存复用与前缀缓存原生支持;推测解码 (speculative decoding) 接口标准化;对 FP8 / NVFP4 等低精度格式的支持从实验特性升级到一等公民 (见第 17 章第 2 节).
-
选型直觉:追求生态与易用 → vLLM;追求前缀复用与代理场景吞吐 → SGLang;追求单机极限性能且能忍受 NVIDIA 生态锁定 → TensorRT-LLM v1.x.
调度策略
-
当多个请求在等而 GPU 只能处理有限的批次时,调度决定优先服务哪些请求:
-
先到先服务 (First Come First Served, FCFS):按到达顺序处理。 简单但不公平:提交 10K token 生成任务的用户会把后面所有用户都堵住。
-
最短作业优先 (Shortest Job First, SJF):优先处理最快能跑完的请求。 平均延迟最小,但会惩罚长请求 (可能饿死). 实际中输出长度是未知的,所以 SJF 靠启发式 (提示词长度,用户历史) 来估。
-
抢占 (Preemption):如果来了一个高优先级请求,就暂停一个低优先级的在跑请求 (把它的 KV 缓存换出到 CPU 内存或 SSD),服务高优先级请求,然后再恢复被暂停的那个。 vLLM 支持这个。
-
基于优先级 (Priority-based):给用户或请求类型分配优先级。 实时交互查询的优先级高于批处理作业。 结合抢占,就能保证高优先级流量的延迟服务等级目标 (Service Level Objective, SLO).
-
Token 预算:限制活跃批次里的总 token 数。 这可以防止几个长请求垄断 GPU 内存、饿死新请求。
分离式服务
-
Prefill 和 decode 的计算特性正好相反。 把两者放在同一个 GPU 上跑,意味着这个 GPU 在计算受限 (prefill) 和内存带宽受限 (decode) 之间来回切换,哪一种资源都用不满。
-
分离式服务 (Disaggregated serving) 把它们分开:
- Prefill 节点:面向计算优化的 GPU (高 FLOPS,内存可以少一点). 负责处理所有传入的提示词。
- Decode 节点:面向内存带宽优化的 GPU (大 KV 缓存容量,高内存带宽). 负责所有 token 生成。
-
Prefill 节点算出初始 KV 缓存,通过 NVLink 或网络发送给 decode 节点。 Decode 节点用收到的缓存生成 token.
-
这就是 Mooncake (月之暗面) 的架构,也有多个 LLM 服务团队在探索。 好处:每种 GPU 都匹配自己的工作负载特性,整体利用率上去了。
多模型与 LoRA 服务
-
生产环境里往往要同时服务多个模型 (不同档位不同大小,不同任务不同微调变体).
-
模型复用 (Model multiplexing):在同一个 GPU 上加载多个模型,把请求路由到合适的模型。 GPU 内存共享:一张 40 GB 的 GPU 可以同时装下 13B (26 GB) 和 7B (14 GB) 两个模型。
-
LoRA 服务:与其部署多个独立的微调模型,不如部署一个基础模型 + 多个低秩适配 (Low-Rank Adaptation, LoRA) 适配器 (见第 6 章). 每个适配器增加不到 1% 的参数。 推理时把请求路由到合适的适配器。
-
S-LoRA (Sheng et al., 2023):用一个基础模型服务上千个 LoRA 适配器。 适配器存在 CPU 上,按需分页到 GPU 内存。 基础模型的 KV 缓存和权重共享;每个请求只有那点小小的 LoRA 矩阵不同。
-
Punica (Chen et al., 2023):通过一个定制的 CUDA 核函数,在同一批次内把不同 LoRA 矩阵应用到不同请求上,从而实现跨适配器的批处理。 这样就避免了每个请求都要切换适配器的开销。
约束生成与引导生成
-
很多应用需要 LLM 产出特定格式:合法 JSON、SQL 查询、某种特定语言的代码,或者符合某个模式 (schema) 的响应。 约束生成 (Constrained generation) 保证输出符合某个语法或模式。
-
语法约束解码:每一步解码时,把违反语法的 token 掩掉。 如果目前的输出是
{"name": "Alice", "age":而语法要求下一个是整数,就把除数字之外的所有 token 都掩掉。 LLM 的概率分布会在合法 token 上重新归一化。 -
Outlines (Willard & Louf, 2023):把 JSON 模式或正则表达式编译成一个有限状态机 (Finite-State Machine, FSM). 每一步解码时,FSM 决定哪些 token 是合法的后续。 非法 token 的概率被置为 0. 这样零重试就能 100% 保证模式合规。
-
SGLang 原生集成了约束生成:用压缩 FSM 与跳跃前进解码,把结构化输出的 TPOT 开销压到接近零,同时与 RadixAttention 前缀缓存共享复用 (详见"SGLang 与 RadixAttention"一节).
-
为什么重要:没有约束生成的话,你只能自由生成然后解析输出,失败就重试。 复杂 JSON 模式的重试率经常在 10-30%,浪费算力。 约束生成彻底消除了重试。
请求路由
-
不是每个查询都得用最大的模型。 请求路由 (Request routing) 根据估计的难度把查询导向不同的模型:
-
级联 (Cascading):先试小模型。 如果小模型的置信度低于阈值 (比如 top token 的 softmax 概率 < 0.8),就升级到更大的模型。 简单查询 (80%+ 的流量) 由小模型便宜地服务;只有难查询才用贵的模型。
-
学习式路由 (Learned routing):训练一个轻量分类器 (或利用小模型的困惑度) 来预测某个查询该走哪个模型档位。 把 "2+2 等于几?" 路由到 3B 模型,把 "解释一下量子纠缠的数学基础" 路由到 70B 模型。
-
效果:如果 80% 的查询能被一个便宜 10 倍的模型处理,平均每查询成本降大约 70%. 这是多模型部署里最能省钱的优化之一。
-
端侧 + 云端混合路由: Cactus (github.com/cactus-compute/cactus) 在设备层面实现了请求路由。 它通过定制的 ARM 单指令多数据 (Single Instruction Multiple Data, SIMD) 核函数,在设备 (手机、笔记本、可穿戴设备) 上跑一个小模型,当本地模型置信度低或查询超出设备能力时,自动路由到云端模型。 应用两条路径都用 OpenAI 兼容的应用程序接口 (Application Programming Interface, API) —— 路由对上层透明。 这就是基础设施层面的级联:第一档免费 (端侧),第二档花钱 (云端 API). 对于查询大多简单的应用 (助手问答、自动补全、转写),端侧处理覆盖 70-90% 的流量,边际成本为零。
推理指标
- 该看哪些指标,取决于使用场景:
| 指标 | 衡量什么 | 目标 (对话式) | 目标 (批处理) |
|---|---|---|---|
| TTFT | 首 token 时延 | <1 秒 | 不重要 |
| TPOT | 每 token 输出时延 | <100 毫秒 | 不重要 |
| 吞吐 (Throughput) | Token/秒 (总) | 不重要 | 拉满 |
| p99 延迟 | 最差 1% 的请求 | <5 秒 | <30 秒 |
| 每 token 成本 | $/100 万 token | 最小化 | 最小化 |
| SLO 达标率 | 满足延迟目标的请求占比 | >99% | >95% |
-
TTFT 与 TPOT 的权衡:激进的批处理提升吞吐 (总 tokens/s 更多),但拉高 TPOT (每 token 更慢,因为 GPU 同时处理更多请求). 调度策略必须在吞吐 (收入) 与延迟 (用户体验) 之间取舍。
-
每 token 成本是生产环境的终极指标。 它综合了硬件成本 (GPU 租金)、吞吐 (tokens/s) 与利用率。 一套 GPU 利用率 50% 的系统,每 token 成本是 100% 利用率的 2 倍。 这就是为什么批处理、调度和 PagedAttention 这么关键 —— 它们把利用率提上去了。
编程练习 (使用 Colab 或 notebook)
-
模拟连续批处理与静态批处理,测吞吐差异。
import random import time def simulate_static_batching(requests, batch_size=8): """按固定批次处理请求. 等所有请求完成.""" total_tokens = 0 total_time = 0 for i in range(0, len(requests), batch_size): batch = requests[i:i + batch_size] max_len = max(r['output_len'] for r in batch) # 批次内所有请求都要跟最长的一起等 batch_time = max_len * 0.01 # 每 token 10 毫秒 total_time += batch_time total_tokens += sum(r['output_len'] for r in batch) return total_tokens / total_time # 每秒 token 数 def simulate_continuous_batching(requests, max_batch=8): """连续批处理: 移除完成的, 加入新的.""" total_tokens = 0 total_time = 0 active = [] queue = list(requests) while active or queue: # 填满批次 while len(active) < max_batch and queue: active.append({'remaining': queue.pop(0)['output_len']}) if not active: break # 一步 decode: 所有活跃请求各生成 1 个 token for req in active: req['remaining'] -= 1 total_tokens += len(active) total_time += 0.01 # 每步 10 毫秒 # 移除完成的请求 active = [r for r in active if r['remaining'] > 0] return total_tokens / total_time # 生成不同输出长度的请求 random.seed(42) requests = [{'output_len': random.randint(10, 500)} for _ in range(100)] static_tps = simulate_static_batching(requests) continuous_tps = simulate_continuous_batching(requests) print(f"Static batching: {static_tps:.0f} tokens/s") print(f"Continuous batching: {continuous_tps:.0f} tokens/s") print(f"Speedup: {continuous_tps / static_tps:.1f}x") -
计算 PagedAttention 节省的 KV 缓存内存。 对比预分配 (最坏情况) 与分页 (实际使用).
def paged_vs_preallocated(n_requests, max_seq_len, avg_seq_len, page_size, kv_per_token_bytes):
    """对比内存用量: 预分配 vs 分页 KV 缓存."""
    # 预分配: 每个请求都拿到 max_seq_len 个槽位
    preallocated_gb = n_requests * max_seq_len * kv_per_token_bytes / 1e9

    # 分页: 只分配实际用到的 (按页粒度)
    import math
    avg_pages = math.ceil(avg_seq_len / page_size)
    paged_gb = n_requests * avg_pages * page_size * kv_per_token_bytes / 1e9

    waste_preallocated = (max_seq_len - avg_seq_len) / max_seq_len
    waste_paged = (avg_pages * page_size - avg_seq_len) / (avg_pages * page_size)

    print(f"Requests: {n_requests}, Max seq: {max_seq_len}, Avg seq: {avg_seq_len}")
    print(f"  Preallocated: {preallocated_gb:.1f} GB (waste: {waste_preallocated:.0%})")
    print(f"  Paged:        {paged_gb:.1f} GB (waste: {waste_paged:.0%})")
    print(f"  Savings:      {preallocated_gb - paged_gb:.1f} GB ({preallocated_gb/paged_gb:.1f}x)")
    print()

# Llama-70B: 每 token 每层约 1.3 KB, 80 层 = 每 token 总共约 100 KB
kv_bytes = 100_000

# 场景 1: 短请求, 大 max
paged_vs_preallocated(256, max_seq_len=4096, avg_seq_len=256, page_size=16, kv_per_token_bytes=kv_bytes)

# 场景 2: 长度参差
paged_vs_preallocated(256, max_seq_len=8192, avg_seq_len=1024, page_size=16, kv_per_token_bytes=kv_bytes)

# 场景 3: 长上下文
paged_vs_preallocated(64, max_seq_len=131072, avg_seq_len=16000, page_size=16, kv_per_token_bytes=kv_bytes)
📌 本节要点
- Prefill 与 Decode 特性相反: prefill 计算受限,decode 内存带宽受限;两者关注的延迟指标分别是 TTFT 与 TPOT.
- 静态批处理浪费严重:需等最长请求跑完才能进下一批,填充也消耗算力,GPU 利用率低。
- 连续批处理:在单步 decode 粒度上动态增删请求,消除等待与填充浪费,吞吐可提升 2-10 倍。
- PagedAttention:把 KV 缓存像操作系统虚拟内存那样分页管理,无碎片、懒分配、支持前缀共享。
- vLLM:围绕 PagedAttention 构建,吞吐比静态分配方案高 2-4 倍。
- SGLang 与 RadixAttention:用基数树跨请求持久化前缀 KV 缓存,命中率显著高于 vLLM 的页级 copy-on-write;结构化生成通过压缩 FSM 与跳跃前进把 TPOT 开销压到近零。
- TensorRT-LLM v1.x:引入 PyTorch 原生后端与高层 LLM API,免去 v0.x 时代的引擎预编译步骤;分块预填充、前缀缓存、FP8/NVFP4 均升级为一等公民。
- 调度策略: FCFS 简单但不公,SJF 平均延迟低但可能饿死长请求,抢占与优先级保障 SLO, token 预算防止内存独占。
- 分离式服务: prefill 与 decode 分部署在不同 GPU,让每种硬件匹配各自工作负载,提升整体利用率 (代表:Mooncake).
- LoRA 服务:一个基础模型加载多适配器,S-LoRA 与 Punica 可在单批次里高效服务上千 LoRA 变体。
- 约束生成: FSM 或语法在解码时掩掉非法 token,零重试保证 100% 模式合规 (Outlines / SGLang).
- 请求路由:级联与学习式路由把简单查询导向小模型,端云混合让 70-90% 流量在设备侧零边际成本处理;每 token 成本才是生产终极指标。