概率概念
一句话总结:概率论用一套形式化规则量化不确定性,涵盖样本空间、事件、公理、条件概率、独立性与贝叶斯定理,是所有生成式与判别式 ML 模型背后的数学骨架。
概率论把不确定性形式化,给出在不确定环境下推理的规则。本节讲样本空间、事件、概率公理、条件概率、独立性、贝叶斯定理,以及频率派与贝叶斯派两种解释——这套框架撑起了机器学习里每一个生成式与判别式模型。
-
概率给一个事件分配 0 到 1 之间的一个数,用来度量它发生的可能性。
-
概率为 0 表示不可能,1 表示必然,0.5 表示像抛一枚公平硬币那样五五开。
-
主要有两种解释。频率派 (frequentist) 认为概率是长期相对频率:抛一枚公平硬币 10,000 次,正面大约占 50%。
-
贝叶斯派 (Bayesian) 认为概率是一种信念强度:你可以说"明天下雨的概率是 70%",即便明天只发生一次。
-
两种解释用的是同一套数学规则。差别是哲学层面的,但在 ML 里很重要。频率派方法给你点估计,贝叶斯派方法给你参数上的完整分布。
-
样本空间 (sample space) \(S\) 是一次实验所有可能结果的集合。抛硬币:\(S = \{H, T\}\)。掷骰子:\(S = \{1, 2, 3, 4, 5, 6\}\)。
-
事件 (event) 是样本空间的任意子集。"掷出偶数"就是事件 \(A = \{2, 4, 6\}\),它是 \(S\) 的一个子集。
-
当所有结果等可能时,事件的概率就是简单的数数 (回顾第 01 节):
- 拿偶数例子来说:\(P(\text{even}) = \frac{3}{6} = 0.5\)。
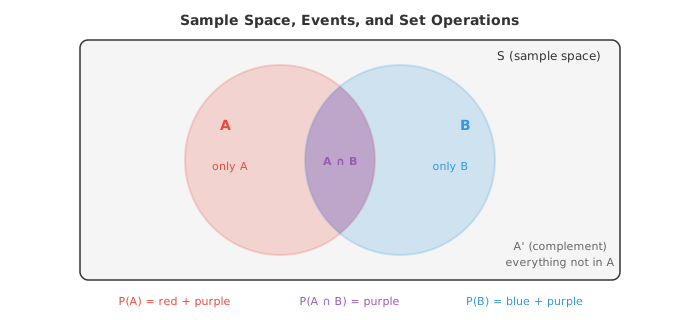
- 事件 \(A\) 的补集 (complement),记作 \(A'\) 或 \(A^c\),是 \(S\) 中所有不在 \(A\) 里的部分。因为每个结果要么在 \(A\) 里,要么不在:
-
走补集这条路往往更省事。比如想算 5 次抛硬币里至少出现一次正面的概率,与其列出所有情形,不如反过来算"一次正面都没有"再减掉:\(P(\text{at least one head}) = 1 - P(\text{all tails}) = 1 - (0.5)^5 = 0.969\)。
-
两个事件互斥 (mutually exclusive) 或说不相交 (disjoint),指的是它们不能同时发生:\(A \cap B = \emptyset\)。掷一次骰子出 2 和出 5 就是互斥的。
-
互斥事件的加法法则 (addition rule for mutually exclusive events) 很直接:
- 如果事件可能重叠,就得用一般加法法则 (general addition rule) 来避免把交集算两遍:
-
这正是数数里的容斥原理。上面的韦恩图能看清原因:紫色区域 (交集) 在 \(P(A)\) 里数了一次、\(P(B)\) 里又数了一次,所以要减掉一次。
-
联合概率 (joint probability) \(P(A \cap B)\) 是 \(A\) 与 \(B\) 同时发生的概率。在一副扑克牌里,\(P(\text{red} \cap \text{king}) = \frac{2}{52}\),因为红色的 King 只有 2 张。
-
边缘概率 (marginal probability) 是不管别的事件、单独一个事件的概率。\(P(\text{red}) = \frac{26}{52} = 0.5\) 就是一个边缘概率。如果你手上有两个变量的联合分布,对另一个变量求和 (或积分) 就能得到边缘分布。
-
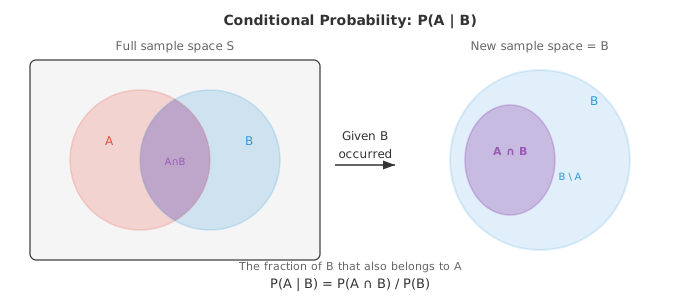
条件概率 (conditional probability) 回答的是:已知 \(B\) 发生了,\(A\) 的概率是多少?我们把样本空间从 \(S\) 缩小到 \(B\),再问 \(B\) 里有多大一块也属于 \(A\):
-
举例:你抽了一张牌,有人告诉你这是红色的。它是 King 的概率是多少?红牌有 26 张,其中 2 张是 King,所以 \(P(\text{king} | \text{red}) = \frac{2}{26} = \frac{1}{13}\)。用公式验证:\(P(\text{king} \cap \text{red}) / P(\text{red}) = \frac{2/52}{26/52} = \frac{1}{13}\)。
-
两个事件独立 (independent),指的是知道一个发生了对另一个没有任何信息量。形式化写法:
-
等价地,\(P(A | B) = P(A)\)。抛两枚独立的硬币是独立事件;不放回地抽两张牌就不独立 (第一张抽走会改变牌堆)。
-
独立性是一个巨大的简化器。对于独立事件,联合概率能拆成乘积,计算就变得可行。很多 ML 模型 (比如朴素贝叶斯) 在特征之间硬性假设独立,正是为了这份简化红利。
-
乘法法则 (multiplication rule) 对任意两个事件都成立,本质上是条件概率公式的变形:
-
对独立事件而言,条件概率等于边缘概率,所以简化成 \(P(A \cap B) = P(A) \cdot P(B)\)。
-
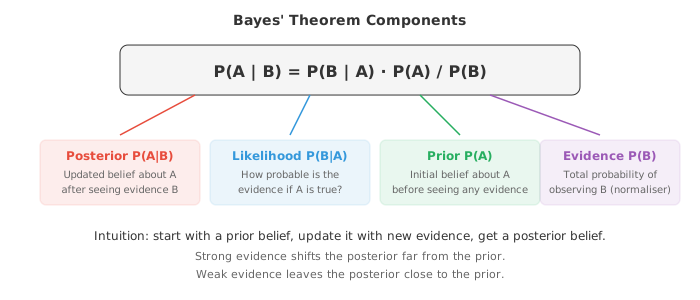
贝叶斯定理 (Bayes' theorem) 是概率论里最重要的结果之一,也是贝叶斯 ML 的基石。它能反转条件概率的方向:
- 定理直接来自把 \(P(A \cap B)\) 用两种方式写出来:\(P(B|A) \cdot P(A) = P(A|B) \cdot P(B)\),再解出 \(P(A|B)\)。
-
各部分都有名字:
- 先验 (prior) \(P(A)\):看到证据之前的初始信念
- 似然 (likelihood) \(P(B|A)\):假设 \(A\) 为真时,证据出现的可能性
- 证据 (evidence) \(P(B)\):证据出现的总概率,起归一化作用
- 后验 (posterior) \(P(A|B)\):看到证据之后更新过的信念
-
我们走一遍经典的医学诊断例子。假设某种疾病影响 1% 的人口。检测这种病的方法有 95% 的准确率:对生病的人正确识别率 95% (灵敏度),对健康的人正确识别率 90% (特异度)。
-
你检测出阳性。真的得病的概率是多少?
-
令 \(D\) = 得病,\(+\) = 检测阳性。
- 先验:\(P(D) = 0.01\)
- 似然:\(P(+ | D) = 0.95\)
- 假阳率:\(P(+ | D') = 0.10\)
-
我们需要算 \(P(+)\)。根据全概率公式 (law of total probability):
- 再套贝叶斯定理:
-
尽管检测号称"95% 准",一次阳性结果其实只意味着约 8.8% 的患病概率。先验极其关键。因为病本身就少见,绝大多数阳性都是假阳性。这个直觉对任何 ML 分类问题都至关重要:当类别不平衡时,光看准确率会严重误导你。
-
全概率公式 (law of total probability) 把样本空间划分成互斥又完备的事件 \(B_1, B_2, \ldots, B_n\),再把任一事件 \(A\) 表达为:
-
医学例子里算 \(P(+)\) 用的就是它:把人群拆成"得病"和"没病"两块。
-
概率的链式法则 (chain rule of probability) 把乘法法则推广到任意多个事件:
-
每一项都以前面所有事件为条件。这就是自回归语言模型的骨架:一个句子的概率等于每个词在其之前所有词条件下的概率的乘积。
-
条件独立 (conditional independence) 意思是两个事件在给定第三个事件时独立。\(A\) 与 \(B\) 在给定 \(C\) 时条件独立,当且仅当:
-
事件可以边缘相关但条件独立,反之亦然。比如两个学生的考试成绩可能是相关的 (都受考试难度影响),但一旦给定考试难度,两人的成绩就独立了。
-
条件独立是图模型 (比如贝叶斯网络) 背后的关键假设。它让你能把复杂的联合分布拆成一小块一小块,从而让推断在计算上可行。
Coding Tasks (use CoLab or notebook)
-
模拟医学诊断问题。生成一个 100,000 人的人群,套用疾病流行率和检测准确率,验证贝叶斯定理给出的后验是否正确。
import jax import jax.numpy as jnp key = jax.random.PRNGKey(42) n = 100_000 # 生成人群 k1, k2 = jax.random.split(key) has_disease = jax.random.bernoulli(k1, p=0.01, shape=(n,)) # 生成检测结果 k3, k4 = jax.random.split(k2) # 灵敏度: P(+|D) = 0.95, 特异度: P(-|D') = 0.90 test_positive = jnp.where( has_disease, jax.random.bernoulli(k3, p=0.95, shape=(n,)), jax.random.bernoulli(k4, p=0.10, shape=(n,)) ) # 在阳性人群里, 真正得病的比例是多少? positives = test_positive.astype(bool) true_positives = (has_disease & positives).sum() total_positives = positives.sum() print(f"Total positive tests: {total_positives}") print(f"True positives: {true_positives}") print(f"P(Disease | Positive) = {true_positives / total_positives:.4f}") print(f"Bayes' formula: {0.95 * 0.01 / 0.1085:.4f}") -
用模拟验证加法法则。生成已知概率与重叠程度的随机事件 A 与 B,然后检查 \(P(A \cup B) = P(A) + P(B) - P(A \cap B)\)。
import jax import jax.numpy as jnp key = jax.random.PRNGKey(0) n = 200_000 k1, k2 = jax.random.split(key) # 事件: A = value < 0.4, B = value < 0.6 (重叠区域为 < 0.4) vals_a = jax.random.uniform(k1, shape=(n,)) vals_b = jax.random.uniform(k2, shape=(n,)) A = vals_a < 0.4 B = vals_b < 0.6 p_a = A.mean() p_b = B.mean() p_a_and_b = (A & B).mean() p_a_or_b = (A | B).mean() print(f"P(A) = {p_a:.4f}") print(f"P(B) = {p_b:.4f}") print(f"P(A ∩ B) = {p_a_and_b:.4f}") print(f"P(A ∪ B) simulated = {p_a_or_b:.4f}") print(f"P(A) + P(B) - P(A∩B) = {p_a + p_b - p_a_and_b:.4f}") -
展示条件概率如何随证据变化。模拟掷两颗骰子,分别计算 \(P(\text{sum} = 7)\) 和 \(P(\text{sum} = 7 | \text{first die} = 3)\)。
import jax import jax.numpy as jnp key = jax.random.PRNGKey(1) n = 500_000 k1, k2 = jax.random.split(key) d1 = jax.random.randint(k1, shape=(n,), minval=1, maxval=7) d2 = jax.random.randint(k2, shape=(n,), minval=1, maxval=7) total = d1 + d2 # 无条件 p_sum7 = (total == 7).mean() print(f"P(sum=7) = {p_sum7:.4f} (exact: {6/36:.4f})") # 以第一颗骰子 = 3 为条件 mask = d1 == 3 p_sum7_given_d1_3 = (total[mask] == 7).mean() print(f"P(sum=7 | d1=3) = {p_sum7_given_d1_3:.4f} (exact: {1/6:.4f})") -
把贝叶斯定理实现成一个函数,用它迭代更新信念。以一枚硬币偏差的均匀先验为起点,每观察一次抛掷就更新一次。
import jax.numpy as jnp
import matplotlib.pyplot as plt

def bayes_update(prior, likelihood):
    """Multiply prior by likelihood and normalise."""
    posterior = prior * likelihood
    return posterior / posterior.sum()

# 离散化可能的偏差值
theta = jnp.linspace(0, 1, 200)
prior = jnp.ones_like(theta)  # 均匀先验
prior = prior / prior.sum()

# 观察到的抛掷结果: 1 = 正面, 0 = 反面
flips = [1, 1, 0, 1, 1, 1, 0, 1, 0, 1]

plt.figure(figsize=(10, 5))
plt.plot(theta, prior, "--", color="#999", label="prior")

for i, flip in enumerate(flips):
    likelihood = theta if flip == 1 else (1 - theta)
    prior = bayes_update(prior, likelihood)
    if i in [0, 2, 4, 9]:
        plt.plot(theta, prior, label=f"after {i+1} flips", linewidth=2)

plt.xlabel("Coin bias θ")
plt.ylabel("Belief (normalised)")
plt.title("Bayesian updating: belief about coin bias")
plt.legend()
plt.grid(alpha=0.3)
plt.show()
📌 本节要点
- 概率的两种解释:频率派把概率看作长期频率,贝叶斯派把它看作信念强度,数学规则相同。
- 样本空间与事件: \(S\) 装所有可能结果,事件是 \(S\) 的子集,等可能时概率即"有利结果数 / 总结果数"。
- 补集省力法:算"至少一次"比算"从不"更麻烦时,用 \(P(A') = 1 - P(A)\) 反向求解。
- 加法法则:互斥事件直接相加,有重叠事件要减去交集以免重复计数。
- 条件概率: \(P(A|B) = P(A \cap B) / P(B)\),本质是把样本空间缩到 \(B\) 后再问 \(A\) 占多少。
- 独立性:独立时联合概率拆成乘积,是朴素贝叶斯等模型能算下去的根本原因。
- 贝叶斯定理:由先验、似然、证据推出后验,反转条件概率方向,是贝叶斯 ML 的基石。
- 先验的分量:医学诊断例子说明,类别失衡时哪怕"95% 准"的检测,阳性也可能只有 8.8% 真患病。
- 全概率公式与链式法则:前者把 \(A\) 按划分展开,后者把联合分布展成一串条件概率——自回归语言模型的骨架。
- 条件独立:边缘相关的事件在给定第三方后可以独立,这是贝叶斯网络能拆解复杂联合分布的关键假设。