高效架构
一句话总结:让模型更快不只靠低精度,更靠更聪明的架构做更少的活——本节讲 StreamingLLM、稀疏与线性注意力、MQA/GQA/MLA、MoE 推理、蒸馏、剪枝与神经架构搜索。
让模型更快,不只是靠更低精度,还靠更聪明的架构——让每个 token 干更少的活。 本节覆盖 StreamingLLM、稀疏与线性注意力、多查询与分组查询注意力、推理阶段的专家混合模型 (Mixture of Experts, MoE)、知识蒸馏、剪枝,以及神经架构搜索.
- 量化 (第 1 节) 让每一次运算更便宜,本节则让运算次数本身变少。 二者互补:一个既架构高效又量化过的模型,可以比原始模型快 10-100 倍。
StreamingLLM:无限长度生成
-
标准 Transformer 把所有历史 token 存进 KV 缓存,缓存随序列长度线性增长。 到某一步,缓存超出 GPU 显存,生成就崩了。 StreamingLLM (Xiao 等,2023) 用固定大小的滚动 KV 缓存解决这个问题。
-
关键观察:序列开头几个 token 无论内容是什么,都会收到超乎寻常高的注意力分数。 这些叫注意力汇聚点 (attention sinks). 一旦把它们从缓存里赶走,注意力分布立刻塌掉,生成质量灾难性下降。
-
StreamingLLM 的做法:让少量汇聚 token (最前面 1-4 个) 永久留在缓存里,再加上最近 \(w\) 个 token 的滚动窗口. 总缓存大小是 \(\text{sink} + w\),不管已经生成了多少 token 都保持固定。
-
注意力汇聚点稳住了 softmax 分布,滚动窗口负责最近的上下文。 这样就能以恒定显存实现无限长度生成,代价是丢掉序列中段的上下文。
-
对于天然形成注意力汇聚点的模型 (大多数预训练大语言模型 (Large Language Model, LLM) 都会), StreamingLLM 不需要任何重训练。 对于不会自发形成的模型,只要在训练时加一个可学习的汇聚 token 就能解决。
稀疏注意力
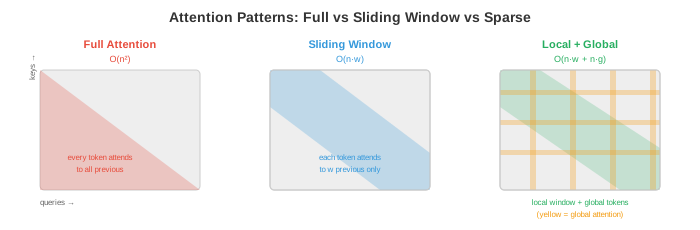
- 完整自注意力对序列长度 \(n\) 是 \(O(n^2)\),因为每个 token 要看所有其他 token. 当 \(n = 128K\) 时,注意力矩阵有 \(128K^2 = 160\) 亿项。 稀疏注意力通过限制"谁看谁"来把这个数字降下来。
-
滑动窗口注意力 (sliding window attention) (Mistral, Gemma):每个 token 只看前 \(w\) 个 token (例如 \(w = 4096\)). 复杂度从 \(O(n^2)\) 降到 \(O(n \cdot w)\). 信息通过多层堆叠传播出窗口:经过 \(L\) 层后,有效上下文长度是 \(L \times w\).
-
局部 + 全局注意力 (local + global attention) (Longformer, BigBird):大多数 token 用滑动窗口 (局部),但少数指定 token (如 [CLS]、每隔 512 个位置的 token) 看所有 token (全局). 这样既捕捉局部模式,又保住长距离依赖。
-
膨胀注意力 (dilated attention):在窗口内每隔 \(k\) 个位置看一个 token,用同样多的注意力分数覆盖更大范围。 逐层增加膨胀率,就形成类似空洞卷积 (第 8 章) 的分层结构。
-
现代 LLM 的实战赢家是滑动窗口 + 完整注意力交错:部分层用滑动窗口 (便宜,处理局部),部分层用完整注意力 (贵,捕捉长距离). Mistral/Mixtral 用的就是这种模式。
线性注意力与状态空间模型
-
能不能干脆把 \(O(n^2)\) 的注意力整个换掉?线性注意力 (linear attention) 与状态空间模型 (State Space Model, SSM) 就是这样,它们不显式构造注意力矩阵,以 \(O(n)\) 时间处理序列。
-
线性注意力用一个核近似替换 softmax 注意力:
-
先算 \(K^T V\) (结果是 \(d \times d\),与序列长度无关),复杂度就变成 \(O(n \cdot d^2)\) 而不是 \(O(n^2 \cdot d)\). 对于 \(n \gg d\) 的长序列,这是巨大的节省。
-
RWKV 把循环神经网络 (Recurrent Neural Network, RNN) 和 Transformer 的思想糅在一起。 它用循环形式逐 token 处理 (像 RNN),但训练时能并行 (像 Transformer). 推理时每个 token 是 \(O(1)\) (显存恒定,KV 缓存不增长).
-
Mamba (Gu & Dao, 2023) 是一个选择性 SSM. 它通过学到的状态转移来处理序列:
-
其中 \(\bar{A}\) 和 \(\bar{B}\) 依赖输入 (即"选择性"),让 Mamba 能动态聚焦或忽略输入的某些部分。 与固定 SSM 不同,这种选择性让 Mamba 在语言任务上能与 Transformer 掰手腕,同时保持 \(O(n)\) 的伸缩性。
-
权衡:长序列上线性注意力和 SSM 更快,但在需要精确长距离检索的任务上通常不如完整注意力。 混合架构 (一部分 Transformer 层 + 一部分 Mamba 层) 常常两头都占。
多查询与分组查询注意力
-
标准多头注意力 (Multi-Head Attention, MHA,第 7 章) 每个头有各自的 \(K\)、\(V\) 投影。 对 \(h\) 个头,KV 缓存里就有 \(h\) 组独立的键值张量。 多查询注意力 (Multi-Query Attention, MQA) 和分组查询注意力 (Grouped-Query Attention, GQA) 就是来降这个开销的。
-
MQA (Shazeer, 2019):所有头共享一组 \(K, V\) 投影,但每个头保留各自的 \(Q\) 投影。 KV 缓存缩小 \(h\) 倍 (例如 32 头就是 32 倍).
-
GQA (Ainslie 等,2023):折中方案。 把头分组,每组共享一组 \(K, V\) 投影。 32 个头 (\(h = 32\)) 分成 8 组 (\(g = 8\)),每 4 个头共享 K/V. KV 缓存缩小 \(h/g = 4\) 倍。
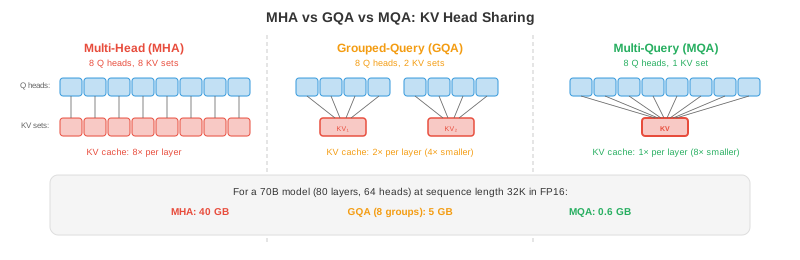
- 现代大多数 LLM 用 GQA (Llama 2/3, Gemma, Mistral). 相较 MHA,它以几乎可以忽略的质量损失换来更小的 KV 缓存和更低的推理延迟。
多头潜在注意力 (MLA)
- 多头潜在注意力 (Multi-head Latent Attention, MLA) (DeepSeek-V2, 2024) 比 GQA 更进一步,把 KV 缓存压进一个低秩潜空间. 它不缓存完整的键值向量,而是每个 token 只缓存一个压缩后的潜向量 \(\mathbf{c}_t\),在做注意力时再实时重构 K/V:
-
压缩向量 \(\mathbf{c}_t\) 比原始 K 和 V 加起来小很多。 DeepSeek-V2 相比 MHA 把 KV 缓存削减了 93.3%,甚至比 MQA 更省,同时保持 MHA 级的质量。
-
代价是每次注意力都要多算一次 K/V 重构。 但由于 LLM 解码是显存带宽受限 (不是算力受限) 的,这笔账很划算:少加载显存 > 每 token 多几步计算。
Flash Attention
-
FlashAttention (Dao 等,2022,第 16 章第 05 节详述) 不是架构改动,而是实现层面的优化——但凡讨论高效注意力都绕不开。 它做的是精确的标准注意力,特点是:
- O(n) 显存而不是 O(n²) (注意力矩阵从不在 HBM 里落地).
- 快 2-4 倍 (通过分块与在线 softmax 把数据留在 SRAM 里).
- 零质量损失——输出与标准注意力数学上完全等价。
-
FlashAttention 现在已是 PyTorch (
torch.nn.functional.scaled_dot_product_attention)、JAX 以及所有主流推理框架的默认注意力实现。 2024 年之后跑注意力,你几乎必然在用 FlashAttention.
Ring Attention
-
Ring Attention (Liu 等,2023) 把注意力计算拆到多个设备上,用于哪怕上了 FlashAttention 也塞不进单张 GPU 的超长序列。
-
思路:把序列切成 \(N\) 份,分给 \(N\) 个设备,每个设备持有 \(n/N\) 个 token 的 Q、K、V. 设备排成一个环。 每一步:
- 每个设备算本地注意力 (自己的 Q 对自己的 K/V).
- 每个设备把自己的 K/V 块发给环中下一个设备。
- 每个设备收下上一个设备传来的 K/V,对它算注意力。
- 走完 \(N\) 步,每个设备都对所有 K/V 块做过一遍注意力。
-
通信与计算是重叠的:一边算当前 K/V 块的注意力,一边传下一块。 这样通信延迟几乎被完全隐藏。
-
Ring Attention 让百万 token 上下文成为可能——KV 缓存被分散到一圈 GPU 上。 每个设备的显存占用是 O(n/N),序列想多长就多长 (只受设备数量限制).
推理阶段的专家混合模型
-
MoE 模型 (第 7 章) 每个 token 只激活一小部分参数 (通常 8 个专家里选 2 个). 到了推理端,独特的挑战是专家缓存:所有专家都必须常驻显存 (因为任何 token 都可能路由到任何专家),但每个 token 只用其中 2 个。
-
以 Mixtral 8x7B 为例:总参数 = 47B (8 × 7B 专家,加上部分共享组件). 每 token 激活参数 ≈ 13B (2 个专家 + 共享层). 模型的质量对标 70B 级 LLM,推理开销却像 13B,但显存里得放下 47B.
-
专家卸载 (expert offloading):对显存吃紧的部署,把不活跃的专家放在 CPU 或 SSD 上,按需加载。 因为 token 路由的可预测性够强,常能提前把可能用到的专家预取上来。
-
专家缓存 (expert caching):在 GPU 显存里维护一个最近使用专家的 LRU 缓存。 如果同一批专家被反复激活 (领域内数据很常见),命中率会很高。
知识蒸馏
- 蒸馏 (distillation) (第 6 章) 训练一个小的"学生"模型去模仿大的"教师". 学生从教师的软预测 (类别上的概率分布) 中学习,这比只有硬标签信息更丰富。
-
其中 \(T\) 是温度 (温度越高分布越平,越能显出教师的不确定性), \(\alpha\) 用来平衡蒸馏损失与标准交叉熵损失。
-
LLM 场景:蒸馏用来从大模型造出又小又快的模型。 GPT-4 → 一个 7B 学生,在特定任务上复刻 GPT-4 的大部分行为。 学生模型的服务成本能便宜 10-100 倍。
-
任务特化蒸馏:只在部署任务相关的数据上蒸馏。 从 70B 教师蒸馏出、在医学问答上专训的 7B 模型,在这个特定任务上能反超 70B (因为学生有限的容量全被压到目标领域上了).
剪枝
-
剪枝 (pruning) 删除多余的权重 (设为零),减小模型大小与计算量。
-
非结构化剪枝 (unstructured pruning) (按幅值):剪掉绝对值最小的那些权重。 得到的是稀疏权重矩阵。 做压缩简单有效,但当前硬件 (GPU) 无法高效加速稀疏运算,除非稀疏遵循特定模式。
-
结构化剪枝 (structured pruning):整体删除单元——某个注意力头、某些 MLP 神经元,或整层。 结果是更小的稠密模型,标准硬件直接就能加速。 代价是粒度更粗 (删一个头可能同时删掉有用和没用的权重).
-
2:4 稀疏 (2:4 sparsity) (NVIDIA Ampere 及以上):一种硬件原生支持的稀疏模式,每 4 个权重里有 2 个为零。 GPU 的稀疏 Tensor Core 会跳过零乘法,拿到约 2 倍加速。 目前唯一能被硬件真正加速的稀疏模式。
-
彩票假设 (Lottery Ticket Hypothesis) (Frankle & Carlin, 2019):一个随机初始化的网络里,存在一个子网络 ("中奖彩票"),单独训练也能达到全网络的性能。 找到这些子网络 (通过训练、剪枝、回卷) 代价不菲,但这个洞察激励了剪枝研究。
神经架构搜索 (NAS)
-
神经架构搜索 (Neural Architecture Search, NAS) 让架构设计自动化:在架构候选空间里搜,找出在硬件约束 (延迟、显存、功耗) 下最高精度的那一个。
-
EfficientNet (第 8 章) 就是 NAS 找出来的:复合缩放规则 (深度、宽度、分辨率一起平衡) 是搜索搜出来的,而不是人拍脑袋想出来的。
-
对推理效率,NAS 能针对特定硬件目标搜出定制架构:"找一个在 iPhone Neural Engine 上 <5ms 延迟、且在 ImageNet 上 >80% 精度的模型". 搜索空间涵盖层类型、宽度、激活函数、注意力模式。
-
一次性网络 (once-for-all networks) 训练一个超参数化的大网络,再从中抽出适配不同部署目标的子网络。 一次训练就产出面向云端 GPU、移动 GPU、CPU 的多个模型,每个都为自己的目标优化。
编程任务 (用 Colab 或 notebook)
-
实现滑动窗口注意力,与完整注意力对比显存占用。
import jax import jax.numpy as jnp def full_attention(Q, K, V): """标准 O(n^2) 注意力.""" scores = Q @ K.T / jnp.sqrt(Q.shape[-1]) weights = jax.nn.softmax(scores, axis=-1) return weights @ V def sliding_window_attention(Q, K, V, window_size=128): """滑动窗口注意力: 每个 token 关注前 window_size 个 token.""" n = Q.shape[0] d = Q.shape[-1] output = jnp.zeros_like(Q) for i in range(n): start = max(0, i - window_size + 1) k_window = K[start:i+1] v_window = V[start:i+1] scores = Q[i] @ k_window.T / jnp.sqrt(d) weights = jax.nn.softmax(scores) output = output.at[i].set(weights @ v_window) return output n, d = 512, 64 key = jax.random.PRNGKey(0) Q = jax.random.normal(key, (n, d)) K = jax.random.normal(jax.random.PRNGKey(1), (n, d)) V = jax.random.normal(jax.random.PRNGKey(2), (n, d)) print(f"Full attention memory: O(n^2) = {n*n} entries") print(f"Window (w=128) memory: O(n*w) = {n*128} entries") print(f"Reduction: {n*n / (n*128):.1f}x") -
对比 MHA、GQA、MQA 的 KV 缓存大小,说明为什么 GQA 是实践上的甜蜜点。
def kv_cache_size(n_heads, n_kv_heads, d_head, seq_len, bytes=2): """KV 缓存大小 (MB).""" return 2 * n_kv_heads * d_head * seq_len * bytes / 1e6 n_heads = 32 d_head = 128 seq_len = 32768 mha = kv_cache_size(n_heads, n_heads, d_head, seq_len) # 32 KV heads gqa = kv_cache_size(n_heads, 8, d_head, seq_len) # 8 KV heads mqa = kv_cache_size(n_heads, 1, d_head, seq_len) # 1 KV head print(f"MHA (32 KV heads): {mha:.0f} MB per layer") print(f"GQA (8 KV heads): {gqa:.0f} MB per layer ({mha/gqa:.0f}x smaller)") print(f"MQA (1 KV head): {mqa:.0f} MB per layer ({mha/mqa:.0f}x smaller)") -
模拟结构化剪枝:从随机注意力层里删掉最不重要的注意力头,观察输出变化。
import jax
import jax.numpy as jnp

key = jax.random.PRNGKey(0)
n_heads, seq_len, d_head = 8, 64, 32

# 随机多头注意力输出 (每头一份)
head_outputs = jax.random.normal(key, (n_heads, seq_len, d_head))

# 完整输出: 拼接所有头
full_output = head_outputs.reshape(seq_len, n_heads * d_head)

# 重要性: 以每头输出的范数衡量贡献
head_norms = jnp.linalg.norm(head_outputs, axis=(1, 2))
print("Head importance (by norm):", jnp.round(head_norms, 2))

# 剪掉最不重要的头
for n_keep in [8, 6, 4, 2]:
    top_heads = jnp.argsort(head_norms)[-n_keep:]
    pruned = head_outputs[top_heads].reshape(seq_len, n_keep * d_head)

    # 为便于对比, 把被剪的头置零后填回原尺寸
    full_pruned = jnp.zeros_like(head_outputs)
    full_pruned = full_pruned.at[top_heads].set(head_outputs[top_heads])
    full_pruned = full_pruned.reshape(seq_len, n_heads * d_head)

    error = jnp.linalg.norm(full_output - full_pruned) / jnp.linalg.norm(full_output)
    print(f"Keep {n_keep}/{n_heads} heads: relative error = {error:.4f}, "
          f"memory = {n_keep/n_heads:.0%}")
📌 本节要点
- 量化 vs 架构优化:前者让单次运算更便宜,后者让运算次数更少,二者叠加可达 10-100 倍加速。
- StreamingLLM:用固定汇聚 token + 滚动窗口实现恒定显存的无限长度生成。
- 注意力汇聚点:序列开头几个 token 承担超额注意力,是稳定 softmax 分布的锚点。
- 稀疏注意力:滑动窗口把 \(O(n^2)\) 降到 \(O(n \cdot w)\),现代 LLM 常与完整注意力交错使用。
- 线性注意力与 SSM:通过重排乘法顺序或状态转移实现 \(O(n)\) 复杂度,Mamba 用选择性重回竞争力。
- GQA:分组共享 K/V, KV 缓存缩小数倍,质量几乎无损,是 Llama/Mistral 的实战标配。
- MLA:把 K/V 压进低秩潜空间,DeepSeek-V2 削掉 93% KV 缓存并保持 MHA 级质量。
- FlashAttention:精确、O(n) 显存、快 2-4 倍,已是主流框架默认实现。
- Ring Attention:环形拆分 K/V,通信与计算重叠,让百万 token 上下文成为可能。
- 蒸馏与剪枝:蒸馏用软标签把大模型知识灌进小模型;2:4 稀疏是当前唯一被硬件真正加速的剪枝模式。