统计推断
一句话总结:统计推断超越是否二元决策,用点估计、置信区间、极大似然与蒙特卡罗等工具,在给出参数估计的同时量化不确定性。
统计推断超越了非黑即白的二元判断,用可量化的不确定性去估计总体参数。本节涵盖置信区间、点估计与区间估计、极大似然估计、矩估计和回归分析——它是从原始数据通向机器学习 (Machine Learning, ML) 预测模型的桥梁。
-
假设检验给你的是一个是否二元决策:拒绝或不拒绝。但很多时候我们想要更有信息量的东西——一个参数可能落在哪的合理范围。这就是 置信区间 要提供的。
-
点估计 (point estimate) 是从样本算出的一个数字,比如样本均值 \(\bar{x}\)。它是对总体参数的最佳猜测,但单独看不出估计有多精确。
-
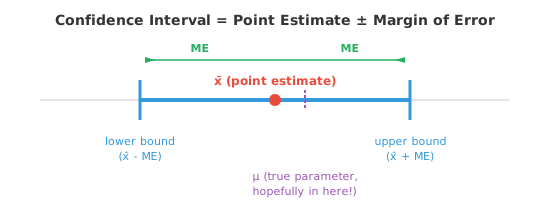
置信区间 (confidence interval) 在点估计外面套一个区间,反映不确定性。形式如下:
- 边际误差 (Margin of Error, ME) 取决于三样东西:你想要多高的置信度、数据本身波动多大、样本量多少:
- 这里 \(z^\ast\) 是正态分布下对应目标置信度的临界值。95% 置信度对应 \(z^\ast = 1.96\),99% 置信度对应 \(z^\ast = 2.576\)。
-
95% 置信区间 的含义是:如果你把实验重复很多次,每次都造一个区间,大约 95% 的区间会包含真实的总体参数。它 不是 说这一个特定区间有 95% 的概率包含参数。参数是固定的,变的是区间。
-
举例演算:你测了 50 个人的身高,得到 \(\bar{x} = 170\) cm,\(\sigma = 8\) cm。构造 95% 置信区间。
-
你可以以 95% 的置信度说:真实平均身高落在 167.78 到 172.22 cm 之间。
-
当 \(\sigma\) 未知(这是常见情况),改用样本标准差 \(s\) 和 t 分布:
-
区间越宽,置信度越高但精度越低;区间越窄,精度越高但置信度越低。想在不损失置信度的情况下缩小区间,只能加大样本量。
-
功效分析 (power analysis) 用来在实验开跑之前先规划。核心问题是:为了以指定的功效检出给定大小的效应,我需要多大的样本?
-
回忆上一节,功效 = \(1 - \beta\),即正确拒绝错误的 \(H_0\) 的概率。常用目标是 80% 功效。
-
用 z 检验检出差异 \(\delta\),显著性水平为 \(\alpha\),功效为 \(1-\beta\),所需样本量为:
- 例如,要以 \(\alpha = 0.05\) 与 80% 功效 (\(z_{0.025} = 1.96\),\(z_{0.20} = 0.84\)) 检出 2 cm 的平均身高差异 (\(\sigma = 8\)):
-
每组大约需要 126 人。
-
功效分析可以避免两个常见错误:实验样本太小、检不出真实效应(欠功效);或者实验规模远超必要、白白浪费资源(过功效)。
-
蒙特卡罗方法 (Monte Carlo methods) 用随机抽样求解那些解析上难以或不可能求解的问题。核心思路是:如果没法精确计算,那就模拟很多次,用结果做近似。
-
名字来自蒙特卡罗赌场,向随机性致敬。这些方法在 ML 中是主力,用于估计积分、评估模型不确定性、逼近复杂分布等。
-
蒙特卡罗方法的通用套路:
- 定义可能输入的取值域
- 从这个域里生成随机输入
- 对每个输入计算函数值
- 聚合结果(取平均、计数等)
-
经典例子是估计 \(\pi\)。想象一个边长为 2、以原点为中心的正方形,里面内接一个半径为 1 的圆。正方形面积是 4,圆面积是 \(\pi\)。
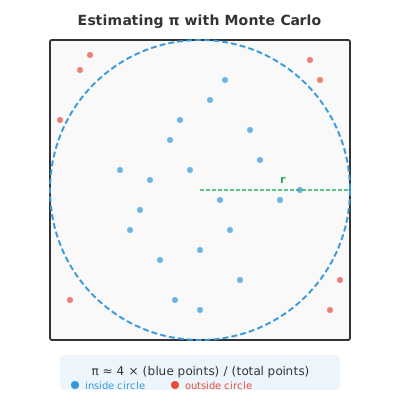
- 在正方形内均匀撒随机点,落在圆内的比例近似 \(\pi/4\):
-
一个点 \((x, y)\) 落在圆内当且仅当 \(x^2 + y^2 \le 1\)。撒的点越多,估计就越接近 \(\pi\) 的真实值。
-
蒙特卡罗方法在 ML 中出现在:
- 蒙特卡罗 Dropout (Monte Carlo dropout):推理时打开 Dropout 多次前向,用来估计预测的不确定性
- 马尔可夫链蒙特卡罗 (Markov Chain Monte Carlo, MCMC):从贝叶斯模型的复杂后验分布中采样
- 策略梯度方法 (policy gradient methods):在强化学习中通过采样轨迹来估计梯度
-
因子分析 (factor analysis) 是一种发现隐藏(潜在)变量、用它们解释观测变量之间相关性的技术。如果 10 道人格问卷的问题可以由 3 个底层特质(外向性、宜人性、尽责性)解释,因子分析就能把这些特质找出来。
-
该模型假设每个观测变量 \(x_i\) 都是若干潜在因子 \(f_j\) 的线性组合再加上噪声:
-
这里的 \(\lambda\) 叫做 因子载荷 (factor loadings),反映每个观测变量与每个因子的关联强度。这与第 2 章的矩阵分解直接相关:因子分析与特征值分解和奇异值分解 (Singular Value Decomposition, SVD) 密切相关。
-
实验设计 (experimental design) 是把一个实验组织好、让你能得出有效结论的艺术。设计不当,再大的数据集也可能一文不值。
-
一个设计良好的实验的关键要素:
- 自变量 (Independent Variable, IV):你操纵的东西(例如药物剂量、模型架构)
- 因变量 (Dependent Variable, DV):你测量的东西(例如恢复时间、准确率)
- 对照组 (control group):不接受任何处理(或接受安慰剂),提供比较的基线
- 随机分配 (random assignment):把参与者随机分到各组,让那些没测到的混淆变量在组间自然平衡
-
常见实验设计:
- 完全随机化设计 (completely randomised design):将受试者随机分配到处理组。当各组本身可比时简单有效。
- 随机化区组设计 (randomised block design):先把受试者按某个因素(比如年龄)分入若干区组,再在每个区组内做随机分配。这能降低该区组因素带来的变异,思路上类似分层抽样。
- 析因设计 (factorial design):同时检验多个自变量。一个 \(2 \times 3\) 的析因设计有一个变量取 2 个水平、另一个取 3 个水平,共 6 种处理组合。它能检测 交互作用 (interactions):一个变量的效果依赖于另一个变量的水平。
- 交叉设计 (crossover design):每个受试者依次接受所有处理(中间加洗脱期)。每个人都是自己的对照,从而降低个体差异的影响。
-
这些原则在 ML 实验里也至关重要。对比模型时,你应该控制随机种子、数据集切分和硬件。交叉验证本质上就是一种交叉设计;消融实验 (ablation study) 每次去掉一个组件,其逻辑正是析因设计。
编程任务 (使用 CoLab 或 notebook)
-
为身高例子构造 95% 置信区间,然后试试不同的置信度和样本量。
import jax.numpy as jnp x_bar = 170.0 # 样本均值 sigma = 8.0 # 总体标准差 (已知) n = 50 # 样本量 # 常见置信度对应的临界值 z_stars = {0.90: 1.645, 0.95: 1.960, 0.99: 2.576} for conf, z_star in z_stars.items(): me = z_star * (sigma / jnp.sqrt(n)) lower, upper = x_bar - me, x_bar + me print(f"{conf*100:.0f}% CI: [{lower:.2f}, {upper:.2f}] (ME = {me:.2f})") -
用蒙特卡罗模拟估计 \(\pi\)。画出估计值随点数增加的收敛过程。
import jax import jax.numpy as jnp import matplotlib.pyplot as plt key = jax.random.PRNGKey(42) # 在 [-1, 1] x [-1, 1] 内生成随机点 n_points = 100_000 k1, k2 = jax.random.split(key) x = jax.random.uniform(k1, shape=(n_points,), minval=-1, maxval=1) y = jax.random.uniform(k2, shape=(n_points,), minval=-1, maxval=1) # 判断哪些点落在单位圆内 inside = (x**2 + y**2) <= 1.0 cumulative_inside = jnp.cumsum(inside) counts = jnp.arange(1, n_points + 1) pi_estimates = 4.0 * cumulative_inside / counts plt.figure(figsize=(10, 4)) plt.plot(pi_estimates, color="#3498db", alpha=0.7, linewidth=0.5) plt.axhline(y=jnp.pi, color="#e74c3c", linestyle="--", label=f"π = {jnp.pi:.6f}") plt.xlabel("Number of points") plt.ylabel("Estimate of π") plt.title("Monte Carlo estimation of π") plt.legend() plt.ylim(2.8, 3.5) plt.show() print(f"Final estimate: {pi_estimates[-1]:.6f}") print(f"True value: {jnp.pi:.6f}") print(f"Error: {abs(pi_estimates[-1] - jnp.pi):.6f}") -
做一个简单的功效分析:给定效应大小与标准差,计算所需样本量并通过模拟验证。
import jax import jax.numpy as jnp # 参数 delta = 2.0 # 效应大小 (均值差) sigma = 8.0 # 总体标准差 alpha = 0.05 power_target = 0.80 # 解析求样本量 z_alpha = 1.96 # 双侧, alpha=0.05 z_beta = 0.84 # power=0.80 n_required = ((z_alpha + z_beta) * sigma / delta) ** 2 print(f"Required n per group: {n_required:.0f}") # 通过模拟验证 key = jax.random.PRNGKey(7) n = int(jnp.ceil(n_required)) n_sims = 5000 rejections = 0 for _ in range(n_sims): key, k1, k2 = jax.random.split(key, 3) group_a = jax.random.normal(k1, shape=(n,)) * sigma + 50 group_b = jax.random.normal(k2, shape=(n,)) * sigma + 50 + delta pooled_se = jnp.sqrt(2 * sigma**2 / n) z = (group_b.mean() - group_a.mean()) / pooled_se p = 2 * (1 - __import__("jax").scipy.stats.norm.cdf(jnp.abs(z))) if p <= alpha: rejections += 1 print(f"Simulated power: {rejections/n_sims:.3f}") print(f"Target power: {power_target:.3f}") -
可视化置信区间宽度如何随样本量变化。这能直观说明:多收集数据为什么带来更精确的估计。
import jax.numpy as jnp
import matplotlib.pyplot as plt

sigma = 8.0
z_star = 1.96  # 95% 置信度

sample_sizes = jnp.array([10, 20, 30, 50, 100, 200, 500, 1000], dtype=jnp.float32)
margins = z_star * sigma / jnp.sqrt(sample_sizes)

plt.figure(figsize=(8, 4))
plt.bar([str(int(n)) for n in sample_sizes], margins, color="#3498db", alpha=0.7)
plt.xlabel("Sample size")
plt.ylabel("Margin of error (cm)")
plt.title("95% CI margin of error shrinks with larger samples")
plt.show()
📌 本节要点
- 点估计 vs 置信区间:前者给一个数字,后者给一段范围外加不确定性度量。
- 置信区间公式: \(\bar{x} \pm z^\ast \cdot \sigma / \sqrt{n}\),\(\sigma\) 未知时用样本标准差 \(s\) 与 t 分布。
- 95% 置信度的含义:重复实验时约 95% 的区间会覆盖真值,而非"当前区间有 95% 的概率含真值"。
- 边际误差三要素:置信度、数据变异、样本量;只靠加样本量能同时保住置信度并压窄区间。
- 功效分析:提前算需要多大样本,避免欠功效或过功效实验。
- 蒙特卡罗方法:用随机采样近似难以解析求解的量,是估计积分、后验分布与策略梯度的通用工具。
- 因子分析:用少量潜在因子解释多个观测变量的相关性,与 SVD 有内在联系。
- 实验设计四要素:自变量、因变量、对照组、随机分配,是得出可信结论的前提。
- 常见设计:完全随机化、随机化区组、析因、交叉;ML 中的交叉验证与消融实验分别对应交叉设计与析因设计。