卷积网络
一句话总结:卷积神经网络用梯度下降从像素中直接学出空间特征层级,从 LeNet 到 EfficientNet 一路架构演进,定义了整整十年的图像识别范式。
卷积神经网络直接从像素数据中学习空间特征的层级结构,用梯度优化的滤波器取代人工设计的滤波器。 本节涵盖卷积机制、池化、步长、膨胀、感受野,以及定义了图像分类江山的经典架构 (LeNet, AlexNet, VGG, ResNet, Inception, EfficientNet).
-
在 01 节里,我们手工设计了做边缘检测、模糊和角点检测的滤波器。 一个自然的问题是:能不能直接从数据里学出最优的滤波器?卷积神经网络 (Convolutional Neural Network, CNN) 干的就是这件事。
-
CNN 不再靠人手挑滤波器权重,而是通过梯度下降 (chapter 06) 学出来,发现对当前任务真正有用的特征。
-
在第 06 章,我们介绍过卷积操作、CNN 基础以及"学滤波器"这个思路。 这里我们进一步深入,讲那些让 CNN 统治计算机视觉十多年的架构创新。
-
回忆一下核心的卷积操作:一个 \(k \times k\) 的滤波器 \(K\) 在输入特征图上滑动,每到一个位置就算一次点积 (chapter 06). 输出尺寸由三个超参数控制:
- 步长 (stride):滤波器每次挪动几个像素。 步长 1 表示一次挪一格;步长 2 表示一次挪两格,空间维度直接砍半。 带步长的卷积是池化之外的另一种下采样方式。
- 填充 (padding):在输入边界补零。 "Same" 填充 (\(p = \lfloor k/2 \rfloor\)) 保持空间维度不变。 "Valid" 填充 (\(p = 0\)) 让维度变小。
- 膨胀 (dilation):在滤波器元素之间插空隙。 一个膨胀率为 2 的 3x3 滤波器只用 9 个参数就能覆盖 5x5 的感受野。 膨胀卷积能扩大感受野,但不增加计算量。
-
卷积后的输出空间尺寸 (含膨胀率 \(d\),据 PyTorch
nn.Conv2d官方文档 2024):
-
其中 \(\text{in}\) 是输入尺寸,\(k\) 是卷积核大小,\(p\) 是填充,\(s\) 是步长,\(d\) 是膨胀率 (dilation,默认 \(d = 1\),此时公式退化为 \(\lfloor (\text{in} - k + 2p)/s \rfloor + 1\)). 这个公式对高和宽独立生效。
-
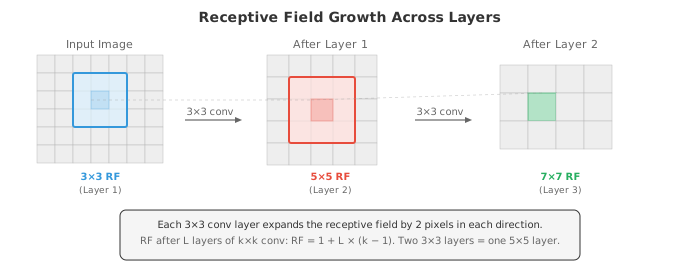
一个神经元的感受野 (receptive field) 是能影响它取值的那块原始输入区域。
- 浅层的感受野小 (看局部模式,比如边缘).
- 深层的感受野大 (看更大的结构,比如物体的部件).
-
感受野随层数增长:大致每加一层卷积就增加 \(k - 1\) 个像素 (有步长或膨胀会更多).
-
池化 (pooling) 层缩小空间维度,同时留住最重要的信息。
- 最大池化 (max pooling) 取每个窗口内的最大值,保留最强的激活 (最显眼的特征).
- 平均池化 (average pooling) 取平均值,让特征图变得更平滑。 一个步长为 2 的 2x2 池化会把两个空间维度都砍半。
-
全局平均池化 (Global Average Pooling, GAP) 把每个通道的整块空间平均成一个数,得到一个长度等于通道数的向量。 现代很多架构末尾用 GAP 取代全连接层,参数量骤减,还起到结构性正则化的作用。
-
批归一化 (Batch Normalisation, BatchNorm) 把每个 mini-batch 内的激活归一化到零均值、单位方差,然后再乘一个可学的缩放、加一个可学的偏移 (chapter 06). 在 CNN 中,BatchNorm 按通道进行:每个通道独立地跨 batch 与空间维度算统计量。 它能稳定训练、允许更大的学习率,还带点温和的正则化效果。
-
Dropout (chapter 06) 在训练时随机把神经元置零。
-
在 CNN 中,空间 Dropout (Dropout2D) 是随机丢整块特征图通道,而不是单个像素,效果更好,因为特征图里相邻像素高度相关。
-
数据增强 (data augmentation) 通过在训练时对每张图随机变换,人为扩大训练集:水平翻转、随机裁剪、旋转、颜色抖动 (调亮度、对比度、饱和度、色相)、还有 Cutout (随机遮住矩形块). 网络每次看到的图都不一样,被迫学出对变换不变的特征,而不是死记住某种像素模式。
-
更高级的增强策略包括 Mixup (把两张图和它们的标签按比例混合:\(\tilde{x} = \lambda x_i + (1-\lambda) x_j\), \(\tilde{y} = \lambda y_i + (1-\lambda) y_j\))、CutMix (把一张图上的矩形块粘到另一张图上,标签按面积比例混合)、以及 RandAugment (从固定的一组增强中随机采样一串,只用一个强度参数控制).
-
CNN 架构的演进史,就是一部"越来越深、越来越高效"的故事,每一代都在解决上一代绕不过去的问题。
-
LeNet-5 (LeCun et al., 1998) 是最初的 CNN,为手写数字识别设计。 两层卷积接三层全连接,用平均池化和 tanh 激活。 它证明了"学出来的滤波器"胜过"手工设计的特征",但按今天的标准太小了 (6 万参数).
-
AlexNet (Krizhevsky et al., 2012) 以巨大优势拿下 ImageNet 比赛冠军,点燃了深度学习革命。 关键创新:用 ReLU 激活 (代替 tanh,后者有梯度消失问题)、用 Dropout 做正则、用数据增强、在 GPU 上训练。 五层卷积、三层全连接,6000 万参数。
-
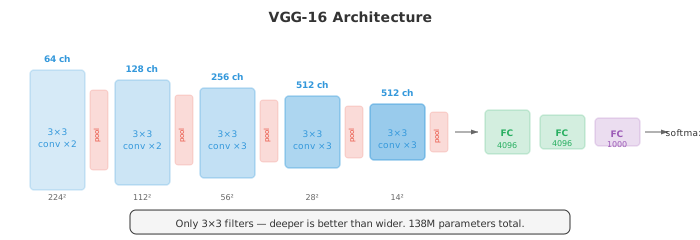
VGG (Simonyan and Zisserman, 2014) 证明了只用 3x3 滤波器往深了堆比用大滤波器更好。 两个堆叠的 3x3 滤波器和一个 5x5 感受野一样大,但参数更少 (\(2 \times 3^2 = 18\) 对 \(5^2 = 25\)),而且多一次非线性。 VGG-16 (16 层) 和 VGG-19 (19 层) 现在还被广泛拿来当特征提取器用。 架构简单得离谱:通道数递增的卷积块 (64, 128, 256, 512),每块后跟一个最大池化。
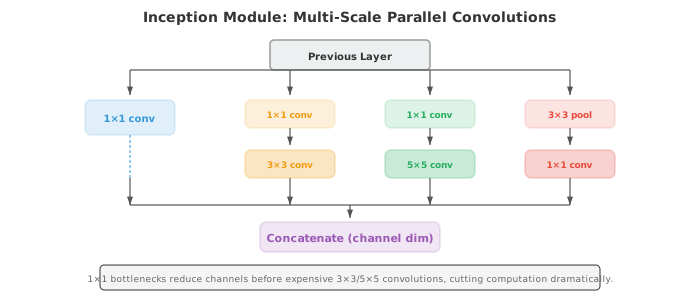
- GoogLeNet/Inception (Szegedy et al., 2014) 引入了 Inception 模块:与其纠结选哪个滤波器尺寸,不如把 1x1、3x3、5x5 的卷积并行跑,把输出拼起来,让网络自己决定哪个尺度最有用。 大滤波器前先用 1x1 卷积做瓶颈来削减计算量。 GoogLeNet 用比 VGG 少 12 倍的参数 (680 万对 1.38 亿) 拿到了更好的准确率。
-
Inception 模块同时捕获多种尺度的特征。 1x1 滤波器抓点级模式,3x3 抓局部纹理,5x5 抓更大的结构。 拼接把所有视角合成一个丰富的表示。
-
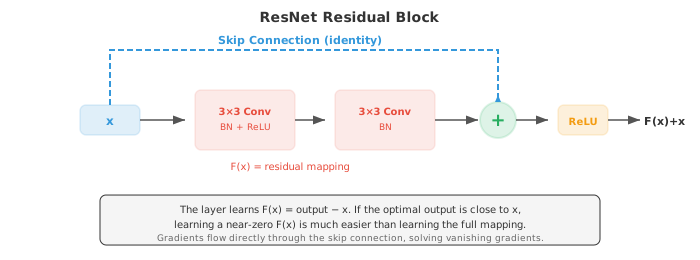
ResNet (He et al., 2016) 解决了退化问题 (degradation problem):更深的网络反而表现更差,不是因为过拟合,而是因为更难优化。 解决方案是跳跃连接 (skip connection) (残差连接):
- 这层学的是残差 \(F(x) = \text{output} - x\). 如果最优变换接近恒等映射 (深层网络里这很常见),让残差学到接近 0 比让它学完整映射容易得多。 跳跃连接还提供了一条直达的梯度高速公路,缓解梯度消失。 ResNet 训出了 152 层的网络,远超之前的任何架构。
-
当输入和输出维度不匹配 (由于步长或通道数变化) 时,投影 shortcut (projection shortcut) 用一个 1x1 卷积作用在 \(x\) 上来对齐维度:\(\text{output} = F(x) + W_s x\).
-
瓶颈块 (bottleneck block) (用在 ResNet-50 及更深的版本里) 用三层卷积:1x1 缩通道数,3x3 做空间处理,再 1x1 把通道数扩回去。 这比两层 3x3 便宜,也让网络可以堆得更深。
-
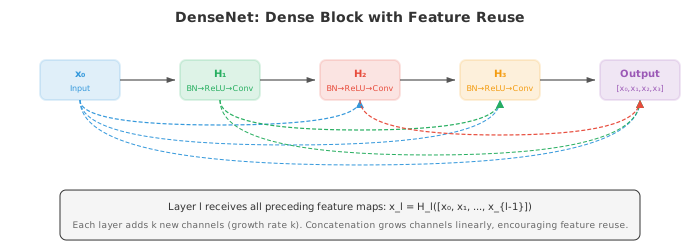
DenseNet (Huang et al., 2017) 把跳跃连接的思路推到极致:每层都连接到该 dense 块内所有后续层。 第 \(l\) 层的输入是前面所有层的特征图:\(x_l = H_l([x_0, x_1, \ldots, x_{l-1}])\),其中 \([\cdot]\) 表示沿通道维度拼接。 这鼓励特征复用,加强梯度流,也减少总参数量。
-
高效架构 (efficient architectures) 面向的是移动设备和边缘硬件的部署场景,这些场景下算力、内存、能耗都紧张。
-
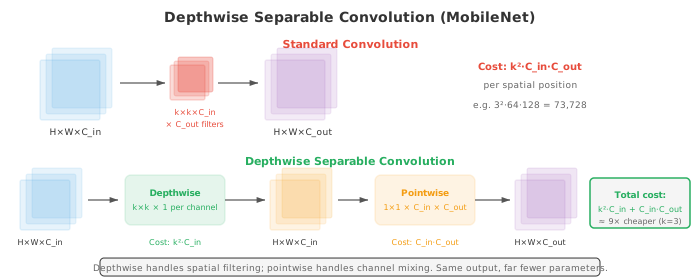
MobileNet (Howard et al., 2017) 用深度可分离卷积 (depthwise separable convolutions) 取代标准卷积,把这个操作拆成两步:
- 深度卷积 (depthwise convolution):对每个输入通道用一个 \(k \times k\) 的滤波器 (不做跨通道交互)
- 点卷积 (pointwise convolution):用 1x1 卷积把通道间的信息组合起来
-
一个标准的 \(k \times k\) 卷积,有 \(C_{\text{in}}\) 个输入通道和 \(C_{\text{out}}\) 个输出通道,每个空间位置要算 \(k^2 \cdot C_{\text{in}} \cdot C_{\text{out}}\) 次乘法。 深度可分离卷积只要 \(k^2 \cdot C_{\text{in}} + C_{\text{in}} \cdot C_{\text{out}}\),大约省了 \(k^2\) 倍。 对 3x3 滤波器来说,大约省 9 倍。
-
MobileNet-V2 引入了倒残差块 (inverted residual block):先用 1x1 卷积把通道扩上去,在扩大的空间里做深度卷积,然后再用 1x1 卷积投影回来。 跳跃连接放在窄的 (瓶颈) 层上,正好把 ResNet 的模式倒过来。 扩张比通常取 6.
-
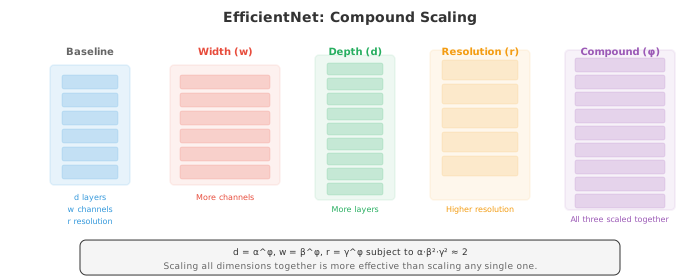
EfficientNet (Tan and Le, 2019) 引入了复合缩放 (compound scaling):不再单独缩放深度、宽度或分辨率,而是三个维度按固定比例一起缩。 给定一个缩放系数 \(\phi\):
- 约束 \(\alpha \cdot \beta^2 \cdot \gamma^2 \approx 2\) (这样 \(\phi\) 每加 1,总计算量大致翻倍). 网格搜索给出基线比例 \(\alpha = 1.2\), \(\beta = 1.1\), \(\gamma = 1.15\). EfficientNet-B0 到 B7 依次放大,用比以往模型少得多的参数和 FLOPs 达到了当时的最先进准确率。
-
ShuffleNet 通过组卷积 (group convolutions) 加通道混洗 (channel shuffle) 来削减 1x1 卷积的开销 (在 MobileNet 系列里 1x1 卷积是主要瓶颈). 组卷积把通道分组,每组内部独立卷积,但这会阻断跨组信息流动。 混洗操作在组之间重排通道,用几乎为零的代价恢复了信息混合。
-
迁移学习 (transfer learning) 是把在一个任务上训好的模型拿来适配另一个任务。 在计算机视觉里,这几乎总是意味着从 ImageNet (140 万张图,1000 类) 预训练的模型出发,适配到特定领域的数据集上 (医学图像、卫星图像、工业缺陷之类).
-
特征提取 (feature extraction):冻结所有卷积层,去掉最后的分类头,只在上面训一个新的分类头。 冻住的层就是通用特征提取器。 当目标领域和 ImageNet 相似、目标数据集又小的时候,这招很好使。
-
微调 (fine-tuning):解冻部分或全部卷积层,用一个很小的学习率训练。 预训练权重是起点,而不是固定特征。 微调通常先解冻后面的层 (它们捕获的是高层、任务相关的特征),需要的话也可以再解冻更前面的层。
-
迁移学习之所以有效,是因为 CNN 的浅层学到的是通用特征 (边缘、纹理、颜色),跨任务都能用;而深层学的才是任务相关的特征。 一个训来分类动物的网络,边缘检测器照样能拿去分类建筑物。
-
CNN 可视化 (Visualising CNNs) 能揭示网络学到了什么,也能帮你调试意外行为。
-
激活图 (activation maps) (特征图) 展示每个滤波器对输入图像的输出。 浅层激活看起来像边缘图;深层输出越来越抽象,空间上也越来越粗。
-
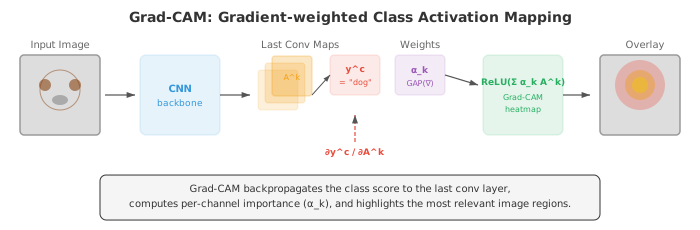
Grad-CAM (Gradient-weighted Class Activation Mapping, Selvaraju et al., 2017) 高亮出输入图中对模型预测贡献最大的区域。 步骤是:
- 算目标类得分对最后一层卷积特征图的梯度 (用第 03 章讲的链式法则)
- 对这些梯度做全局平均池化,得到每个通道的重要性权重
- 用特征图做加权组合,再套一次 ReLU
- 其中 \(A^k\) 是第 \(k\) 个特征图,\(\alpha_k\) 是通道 \(k\) 的重要性权重,\(y^c\) 是类别 \(c\) 的得分。 结果是一张粗粒度热力图,显示哪些区域驱动了分类判断。 之所以套 ReLU,是因为我们只关心对当前类有正向影响的特征。
-
特征反演 (feature inversion) 从特征表示反推出输入图像,做法是优化一张随机图去匹配目标特征 (对像素值做梯度下降). 这能揭示网络在每一层还保留了哪些信息。 浅层能重建出几乎完美的图像;深层重建出的图能认出内容但已经变形,说明网络丢掉了精细的空间细节,但保住了语义内容。
-
Deep Dream 和神经风格迁移 (neural style transfer) 是特征可视化的创意应用。 Deep Dream 最大化某一选定层的神经元激活,生成超现实的、模式被放大的图像。 神经风格迁移则优化一张目标图,让它同时匹配一张图的内容特征 (来自深层) 和另一张图的风格特征 (滤波器激活的 Gram 矩阵,描述纹理统计).
Coding Tasks (use CoLab or notebook)
-
Implement a simple CNN from scratch in JAX with two convolutional layers, max pooling, and a classification head. Train it on a synthetic 2D pattern classification task.
import jax import jax.numpy as jnp import jax.lax as lax import matplotlib.pyplot as plt def conv2d(x, kernel, stride=1): """单输入、单滤波器的简单 2D 卷积.""" return lax.conv(x[None, None], kernel[None, None], (stride, stride), 'SAME')[0, 0] def max_pool(x, size=2): """2x2 最大池化.""" H, W = x.shape x = x[:H//size*size, :W//size*size] return x.reshape(H//size, size, W//size, size).max(axis=(1, 3)) def init_cnn(key): k1, k2, k3 = jax.random.split(key, 3) return { 'conv1': jax.random.normal(k1, (5, 5)) * 0.3, 'conv2': jax.random.normal(k2, (3, 3)) * 0.3, 'fc_w': jax.random.normal(k3, (64, 1)) * 0.1, 'fc_b': jnp.zeros(1), } def forward_cnn(params, img): # Conv1 -> ReLU -> Pool h = jnp.maximum(0, conv2d(img, params['conv1'])) h = max_pool(h) # Conv2 -> ReLU -> Pool h = jnp.maximum(0, conv2d(h, params['conv2'])) h = max_pool(h) # 展平后分类 flat = h.ravel() # 补齐或截断到固定尺寸 flat = jnp.pad(flat, (0, max(0, 64 - len(flat))))[:64] logit = (flat @ params['fc_w'] + params['fc_b']).squeeze() return jax.nn.sigmoid(logit) # 生成合成数据: 类 0 = 低频模式, 类 1 = 高频模式 def make_data(key, n=200): images, labels = [], [] for i in range(n): k1, key = jax.random.split(key) x, y = jnp.meshgrid(jnp.linspace(0, 4*jnp.pi, 32), jnp.linspace(0, 4*jnp.pi, 32)) if i < n // 2: img = jnp.sin(x) + jax.random.normal(k1, (32, 32)) * 0.1 labels.append(0) else: img = jnp.sin(4 * x) * jnp.sin(4 * y) + jax.random.normal(k1, (32, 32)) * 0.1 labels.append(1) images.append(img) return images, jnp.array(labels, dtype=jnp.float32) key = jax.random.PRNGKey(42) images, labels = make_data(key) params = init_cnn(jax.random.PRNGKey(0)) def loss_fn(params, img, label): pred = forward_cnn(params, img) return -(label * jnp.log(pred + 1e-7) + (1 - label) * jnp.log(1 - pred + 1e-7)) grad_fn = jax.grad(loss_fn) lr = 0.01 for epoch in range(5): total_loss = 0.0 for img, label in zip(images, labels): grads = grad_fn(params, img, label) params = {k: params[k] - lr * grads[k] for k in params} total_loss += loss_fn(params, img, label) print(f"Epoch {epoch}: loss = {total_loss / len(images):.4f}") # 测试准确率 preds = jnp.array([forward_cnn(params, img) > 0.5 for img in images]) acc = jnp.mean(preds == labels) print(f"Accuracy: {acc:.2%}") -
Visualise how different filter sizes affect the receptive field. Show that two stacked 3x3 filters cover the same receptive field as one 5x5 filter but with fewer parameters.
import jax.numpy as jnp import matplotlib.pyplot as plt def compute_receptive_field(layers): """从 (kernel_size, stride) 元组列表计算感受野大小.""" rf = 1 # 从 1 个像素起步 stride_product = 1 for k, s in layers: rf += (k - 1) * stride_product stride_product *= s return rf # 比较架构 configs = { 'Single 5x5': [(5, 1)], 'Two 3x3': [(3, 1), (3, 1)], 'Three 3x3': [(3, 1), (3, 1), (3, 1)], 'Single 7x7': [(7, 1)], '3x3 stride 2 + 3x3': [(3, 2), (3, 1)], } print(f"{'Config':<25} {'RF':>4} {'Params (per channel)':>20}") print('-' * 55) for name, layers in configs.items(): rf = compute_receptive_field(layers) # 参数量: 各层 k^2 之和 (每对输入-输出通道) params = sum(k * k for k, s in layers) print(f"{name:<25} {rf:>4} {params:>20}") # 可视化感受野 fig, axes = plt.subplots(1, 3, figsize=(14, 4)) for ax, (name, rf_size) in zip(axes, [('5x5 filter', 5), ('Two 3x3 filters', 5), ('Three 3x3 filters', 7)]): grid = jnp.zeros((9, 9)) c = 4 # 中心 half = rf_size // 2 grid = grid.at[c-half:c+half+1, c-half:c+half+1].set(1.0) ax.imshow(grid, cmap='Blues', vmin=0, vmax=1) ax.set_title(f'{name}\nRF = {rf_size}x{rf_size}') ax.set_xticks(range(9)); ax.set_yticks(range(9)) ax.grid(True, alpha=0.3) plt.suptitle('Receptive Field Comparison') plt.tight_layout(); plt.show() -
Implement Grad-CAM from scratch. Given a pre-built simple CNN, compute the gradient-weighted activation map for a specific class and visualise it as a heatmap.
import jax import jax.numpy as jnp import matplotlib.pyplot as plt def simple_cnn(params, img): """一个同时返回预测和最后一层卷积激活的简单 CNN.""" # 卷积层 (作为 Grad-CAM 的"最后一层卷积") H, W = img.shape k = params['conv'].shape[0] pad = k // 2 img_pad = jnp.pad(img, pad, mode='edge') activation_map = jnp.zeros((H, W)) for i in range(H): for j in range(W): activation_map = activation_map.at[i, j].set( jnp.sum(img_pad[i:i+k, j:j+k] * params['conv']) ) activation_map = jnp.maximum(0, activation_map) # ReLU # 全局平均池化 -> 全连接 -> 输出 pooled = activation_map.mean() logit = pooled * params['w'] + params['b'] return jax.nn.sigmoid(logit), activation_map # 构造测试图: 左侧一块亮区 (作为类别指示) img = jnp.zeros((32, 32)) img = img.at[8:24, 4:16].set(1.0) img = img.at[5:10, 20:28].set(0.3) key = jax.random.PRNGKey(42) params = { 'conv': jax.random.normal(key, (5, 5)) * 0.3, 'w': jnp.array(2.0), 'b': jnp.array(-0.5), } # 计算 Grad-CAM # 关键: 需要类得分对最后一层卷积特征图的梯度, 不是对输入图的梯度 # PyTorch 中用 forward_hook + backward_hook 抓取激活和梯度, # JAX 的函数式等价做法: 把特征图作为"变量"喂给 grad pred, act_map = simple_cnn(params, img) # 把得分写成只依赖激活图的函数 — 等价于 hook 抓到的激活 def score_from_act(act_map): pooled = act_map.mean() logit = pooled * params['w'] + params['b'] return jax.nn.sigmoid(logit) # grad_act = ∂score/∂act_map — 这才是 Grad-CAM 公式里需要的梯度 grad_act = jax.grad(score_from_act)(act_map) # 权重 = 梯度对空间维度做全局平均池化 (Grad-CAM 的 α_k) # 多通道时每个通道独立算, 单通道场景等价于全局均值 alpha = grad_act.mean() grad_cam = jnp.maximum(0, alpha * act_map) # ReLU: 只保留正向贡献 grad_cam = (grad_cam - grad_cam.min()) / (grad_cam.max() - grad_cam.min() + 1e-8) fig, axes = plt.subplots(1, 3, figsize=(14, 4)) axes[0].imshow(img, cmap='gray'); axes[0].set_title('Input Image'); axes[0].axis('off') axes[1].imshow(act_map, cmap='viridis'); axes[1].set_title('Activation Map'); axes[1].axis('off') axes[2].imshow(img, cmap='gray', alpha=0.6) axes[2].imshow(grad_cam, cmap='jet', alpha=0.4) axes[2].set_title(f'Grad-CAM (pred={pred:.2f})'); axes[2].axis('off') plt.tight_layout(); plt.show() -
Compare depthwise separable convolution with standard convolution. Count the parameters and FLOPs for both and show they produce similar outputs with far less computation.
import jax import jax.numpy as jnp def standard_conv(x, kernel): """标准卷积: (H, W, C_in) * (k, k, C_in, C_out) -> (H, W, C_out).""" H, W, C_in = x.shape k, _, _, C_out = kernel.shape pad = k // 2 x_pad = jnp.pad(x, ((pad, pad), (pad, pad), (0, 0)), mode='constant') out = jnp.zeros((H, W, C_out)) for i in range(H): for j in range(W): patch = x_pad[i:i+k, j:j+k, :] # (k, k, C_in) for c in range(C_out): out = out.at[i, j, c].set(jnp.sum(patch * kernel[:, :, :, c])) return out def depthwise_separable_conv(x, dw_kernel, pw_kernel): """深度可分离: 深度卷积 (k,k,C_in), 然后点卷积 (C_in, C_out).""" H, W, C_in = x.shape k = dw_kernel.shape[0] pad = k // 2 x_pad = jnp.pad(x, ((pad, pad), (pad, pad), (0, 0)), mode='constant') # 深度卷积: 每个通道一个滤波器 dw_out = jnp.zeros((H, W, C_in)) for i in range(H): for j in range(W): for c in range(C_in): patch = x_pad[i:i+k, j:j+k, c] dw_out = dw_out.at[i, j, c].set(jnp.sum(patch * dw_kernel[:, :, c])) # 点卷积: 跨通道的 1x1 卷积 out = dw_out @ pw_kernel return out # 设置 H, W, C_in, C_out, k = 8, 8, 16, 32, 3 key = jax.random.PRNGKey(42) k1, k2, k3, k4 = jax.random.split(key, 4) x = jax.random.normal(k1, (H, W, C_in)) std_kernel = jax.random.normal(k2, (k, k, C_in, C_out)) * 0.1 dw_kernel = jax.random.normal(k3, (k, k, C_in)) * 0.1 pw_kernel = jax.random.normal(k4, (C_in, C_out)) * 0.1 # 对比 std_params = k * k * C_in * C_out dw_params = k * k * C_in + C_in * C_out std_flops = H * W * k * k * C_in * C_out dw_flops = H * W * (k * k * C_in + C_in * C_out) print(f"Standard conv: {std_params:>8,} params, {std_flops:>10,} FLOPs") print(f"Depthwise separable conv: {dw_params:>8,} params, {dw_flops:>10,} FLOPs") print(f"Parameter reduction: {std_params / dw_params:.1f}x") print(f"FLOP reduction: {std_flops / dw_flops:.1f}x") std_out = standard_conv(x, std_kernel) ds_out = depthwise_separable_conv(x, dw_kernel, pw_kernel) print(f"\nStandard output shape: {std_out.shape}") print(f"Depthwise sep output shape: {ds_out.shape}") -
Implement a simple GAN with label smoothing and feature matching. These two tricks stabilize training and prevent the zero-gradient problem (discriminator too confident, generator gets no signal). Label smoothing replaces 1/0 targets with 0.9/0.1, capping the discriminator's confidence. Feature matching trains the generator to match intermediate discriminator features of real data, not just the final logit (Salimans et al., 2016, Improved Techniques for Training GANs).
import jax
import jax.numpy as jnp
import matplotlib.pyplot as plt

# 简单 2D 数据: 8 个高斯混合 (环形)
key = jax.random.PRNGKey(42)
def sample_real(key, n=200):
    k1, k2 = jax.random.split(key)
    angles = jax.random.uniform(k1, (n,)) * 2 * jnp.pi
    radii = 2.0 + jax.random.normal(k2, (n,)) * 0.3
    return jnp.stack([radii * jnp.cos(angles), radii * jnp.sin(angles)], axis=1)

# 生成器: 把 z 向量映射到 2D 点
def init_gen(key, dim_z=8):
    k1, k2, k3 = jax.random.split(key, 3)
    return {'w1': jax.random.normal(k1, (dim_z, 16)) * 0.1,
            'b1': jnp.zeros(16),
            'w2': jax.random.normal(k2, (16, 16)) * 0.1,
            'b2': jnp.zeros(16),
            'w3': jax.random.normal(k3, (16, 2)) * 0.1,
            'b3': jnp.zeros(2)}

def generator(g_params, z):
    h = jnp.maximum(0, z @ g_params['w1'] + g_params['b1'])
    h = jnp.maximum(0, h @ g_params['w2'] + g_params['b2'])
    return h @ g_params['w3'] + g_params['b3']

# 判别器: 2D 点 -> 得分, 同时返回中间特征用于 feature matching
def init_disc(key):
    k1, k2, k3 = jax.random.split(key, 3)
    return {'w1': jax.random.normal(k1, (2, 32)) * 0.1, 'b1': jnp.zeros(32),
            'w2': jax.random.normal(k2, (32, 16)) * 0.1, 'b2': jnp.zeros(16),
            'w3': jax.random.normal(k3, (16, 1)) * 0.1, 'b3': jnp.zeros(1)}

def discriminator(d_params, x, return_feat=False):
    h = jnp.maximum(0, x @ d_params['w1'] + d_params['b1'])
    h2 = jnp.maximum(0, h @ d_params['w2'] + d_params['b2'])
    logit = h2 @ d_params['w3'] + d_params['b3']
    if return_feat:
        return jax.nn.sigmoid(logit), h2  # 返回中间层特征
    return jax.nn.sigmoid(logit)

# 训练
dim_z = 8
lr = 0.01
k1, k2 = jax.random.split(key)
g_params = init_gen(k1)
d_params = init_disc(k2)

def d_loss(d_params, real, fake):
    # Label smoothing: real = 0.9, fake = 0.1
    real_score = discriminator(d_params, real)
    fake_score = discriminator(d_params, fake)
    real_loss = -0.9 * jnp.log(real_score + 1e-7) - 0.1 * jnp.log(1 - real_score + 1e-7)
    fake_loss = -0.1 * jnp.log(fake_score + 1e-7) - 0.9 * jnp.log(1 - fake_score + 1e-7)
    return real_loss.mean() + fake_loss.mean()

def g_loss(g_params, d_params, z, real):
    fake = generator(g_params, z)
    _, fake_feat = discriminator(d_params, fake, return_feat=True)
    # 标准对抗损失
    fake_score = discriminator(d_params, fake)
    adv_loss = -jnp.log(fake_score + 1e-7).mean()
    # Feature matching: 匹配真实和假的中间特征统计量
    _, real_feat = discriminator(d_params, real, return_feat=True)
    feat_loss = jnp.mean((fake_feat.mean(0) - real_feat.mean(0))**2)
    return adv_loss + 10.0 * feat_loss  # 特征匹配权重 10.0

d_grad_fn = jax.grad(d_loss)
g_grad_fn = jax.grad(g_loss)

for step in range(3000):
    k1, k2, key = jax.random.split(key, 3)
    real = sample_real(k1, 64)
    z = jax.random.normal(k2, (64, dim_z))
    fake = generator(g_params, z)

    # 更新判别器
    d_grads = d_grad_fn(d_params, real, fake)
    d_params = {k: d_params[k] - lr * d_grads[k] for k in d_params}
    # 更新生成器
    g_grads = g_grad_fn(g_params, d_params, z, real)
    g_params = {k: g_params[k] - lr * g_grads[k] for k in g_params}

    if step % 500 == 0:
        real_score = discriminator(d_params, real).mean()
        fake_score = discriminator(d_params, fake).mean()
        print(f"Step {step:4d}  D(real)={real_score:.3f}  D(fake)={fake_score:.3f}")

# 可视化
z_test = jax.random.normal(key, (500, dim_z))
fake_samples = generator(g_params, z_test)
real_samples = sample_real(key, 500)

plt.figure(figsize=(8, 4))
plt.subplot(121)
plt.scatter(real_samples[:, 0], real_samples[:, 1], alpha=0.5, label='Real')
plt.scatter(fake_samples[:, 0], fake_samples[:, 1], alpha=0.5, label='Generated')
plt.legend(); plt.title('Label Smoothing + Feature Matching')
plt.axis('equal')
plt.subplot(122)
# 打标签来检查模式崩溃
plt.hist2d(fake_samples[:, 0], fake_samples[:, 1], bins=30, range=[[-3, 3], [-3, 3]])
plt.title('Generated Distribution')
plt.tight_layout(); plt.show()

print("\n--- 两个技巧的作用 ---")
print("Label smoothing (0.9/0.1): 防止判别器过于自信, 保证梯度不消失")
print("Feature matching: 生成器不只看最终判别得分, 还匹配中间特征统计量, 降低模式崩溃")
📌 本节要点
- 卷积三超参:步长控制下采样,填充控制边界,膨胀控制感受野扩张而不加参数。
- 输出尺寸公式: \(\text{out} = \lfloor (\text{in} + 2p - d(k-1) - 1)/s \rfloor + 1\) (含膨胀率 \(d\),默认 \(d=1\) 时退化为 \(\lfloor (\text{in} - k + 2p)/s \rfloor + 1\)),对高宽独立生效。
- 感受野层层扩大:浅层看局部边缘,深层看物体部件,每加一层大致扩 \(k-1\) 像素。
- 池化与 GAP:最大/平均池化下采样,全局平均池化替代全连接层,大幅减参并起结构正则化作用。
- 正则化组合拳: BatchNorm 稳训练,空间 Dropout 丢通道,数据增强 (含 Mixup、CutMix、RandAugment) 强化不变性。
- 架构演进主线: LeNet 证概念 → AlexNet 用 ReLU+GPU 引爆 → VGG 堆 3x3 → Inception 多尺度并行 → ResNet 用残差连接堆到 152 层。
- DenseNet 稠密连接:每层拼接所有前层输出,极致特征复用,强化梯度流。
- 移动端高效卷积:深度可分离卷积把 \(k^2 \cdot C_{\text{in}} \cdot C_{\text{out}}\) 降到 \(k^2 \cdot C_{\text{in}} + C_{\text{in}} \cdot C_{\text{out}}\),约省 9 倍。
- EfficientNet 复合缩放:深度、宽度、分辨率按固定比例一起放,约束 \(\alpha \cdot \beta^2 \cdot \gamma^2 \approx 2\).
- 迁移学习与可视化: ImageNet 预训练 + 特征提取/微调是视觉迁移的标准范式;Grad-CAM 用梯度加权特征图给出决策热力图。