信息论
一句话总结:信息论用熵、交叉熵、KL 散度、互信息量化不确定性和分布差异,支撑分类损失、VAE 目标和数据压缩的一整套现代 ML 基础。
信息论量化信息、惊奇度以及概率分布之间的差异。本节讲熵 (entropy)、交叉熵 (cross-entropy)、KL 散度 (Kullback-Leibler divergence, KL divergence)、互信息 (mutual information) 与自信息 (surprisal),这些概念是 ML 里每一个分类损失函数、变分自编码器 (Variational Autoencoder, VAE) 目标函数以及数据压缩方案背后的核心思想.
-
信息论由克劳德·香农 (Claude Shannon) 于 1948 年创立,给了我们一个量化"信息"的数学框架。它回答的问题包括:某个事件应该让你有多惊奇?一条消息携带多少信息?两个概率分布相差多远?
-
这些问题听起来抽象,但正是 ML 损失函数、数据压缩和通信系统的地基。分类里最常用的交叉熵损失,就是直接从信息论里长出来的。
-
从最简单的问题开始:单个事件携带多少信息?
-
自信息 (surprisal,也叫 self-information) 衡量一个事件有多让人意外。如果发生的是几乎必然的事,你几乎学不到东西;如果发生的是罕见事件,你就学到了很多。
-
你住在沙漠里,别人告诉你今天出太阳,这不太算信息。可要是有人告诉你今天下雪了,那就极其震撼。自信息把这种直觉写成公式:
-
用 \(\log_2\) 时,单位是比特 (bit)。一次公平的抛硬币,自信息 \(-\log_2(0.5) = 1\) 比特。概率为 \(1/8\) 的事件,自信息 \(\log_2(8) = 3\) 比特。
-
为什么用对数,而不是直接 \(1/p\)?三个原因:
- 必然事件 (\(p = 1\)) 应该带来零信息:\(\log(1) = 0\),但 \(1/1 = 1\)。
- 独立事件的信息应该可加:\(\log(1/p_1 p_2) = \log(1/p_1) + \log(1/p_2)\)。
- 我们想要平滑、行为良好的函数。\(1/p\) 会爆炸,而 \(\log(1/p)\) 增长很温和。
-
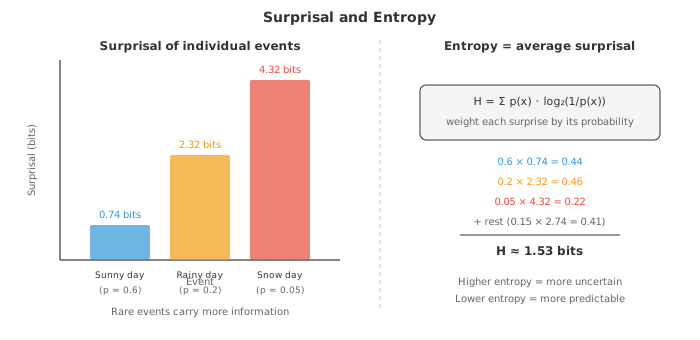
熵 (entropy) 就是自信息的期望,即从某个分布采样时平均每个事件携带多少信息。它度量分布本身的不确定性或"不可预测性":
-
公平硬币的熵 \(H = -0.5\log_2(0.5) - 0.5\log_2(0.5) = 1\) 比特。不确定性最大。
-
一枚 \(p = 0.9\) 的偏心硬币,熵 \(H = -0.9\log_2(0.9) - 0.1\log_2(0.1) \approx 0.469\) 比特。不确定性变小,熵也变小。
-
确定性事件 (\(p = 1\)) 的熵 \(H = 0\)。完全没有不确定性。
-
当所有结果等可能时,熵取到最大。对 \(n\) 个等可能结果,\(H = \log_2 n\)。公平骰子的熵 \(\log_2 6 \approx 2.585\) 比特。
-
熵的实际意义是压缩。香农的信源编码定理告诉我们:无损压缩数据不可能低于它的熵率。一张每个像素等可能取值的图 (熵最大) 无法压缩;一张几乎全白的图 (熵很低) 就能压得很小。
-
感受一下量级:一个灰度像素 (256 个取值) 的最大熵是 8 比特。一张 1080p 灰度图最多 \(1920 \times 1080 \times 8 \approx 1660\) 万比特。真实图片的熵远比这低,因为相邻像素高度相关——这正是 JPEG 压缩起作用的原因。
-
换到连续随机变量,离散求和就变成积分。微分熵 (differential entropy) 是:
-
方差为 \(\sigma^2\) 的高斯分布的微分熵 \(h = \frac{1}{2}\log_2(2\pi e \sigma^2)\)。在所有方差相同的分布里,高斯的微分熵最大。这也是高斯在建模中如此常见的一个原因:除了给定的均值和方差,它不再多做任何假设。
-
互信息 (mutual information) 衡量知道一个变量能告诉你多少关于另一个变量的东西。它是观测到 \(Y\) 之后,对 \(X\) 不确定性的减少量:
- 也可以写成:
-
如果 \(X\) 与 \(Y\) 独立,\(p(x,y) = p(x)p(y)\),互信息为零。它们越相关,互信息越大。
-
在 ML 里,互信息用于特征选择 (挑选与目标互信息高的特征)、信息瓶颈方法、以及评估聚类质量。
-
跨章提示:互信息在 第 06 章 01. 经典机器学习 中用于决策树的信息增益分裂准则 (\(H(\text{parent}) - H(\text{child})\) 就是互信息),也在特征选择中用于衡量"这个特征能告诉我多少关于目标的东西"。
-
交叉熵 (cross-entropy) 衡量的是:用为分布 \(q\) 优化好的编码来编码分布 \(p\) 的事件时,平均需要多少比特:
-
如果 \(q\) 完美匹配 \(p\),交叉熵就等于熵:\(H(p, p) = H(p)\)。如果 \(q\) 是个糟糕的近似,交叉熵就更高。多出来的比特,就是"不匹配"的代价。
-
这正是 ML 里交叉熵成为分类标准损失函数的原因。真实标签定义了 \(p\) (一个 one-hot 分布),模型的预测概率定义了 \(q\)。最小化交叉熵,就是把 \(q\) 推向 \(p\):
-
对单个真实类别为 \(c\) 的样本,上式化简为 \(\mathcal{L} = -\log \hat{y}_c\)。损失就是模型对真实类别所预测概率的自信息。如果模型给正确类别的概率很高,损失就很低。
-
跨章提示:交叉熵损失在 第 06 章 02. 梯度机器学习 中作为逻辑回归的二元交叉熵 (Binary Cross-Entropy, BCE) 和 Softmax 回归的多类交叉熵 (Categorical Cross-Entropy, CCE) 出现,并在那里与最大似然估计建立了等价关系。
-
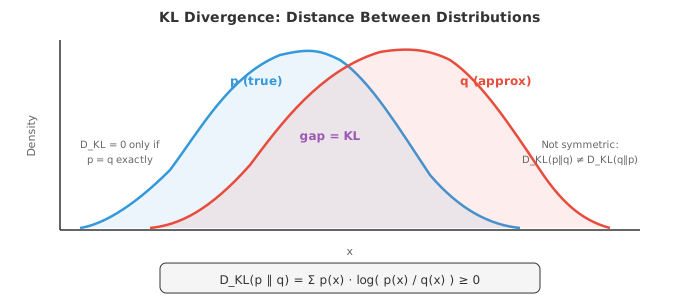
KL 散度 (Kullback-Leibler divergence, KL divergence,又称相对熵) 衡量一个分布与另一个分布相差多远:
- KL 散度就是用分布 \(q\) 代替真实分布 \(p\) 所付出的"额外代价"。它始终非负 (\(D_{\text{KL}} \ge 0\)),当且仅当 \(p = q\) 时为零。
-
KL 散度不对称:\(D_{\text{KL}}(p \| q) \ne D_{\text{KL}}(q \| p)\)。这种不对称很重要。\(D_{\text{KL}}(p \| q)\) 会惩罚 \(q\) 在 \(p\) 高概率处放低概率的情形 (因为 \(\log(p/q)\) 会炸开), \(D_{\text{KL}}(q \| p)\) 惩罚的则是反向的错配。
-
这种不对称派生出两种近似风格:
- 最小化 \(D_{\text{KL}}(p \| q)\) 得到矩匹配 (moment-matching) 行为:\(q\) 覆盖 \(p\) 的所有模式,但可能过于铺开。
- 最小化 \(D_{\text{KL}}(q \| p)\) 得到寻模 (mode-seeking) 行为:\(q\) 集中在 \(p\) 的某个模式上,但可能漏掉其他模式。变分推断用的就是这一种。
-
由于 \(H(p)\) 对模型来说是常数,最小化交叉熵 \(H(p, q)\) 等价于最小化 \(D_{\text{KL}}(p \| q)\)。这就是为什么我们用交叉熵损失时,也在同时最小化真实分布与预测分布之间的 KL 散度。
-
KL 散度在贝叶斯更新里也是核心角色。后验 \(P(\theta | D)\) 就是在与观测数据一致的所有分布里,与先验 \(P(\theta)\) 在 KL 意义下最接近的那个。每一次新观测都会更新后验,使对 \(\theta\) 的不确定性下降。
-
在变分自编码器 (Variational Autoencoder, VAE) 里,损失函数由两项组成:一项是重构损失 (交叉熵),另一项是把潜空间拉向标准正态分布的 KL 散度正则项。
-
跨章提示: VAE 里的 KL 正则项在 第 06 章 03. 深度学习 中详细展开,那里会看到 KL 项如何把后验 \(q(z|x)\) 推向先验 \(p(z) = \mathcal{N}(0, I)\),从而保证潜空间光滑、可采样。KL 散度是变分推断 (Variational Inference, VI) 与 ELBO (Evidence Lower Bound) 目标函数的核心工具,后续 LLM/生成模型章节还会反复用到。
-
把这一切串起来:熵告诉你一个分布内在的不确定性,交叉熵告诉你模型对现实的近似程度,KL 散度告诉你二者之间的差距。这三个量,就是现代 ML 优化的骨架。
编程任务 (用 CoLab 或 notebook)
-
计算若干分布的熵,验证在给定结果数下,均匀分布的熵最大。
import jax.numpy as jnp def entropy(p): """以比特为单位计算熵, 过滤掉零概率事件.""" p = p[p > 0] return -jnp.sum(p * jnp.log2(p)) # 公平骰子 fair = jnp.ones(6) / 6 print(f"Fair die entropy: {entropy(fair):.4f} bits (max = log2(6) = {jnp.log2(6.):.4f})") # 灌铅骰子 loaded = jnp.array([0.1, 0.1, 0.1, 0.1, 0.1, 0.5]) print(f"Loaded die entropy: {entropy(loaded):.4f} bits") # 确定性 det = jnp.array([0.0, 0.0, 0.0, 0.0, 0.0, 1.0]) print(f"Deterministic: {entropy(det):.4f} bits") # 公平硬币 coin = jnp.array([0.5, 0.5]) print(f"Fair coin entropy: {entropy(coin):.4f} bits") -
计算真实分布与几种近似之间的交叉熵与 KL 散度,验证 \(D_{\text{KL}}(p \| q) = H(p, q) - H(p)\)。
import jax.numpy as jnp def cross_entropy(p, q): return -jnp.sum(p * jnp.log2(jnp.clip(q, 1e-10, 1.0))) def kl_divergence(p, q): mask = p > 0 return jnp.sum(jnp.where(mask, p * jnp.log2(p / jnp.clip(q, 1e-10, 1.0)), 0.0)) def entropy(p): p = p[p > 0] return -jnp.sum(p * jnp.log2(p)) p = jnp.array([0.4, 0.3, 0.2, 0.1]) # 真实分布 for name, q in [("perfect match", p), ("slight mismatch", jnp.array([0.35, 0.30, 0.25, 0.10])), ("big mismatch", jnp.array([0.1, 0.1, 0.1, 0.7]))]: h_p = entropy(p) h_pq = cross_entropy(p, q) kl = kl_divergence(p, q) print(f"{name:20s}: H(p)={h_p:.4f}, H(p,q)={h_pq:.4f}, " f"KL={kl:.4f}, H(p,q)-H(p)={h_pq-h_p:.4f}") -
通过对两个不同分布计算 \(D_{\text{KL}}(p \| q)\) 和 \(D_{\text{KL}}(q \| p)\),展示 KL 散度并不对称。
import jax.numpy as jnp def kl_div(p, q): mask = p > 0 return float(jnp.sum(jnp.where(mask, p * jnp.log2(p / jnp.clip(q, 1e-10, 1.0)), 0.0))) p = jnp.array([0.9, 0.1]) q = jnp.array([0.5, 0.5]) print(f"D_KL(p || q) = {kl_div(p, q):.4f}") print(f"D_KL(q || p) = {kl_div(q, p):.4f}") print(f"Not the same! KL divergence is asymmetric.") -
模拟训练过程中的交叉熵损失。构造一个"真实"的 one-hot 标签,展示当模型预测概率变好时,损失是如何下降的。
import jax.numpy as jnp
import matplotlib.pyplot as plt

# 真实标签: 4 类中的第 2 类
true_label = jnp.array([0, 0, 1, 0])

# 模拟预测不断变好的过程
steps = []
losses = []
for confidence in jnp.linspace(0.25, 0.99, 50):
    # 模型对 class 2 越来越有信心
    remaining = (1 - confidence) / 3
    pred = jnp.array([remaining, remaining, confidence, remaining])
    loss = -jnp.sum(true_label * jnp.log(jnp.clip(pred, 1e-10, 1.0)))
    steps.append(float(confidence))
    losses.append(float(loss))

plt.figure(figsize=(8, 4))
plt.plot(steps, losses, color="#e74c3c", linewidth=2)
plt.xlabel("Model confidence in true class")
plt.ylabel("Cross-entropy loss")
plt.title("Cross-entropy loss decreases as predictions improve")
plt.grid(alpha=0.3)
plt.show()
📌 本节要点
- 自信息:事件越罕见,自信息越大;定义为 \(-\log_2 p(x)\),用比特度量。
- 熵:自信息的期望,度量分布的整体不确定性,均匀分布时取最大。
- 压缩极限:香农源编码定理指出无损压缩不能低于熵率,这是 JPEG/PNG 有效的根本原因。
- 微分熵:连续分布的熵,方差固定时高斯取到最大。
- 互信息:观测一个变量对另一个变量不确定性的减少量,独立时为零。
- 交叉熵:用 \(q\) 编码来自 \(p\) 的事件的平均比特数,是分类任务的标准损失。
- KL 散度:用 \(q\) 近似 \(p\) 的额外代价,非负且不对称,\(D_{\text{KL}}(p \| q) \ne D_{\text{KL}}(q \| p)\)。
- 交叉熵与 KL 的关系:因 \(H(p)\) 固定,最小化交叉熵等价于最小化 \(D_{\text{KL}}(p \| q)\)。
- 两种近似风格:最小化 \(D_{\text{KL}}(p \| q)\) 得到矩匹配,最小化 \(D_{\text{KL}}(q \| p)\) 得到寻模 (变分推断)。
- 在 VAE 里:损失 = 重构交叉熵 + 潜空间到标准正态的 KL 散度正则项。