优化¶
一句话总结:优化是模型训练的数学核心,本节从零点、临界点、凸性讲到梯度下降、牛顿法、拉格朗日乘子,再到驱动现代深度学习的 SGD、Adam 等优化器。
优化是模型训练的数学内核,目的是找到让损失函数最小的参数。 本节涵盖临界点、凸性、梯度下降、牛顿法、用拉格朗日乘子做约束优化,以及推动现代深度学习的优化器 (随机梯度下降 SGD、Adam).
-
训练神经网络、拟合回归直线、调超参数:几乎所有机器学习 (Machine Learning, ML) 算法的核心都是一个优化问题。
-
我们有一个函数 (损失、代价或目标函数),想找到能让它尽可能小 (或尽可能大) 的输入。
-
在优化之前,我们先要理解函数的零点 (或称根). \(f(x)\) 的零点就是让 \(f(x) = 0\) 的那个 \(x\). 从图像上看,就是 x 轴的截距。
-
举个例子,\(f(x) = x^2 - 3x + 2 = (x-1)(x-2)\) 的零点是 \(x = 1\) 和 \(x = 2\). 两个零点之间,函数为负 (\(f(1.5) = -0.25\));零点之外,函数为正。 零点把数轴切成了几段,每段内函数保持同一个正负号。
-
零点的重数 (multiplicity) 就是对应因式出现的次数。
-
单重零点 (重数为 1) 处,图像穿过 x 轴。 双重零点 (重数为 2) 处,图像触到 x 轴但会弹回去,不穿过,那一点看起来"平平的".
-
找零点为什么重要?因为导数 \(f'(x)\) 的零点就是 \(f(x)\) 的临界点 (critical point),也就是极大值和极小值的候选位置。
-
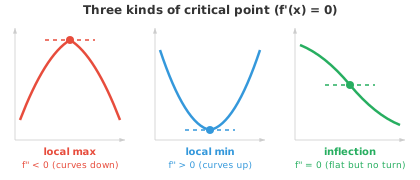
在极大值或极小值处,切线是水平的 (斜率为 0),所以 \(f'(x) = 0\).
-
但不是每个临界点都是极大值或极小值。 \(f'(x) = 0\) 的点也可能是拐点 (inflection point),比如 \(f(x) = x^3\) 在 \(x = 0\) 处,函数在这一点瞬间变平,但方向并没有掉头。
-
二阶导数检验 (second derivative test) 能解决这个问题。 在临界点 \(x = c\) 处,\(f'(c) = 0\),我们看:
- 如果 \(f''(c) > 0\):曲线在这里下凹 (像个碗),所以 \(c\) 是局部极小值.
- 如果 \(f''(c) < 0\):曲线在这里上凸 (像座山),所以 \(c\) 是局部极大值.
- 如果 \(f''(c) = 0\):检验失败,需要更高阶导数或其他办法。
-
举个例子,\(f(x) = x^3 - 3x\). 一阶导数是 \(f'(x) = 3x^2 - 3 = 3(x-1)(x+1)\),所以临界点在 \(x = -1\) 和 \(x = 1\). 二阶导数是 \(f''(x) = 6x\). 在 \(x = -1\) 处:\(f''(-1) = -6 < 0\) (局部极大);在 \(x = 1\) 处:\(f''(1) = 6 > 0\) (局部极小).
-
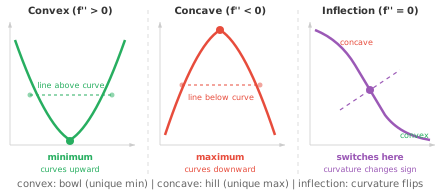
一个函数如果图像上任意两点之间的连线都在图像上方 (或落在图像上),就叫凸函数 (convex). 把它想成一个碗,处处向上弯。 数学上,只要对所有 \(x\) 都有 \(f''(x) \geq 0\),那么 \(f\) 就是凸函数。
-
凸性之所以强大,是因为凸函数有一个漂亮的性质:每个局部极小都是全局极小. 没有那种能把你困住的骗人局部低谷。 把小球滚进一个凸的碗里,它总能滚到最底。
-
一个函数如果 \(-f\) 是凸的,那它就是凹函数 (concave,向下弯). 函数在凹和凸之间切换的点是拐点 (inflection point),出现在 \(f''(x) = 0\) 的位置。
-
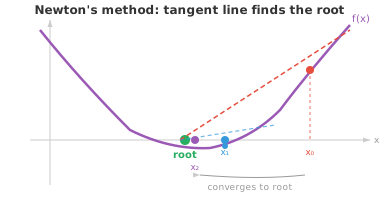
牛顿法 (Newton's method) 用切线来找函数的零点 (顺带也能找导数的零点,也就是临界点). 从一个初始猜测 \(x_0\) 出发,反复迭代:
-
想法很直观:在 \(x_n\) 处画一条切线,看切线在哪里穿过 x 轴,那个交点就作为下一个 \(x_{n+1}\). 对于形状规矩、初值又选得不错的函数,牛顿法收敛得非常快 (二次收敛,意思是每走一步,正确的十进制位数大约翻一倍).
-
举个例子,用牛顿法求 \(\sqrt{5}\) (它是 \(f(x) = x^2 - 5\) 的零点): \(f'(x) = 2x\),所以 \(x_{n+1} = x_n - \frac{x_n^2 - 5}{2x_n}\). 从 \(x_0 = 2\) 开始:\(x_1 = 2.25\), \(x_2 = 2.2361\ldots\),已经精确到小数点后四位了。
-
牛顿法也会翻车:初值离根太远、根附近有 \(f'(x) = 0\)、或者附近有拐点,都可能让它失灵。 而且它需要算导数,有时候导数本身就不便宜。
-
用牛顿法做优化 (找极小值而不是找零点) 时,我们把它用在 \(f'(x) = 0\) 上,更新公式变成:
-
推到多维情形就变成 \(\mathbf{x}_{n+1} = \mathbf{x}_n - H^{-1} \nabla f(\mathbf{x}_n)\),其中 \(H\) 是海森矩阵 (Hessian). 这其实就是上一节的二阶泰勒展开在起作用:把函数近似成一个二次型,直接跳到那个二次型的极小,然后再重复。
-
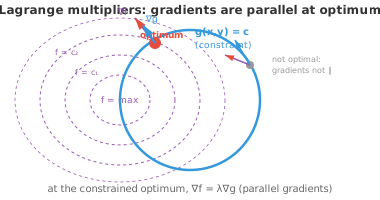
拉格朗日乘子法 (Lagrange multipliers) 用来解约束优化 (constrained optimisation):在约束 \(g(x, y) = c\) 下,求 \(f(x, y)\) 的最优。 我们不再在整个 \(\mathbb{R}^n\) 里搜索,而是被限制在约束成立的那个集合上 (一条曲线或一张曲面).
-
关键的洞察是几何上的:在约束下的最优点处,\(f\) 的梯度必须和 \(g\) 的梯度平行。 如果它们不平行,那我们沿着约束往某个方向走还能继续把 \(f\) 变得更好,也就说明这还不是最优。
-
我们引入一个新变量 \(\lambda\) (拉格朗日乘子),定义拉格朗日函数 (Lagrangian):
⚠️ 符号提醒:\(\lambda\) 在本书里会反复出现,但意思会变
希腊字母 \(\lambda\) (lambda) 在数学和机器学习里是"公用变量名",至少有三种完全不同的含义,靠上下文区分:
- 拉格朗日乘子 (Lagrange Multiplier,本节): \(\lambda\) 度量约束的"影子价格" —— 约束松动一点点,目标函数会变化多少。 单位跟着约束走,无固定符号 (可正可负).
- 正则化系数 (Regularization Coefficient,第 4 章会遇到):在 Ridge 回归 (岭回归) 里,损失变成 \(\|y - X\beta\|^2 + \lambda\|\beta\|^2\),这里的 \(\lambda \geq 0\) 是超参数,控制惩罚项的强度。 它其实是一个隐藏的拉格朗日乘子 (约束 \(\|\beta\|^2 \leq t\) 的对偶形式),所以名字重合并非巧合1.
- 特征值 (Eigenvalue,第 2 章线性代数出现): \(A\mathbf{v} = \lambda\mathbf{v}\) 里的 \(\lambda\) 是矩阵的固有伸缩因子,跟约束/正则化没关系。
看到 \(\lambda\) 时,先问三件事:它挂在约束旁边 (乘子) ? 还是挂在范数惩罚项前 (正则) ? 还是挂在特征向量方程里 (特征值) ? 上下文一秒可辨。
- 把它的所有偏导数都置为零,就得到一组方程,解出来就是约束下的最优点:
- 举个例子,在 \(x^2 + y^2 = 1\) 的约束下求 \(f(x,y) = x^2 y\) 的极大。 拉格朗日函数是 \(\mathcal{L} = x^2 y - \lambda(x^2 + y^2 - 1)\). 求偏导:
-
从第一个方程 (假设 \(x \neq 0\)) 得到:\(\lambda = y\). 代入第二个方程:\(x^2 = 2y^2\). 再结合约束:\(2y^2 + y^2 = 1\),所以 \(y = \frac{1}{\sqrt{3}}\). 最大值为 \(f = \frac{2}{3\sqrt{3}}\).
-
对于不等式约束 (\(g(x,y) \leq c\) 而不是 \(= c\)), 卡罗需-库恩-塔克条件 (Karush-Kuhn-Tucker, KKT) 把拉格朗日乘子法推广了一步。 约束要么是"起作用的" (active,即刻起绑定,当等式处理),要么是"不起作用的" (inactive,解落在可行域内部,约束根本无关).
-
实际工作中,我们几乎不会手算优化。 主要的算法家族有这几种:
-
一阶方法 (只用梯度):梯度下降、随机梯度下降 (Stochastic Gradient Descent, SGD)、Adam. 每一步开销都很小,但收敛可能慢,尤其是问题病态时。
-
二阶方法 (同时用梯度和海森):牛顿法收敛快,但计算并求逆海森矩阵开销大 (参数量为 \(n\) 时是 \(O(n^3)\)). 拟牛顿方法 (Quasi-Newton,例如 BFGS 和 L-BFGS) 只用梯度信息去近似海森矩阵,比一阶方法收敛更快,同时避开了完整的二阶开销。
-
共轭梯度法 (Conjugate gradient):适合大规模稀疏系统,只需要矩阵-向量乘积,不用存整个海森矩阵。
-
高斯-牛顿法 (Gauss-Newton) 与 列文伯格-马夸特法 (Levenberg-Marquardt):专门为最小二乘问题 (回归中常见) 设计,用雅可比矩阵近似海森矩阵。
-
自然梯度下降 (Natural gradient descent):通过费舍尔信息矩阵 (Fisher information matrix) 考虑参数空间的几何结构,对概率模型往往更有效。
-
-
选哪种优化器要看具体问题。 在深度学习里,参数量动辄百万到十亿,算海森矩阵不现实,所以一阶方法 (尤其是 Adam) 占绝对主导。 而对小规模、目标函数光滑的问题,二阶方法可以快出好几个数量级。
编程练习 (用 CoLab 或 notebook)¶
-
实现牛顿法来求 \(\sqrt{7}\) (它是 \(f(x) = x^2 - 7\) 的零点). 观察它收敛得多快。
-
用梯度下降极小化 \(f(x, y) = (x - 3)^2 + (y + 1)^2\). 最小值在 \((3, -1)\). 试试不同的学习率。
import jax import jax.numpy as jnp def f(params): x, y = params return (x - 3)**2 + (y + 1)**2 grad_f = jax.grad(f) params = jnp.array([0.0, 0.0]) lr = 0.1 for i in range(20): g = grad_f(params) params = params - lr * g if i % 5 == 0 or i == 19: print(f"step {i:2d}: ({params[0]:.4f}, {params[1]:.4f}) loss={f(params):.6f}") -
用数值方法解一个约束优化问题。 在 \(x + y = 10\) 的约束下极大化 \(f(x,y) = xy\),通过把 \(y = 10 - x\) 代入,转成单变量函数再求最优。
📌 本节要点¶
- 零点与临界点:函数零点是 \(f(x)=0\) 的位置;导数的零点即临界点,是极值的候选点。
- 二阶导数检验:临界点处 \(f''>0\) 为局部极小,\(f''<0\) 为局部极大,\(f''=0\) 需进一步判断。
- 凸函数:处处向上弯 (\(f''\geq 0\)),每个局部极小都是全局极小,无骗人低谷。
- 牛顿法:用切线迭代求零点,\(x_{n+1}=x_n-f(x_n)/f'(x_n)\),二次收敛,但对初值敏感。
- 优化视角的牛顿法:把牛顿法用于 \(f'(x)=0\),多维形式为 \(\mathbf{x}_{n+1}=\mathbf{x}_n-H^{-1}\nabla f\).
- 拉格朗日乘子:在约束 \(g=c\) 下求 \(f\) 的最优,关键在于 \(\nabla f\) 与 \(\nabla g\) 平行。
- KKT 条件:把拉格朗日乘子法推广到不等式约束,区分起作用与不起作用的约束。
- 一阶 vs 二阶方法:一阶 (SGD/Adam) 廉价但收敛慢;二阶 (牛顿) 收敛快但计算海森开销大。
- 拟牛顿方法: BFGS/L-BFGS 仅用梯度近似海森,兼顾速度与效率。
- 深度学习的选择:参数量巨大,一阶方法 (尤其 Adam) 占主导;小规模光滑问题优选二阶方法。
-
Boyd & Vandenberghe, Convex Optimization (2004), §5.3:带 \(\ell_2\) 约束的最小二乘问题在 KKT 条件下等价于 Ridge 回归,拉格朗日乘子就是正则化系数。 ↩