量化
一句话总结:量化通过降低模型权重与激活的数值精度,换来更小体积、更高吞吐、更低成本,是大模型部署经济可行的关键手段。
🗺️ 本章导览
- 本章覆盖 AI 推理:量化 → 高效架构 → 服务批处理 → 边缘推理 → 扩展部署
- 01. 量化 (本节): INT8/INT4/FP8, PTQ 与 QAT
- 02. 高效架构: MoE,稀疏,蒸馏
- 03. 服务与批处理: continuous batching、KV cache、PagedAttention
- 04. 边缘推理:移动端、嵌入式、片上部署
- 05. 扩展与部署:多机推理、成本优化、SLO
量化降低模型权重与激活的精度,让模型更小、更快、更便宜。本节涵盖数字格式、训练后量化、量化感知训练、仅权重量化方法 (GPTQ、AWQ)、激活量化、混合精度以及 KV 缓存量化。
-
一个 70B 参数模型用 float16 需要 140 GB 内存,超过任何单卡 GPU 的容量。量化到 INT4 后,只要 35 GB (一张 A100) 甚至 20 GB (消费级 RTX 4090 加上 offload) 就装得下。量化不是可有可无的优化点缀,它是让大模型部署在经济上可行的根本。
-
核心权衡:更低精度意味着更少内存、更高吞吐、更低功耗,但会引入量化误差 (quantisation error),有可能拖累模型质量。量化的艺术就是把这种质量下降压到最小。
为什么要量化
-
内存缩减:INT8 比 FP16 小 2 倍,INT4 比 FP16 小 4 倍。对大语言模型 (Large Language Model, LLM) 来说,权重占了绝大部分内存。精度减半,内存需求也减半。
-
吞吐提升:精度越低,每秒能做的运算就越多。NVIDIA Tensor Core (第 16 章) 在 FP16 相对 FP32 上吞吐翻倍,INT8 相对 FP16 再翻倍。INT4 在 Tensor Core 上没有原生计算支持——权重以 INT4 存储、计算前反量化到 FP16,因此吞吐提升来自内存带宽节省 (内存带宽受限场景下近似线性加速),而非计算吞吐再翻倍 (据 NVIDIA H100 whitepaper 2023)。一张 H100 SXM 在 FP8 Tensor Core 上能跑 1,979 TFLOPS (dense,据 NVIDIA H100 datasheet 2023),而 FP32 (非 Tensor Core) 只有 67 TFLOPS —— 差了近 30 倍。
-
带宽节省:LLM 推理通常是内存带宽受限 (memory-bandwidth-bound) 的 (第 16 章,Roofline 模型)。瓶颈是从 GPU 显存里加载权重,而不是拿它们做计算。权重越小,需要搬运的字节就越少,每秒生成的 token 数直接上升。这就是为什么量化对 LLM 推理常常能拿到近乎线性的加速。
-
能耗节省:精度越低,每次运算耗的电就越少。放到数据中心规模 (成千上万张 GPU) 上看,这意味着电费的显著下降。
数字格式
- IEEE 754 浮点格式我们已经在第 13 章 (计算机体系结构) 讲过。这里是 ML 场景下完整的精度全景:
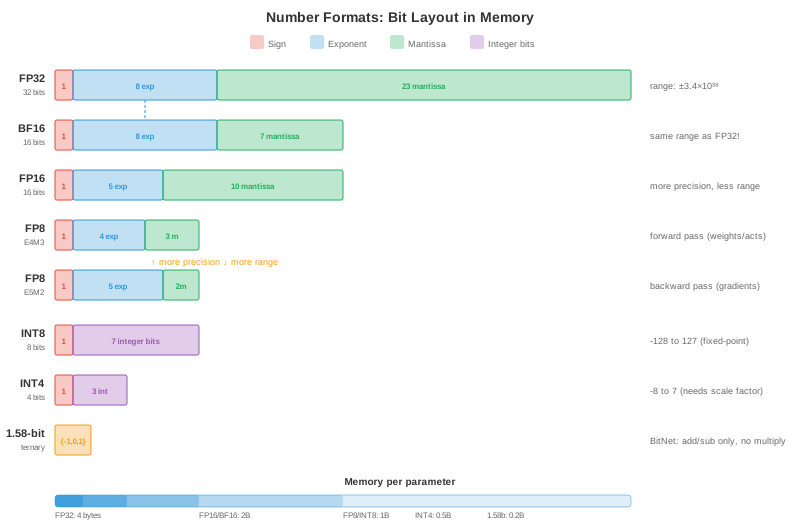
| 格式 | 位数 | 指数位 | 尾数位 | 范围 | 用途 |
|---|---|---|---|---|---|
| FP32 | 32 | 8 | 23 | ±3.4×10³⁸ | 训练 (黄金标准) |
| TF32 | 19 | 8 | 10 | ±3.4×10³⁸ | Tensor Core 训练 (A100+) |
| FP16 | 16 | 5 | 10 | ±65504 | 混合精度训练 |
| BF16 | 16 | 8 | 7 | ±3.4×10³⁸ | 训练 (与 FP32 相同范围) |
| FP8 E4M3 | 8 | 4 | 3 | ±448 | 前向计算 (Hopper+) |
| FP8 E5M2 | 8 | 5 | 2 | ±57344 | 梯度 (范围更宽) |
| INT8 | 8 | — | — | -128 到 127 | PTQ 推理 |
| INT4 | 4 | — | — | -8 到 7 | 仅权重量化 |
| INT2/三值 | 2 | — | — | {-1, 0, 1} | 极限压缩 |
-
FP8 有两个变种:E4M3 (4 位指数、3 位尾数,范围较窄但精度更高) 用于前向传播;E5M2 (5 位指数、2 位尾数,范围更宽但精度较低) 用于梯度。Transformer Engine (第 16 章) 会按张量自动在两者之间切换。
-
BF16 vs FP16: BF16 拥有和 FP32 一样的指数范围 (不会溢出),但尾数精度较低。FP16 精度更高,但范围窄 (最大 65504),训练时需要 loss scaling。用于推理时两者都可以;用于训练时 BF16 更稳。
-
整数格式没有指数位 —— 它们表示定点数。要在浮点和整型之间转换,需要一个缩放因子 (scale factor),有时还需要一个零点 (zero point): \(x_{\text{float}} = \text{scale} \times (x_{\text{int}} - \text{zero\_point})\)。
量化方程
- 所有量化方法都在做同一件事:把浮点值映射到整数,再映射回来:
-
scale 决定了分辨率:\(\text{scale} = \frac{x_{\max} - x_{\min}}{q_{\max} - q_{\min}}\)。对 INT8 来说:\(q_{\min} = -128\), \(q_{\max} = 127\)。
-
对称量化 (symmetric quantisation) 把 \(\text{zero\_point}\) 设为 0,于是 \(\text{scale} = \frac{\max(|x|)}{127}\)。更简单也更快 (推理时不用做零点减法)。
-
非对称量化 (asymmetric quantisation) 使用非零的 \(\text{zero\_point}\),用来处理不对称的分布 (比如 ReLU 输出全是非负数)。把 \([x_{\min}, x_{\max}]\) 映射到 \([0, 255]\),用无符号 INT8 表示。
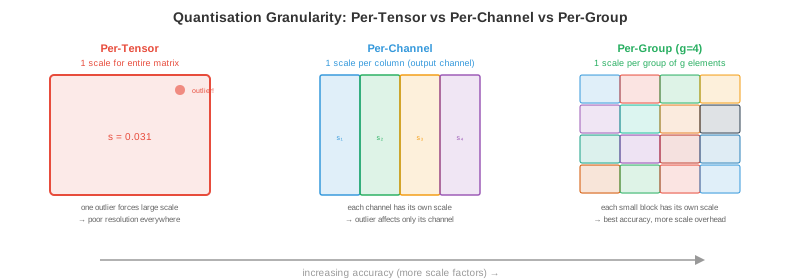
- 量化粒度 (quantisation granularity):多少个值共享同一个缩放因子:
- Per-tensor:整个张量共用一个 scale。最简单但精度最低 (一个离群点就会把整个张量的 scale 拉偏)。
- Per-channel:每个输出通道 (卷积) 或每一行 (线性层) 一个 scale。精度好很多,开销却几乎没增加。
- Per-group:每 \(g\) 个元素一组共用一个 scale (比如 \(g = 128\))。精度最好,现代的仅权重量化 (GPTQ、AWQ) 都用它。
- Per-token:激活按 token 分,每个 token 一个 scale。不同 token 之间激活量级可以差很多,这种粒度处理起来更合适。
训练后量化 (Post-Training Quantisation, PTQ)
- PTQ 把预训练模型直接量化,不做任何再训练。你只需要拿一个校准集 (calibration set,一小份具代表性的数据,通常 128 到 512 个样本) 过一遍模型,收集激活的统计信息,再算出最优的 scale 因子。
校准方法
-
Min-max:用观测到的最小和最大值算 scale。简单,但对离群点很敏感 (一个极端值会把大部分量化区间浪费在稀疏用到的值上)。
-
百分位:用 99.99 百分位代替绝对最大值。剪掉极端离群点,主体值的分辨率更好。被剪掉的值会饱和到 \(q_{\min}\) 或 \(q_{\max}\)。
-
MSE 最优:找出让原始张量和量化后张量之间的均方误差 (Mean Squared Error, MSE) 最小的 scale。这是一维优化 (在可选的截断值上搜索),通常给出 PTQ 里最好的精度。
-
基于熵的方法 (KL 散度):找出让原始值分布与量化后值分布之间 Kullback-Leibler (KL) 散度最小的 scale。TensorRT 的 INT8 校准就用它。
PTQ 实战
# 用 PyTorch 简化实现 PTQ (概念性)
import torch

def quantise_tensor_symmetric(tensor, bits=8):
    qmax = 2 ** (bits - 1) - 1  # INT8 时为 127
    scale = tensor.abs().max() / qmax
    quantised = torch.clamp(torch.round(tensor / scale), -qmax, qmax).to(torch.int8)
    return quantised, scale

def dequantise(quantised, scale):
    return quantised.float() * scale

# 量化一个权重矩阵
weight = torch.randn(512, 512)  # 预训练权重
weight_q, scale = quantise_tensor_symmetric(weight, bits=8)
weight_reconstructed = dequantise(weight_q, scale)

# 量化误差
error = (weight - weight_reconstructed).abs().mean()
print(f"Mean absolute error: {error:.6f}")
print(f"Compression: {weight.numel() * 4 / (weight_q.numel() * 1 + 4):.1f}x")  # scale 多占 4 字节
- 在大多数模型上,PTQ 做到 INT8 时精度损失不到 1%。到 INT4 时,PTQ 质量下降就明显了 —— 下面的仅权重方法在 INT4 上表现要好得多。
量化感知训练 (Quantisation-Aware Training, QAT)
- QAT 在训练图里插入伪量化 (fake quantisation) 算子:前向传播时权重和激活会被量化再反量化,但反向传播时梯度当作没量化过一样流过去 (这就是直通估计器,straight-through estimator)。
-
模型在训练过程中学会对量化噪声保持稳健。QAT 通常能把 PTQ 丢掉的那点精度找回大部分甚至全部,尤其在极低位宽 (INT4、INT2) 下效果显著。
-
成本:QAT 需要重训练或微调,对大模型来说很贵。一个 70B 参数模型,QAT 可能要花 $10,000 到 $100,000 的算力。而 PTQ 几乎零成本 (只是做个校准)。
-
什么时候用 QAT: PTQ 质量不达标时 (通常 INT4 或更低);部署到边缘设备、有严格延迟预算时;或模型会被量化上百万次时 (一次性的 QAT 成本被摊薄了)。
仅权重量化
- 对 LLM 推理而言,瓶颈在从内存加载权重,而不是拿它们计算 (内存带宽受限区间)。仅权重量化 (weight-only quantisation) 把权重量化到 INT4 或 INT3,但激活保持 FP16。计算发生在 FP16 (权重在计算前实时反量化),而内存占用和带宽却减小了 4 到 8 倍。
GPTQ
- GPTQ (Frantar 等,2022) 一次量化一列权重,每量化完一列就用调整后续列的方式补偿这一列的量化误差。它借助 Hessian (来自校准集的二阶信息) 决定最优的量化顺序与误差补偿:
-
核心洞见:量化第 \(j\) 列会引入误差,GPTQ 立刻通过修改后续所有列来补偿,使得整层输出 (\(XW\)) 的变化尽可能小。这就是最优大脑量化 (Optimal Brain Quantisation, OBQ) 在 Transformer 上的应用。
-
GPTQ 配 4 位分组量化 (group size 128) 在大多数 LLM 上困惑度损失不到 1%。在单卡 GPU 上量化一个 70B 模型大约要 1 小时。
AWQ
-
AWQ (激活感知权重量化,Activation-Aware Weight Quantisation, Lin 等,2023) 观察到只有一小部分权重通道 (1% 到 3%) 比其他重要得多 —— 它们对应着幅值特别大的激活通道。保住这些关键通道能大幅降低量化误差。
-
AWQ 在量化前把这些重要通道乘以缩放因子 \(s\) (让它们变大,从而不那么容易被舍入影响),同时把对应的激活乘以 \(1/s\) (保持输出不变)。缩放 \(s\) 按组优化,目标是让整体量化误差最小。
-
AWQ 比 GPTQ 更简单 (不用算 Hessian)、跑得更快,质量却相当。它已经成为很多开源 LLM 量化流水线的默认选择。
GGUF / llama.cpp 量化
-
GGUF (GGML 通用格式,GGML Universal Format) 是 llama.cpp 用于 CPU 推理的格式。它支持很多量化方案:
- Q4_0: 4 位,32 元素一块,对称。
- Q4_K_M: 4 位,对重要通道做混合精度处理 (k-quants)。
- Q5_K_M: 5 位配 k-quants (质量更高)。
- Q8_0: 8 位,简单快速。
-
"K" 变种 (k-quants) 给重要的权重块分配更多位,思想类似 AWQ,但在格式层就实现了。Q4_K_M 是大多数模型的甜点区:平均 4 位,质量损失极小。
QuIP 与 QuIP
-
QuIP (Chee 等,2023) 引入了不相干处理 (incoherence processing):在量化前用一个随机正交变换把权重矩阵旋转一下。这样信息就均匀铺开到所有权重上,不会让少数离群权重主导量化误差。
-
直觉:如果一个权重是 100,其他大约是 1,用同一个 scale 量化全部时,大部分 INT4 区间就浪费在这个离群点上。做完正交旋转后 (保留了矩阵的数学性质),所有权重量级相近,均匀量化就好多了。
-
QuIP# 在此基础上加了格码本 (lattice codebooks):不再映射到均匀整数网格,而是映射到最优晶格上的点 (8 维空间里的 E8 晶格)。晶格码在同样的位数下能塞进更多量化点,率失真表现比均匀量化更好。QuIP# 在 2 位精度下还能拿到可用的质量 —— 只用了典型 INT4 方法一半的位数。
SpQR
-
SpQR (Dettmers 等,2023) 观察到极少量权重 (0.1% 到 1%) 是离群点 (outliers),它们对输出质量的贡献远超其他权重。SpQR 不再一视同仁地量化,而是:
- 通过敏感性分析 (quantise 掉这个权重会让层输出变多少?) 识别出离群权重。
- 用稀疏格式保存离群权重的全精度 (FP16) 值。
- 把剩下的权重激进地量化到 INT3 或 INT4。
-
结果:约 99% 的权重被大幅压缩 (小),而关键的 1% 保留全精度 (准)。稀疏离群点的存储开销很低 (总体积的 <5%)。
HQQ
-
HQQ (半二次量化,Half-Quadratic Quantisation, Badri & Shaji, 2023) 是一种零样本 (zero-shot) 权重量化方法,完全不需要任何校准数据。它把量化建模成一个半二次优化问题,迭代地求解最优量化权重和 scale 因子。
-
优势:不需要校准集,意味着没有数据依赖、可以立即量化,也不用担心校准数据不匹配。当代表性校准数据难以获取或涉及敏感信息时,HQQ 特别有用。
AQLM
- AQLM (Egiazarian 等,2024) 把加性量化 (additive quantisation,多码本向量量化) 用到了 LLM 上。AQLM 不再逐权重独立量化,而是把权重组成向量,用多个学习到的码本中的条目求和来表示每个向量:
- 这里 \(\mathbf{c}_i^{(m)}\) 是第 \(m\) 个码本中的一个条目。用 \(M = 2\) 个码本、每个 256 条时,一个 8 元素向量被编码成两个 8 位索引 = 2 字节表示 8 个权重 = 每权重 2 位。在 2 位精度下,AQLM 达到了当前最好的质量,在这个极端压缩水平上超过了 GPTQ 与 AWQ。
BitNet 与 1 位 LLM
-
BitNet (Wang 等,2023) 把量化推向极致:权重取三值 (\(\{-1, 0, +1\}\)),每权重只需约 1.58 位。矩阵乘法退化为加减法 —— 完全不需要浮点乘法。
-
BitNet b1.58 (Ma 等,2024) 把每个权重都限制在 \(\{-1, 0, +1\}\)。所谓 "1.58 位" 来自 \(\log_2(3) \approx 1.58\)。这种精度下,70B 模型只占 ~15 GB,推理不需要乘法,只要加、减、变符号。
-
矩阵乘法变成:
- 在任何硬件上,这都比 FP16 matmul 便宜得多,甚至可能让没有浮点单元的设备也跑得动 LLM 推理。就当前模型而言,质量代价还不小,但随规模扩大与训练时的量化感知设计会持续改善。
微尺度 (MX) 格式
- 微尺度 (Microscaling, MX) 格式是新的行业标准 (AMD、Arm、Intel、Meta、Microsoft、NVIDIA、Qualcomm 都支持),使用块浮点 (block floating point):一组元素共享一个指数,每个元素有自己的尾数。
| 格式 | 共享指数 | 元素位数 | 每元素总位数 | 等价于 |
|---|---|---|---|---|
| MXFP8 | 每块 8 位 | 8 (E4M3/E5M2) | ~8 | 像 FP8 但范围更好 |
| MXFP6 | 每块 8 位 | 6 | ~6.5 | 介于 FP8 与 INT4 之间 |
| MXFP4 | 每块 8 位 | 4 | ~4.5 | 像 INT4 但有浮点特性 |
| MXINT8 | 每块 8 位 | 8 (整型) | ~8.5 | INT8 加共享 scaling |
- 共享指数把指数的开销摊到整个块上 (通常 16 到 32 个元素)。每个元素保留的尾数位数比单独指数时多,每位表达的精度更好。MX 格式预计会在未来的硬件里取代单独的 FP8 和 INT8。
FP8 训练
-
在 NVIDIA Hopper 和 Blackwell 上,用 FP8 做训练 (不只是推理) 已经可行。配方如下:
-
前向:权重和激活用 E4M3 (精度较高、范围较窄)。Transformer Engine 用延迟缩放 (delayed scaling) 动态算出每张量的 scale 因子 (记录上一个迭代的统计量,用到当前迭代)。
-
反向:梯度用 E5M2 (范围更宽、精度更低)。梯度的取值范围比权重、激活都宽,多一位指数能防溢出。
-
主权重 (master weights):用 FP32 维护,供优化器状态使用 (和 FP16 混合精度训练类似,第 6 章)。FP8 只用于 matmul,不用于权重更新。
-
Loss scaling:与 FP16 混合精度依赖动态 loss scaler 不同,FP8 训练由 Transformer Engine 采用 per-tensor delayed scaling——每个张量维护自己的 amax 历史 (记录若干次前向/反向的最大绝对值),据此选择 scale 因子,使张量的动态范围对齐到 E4M3/E5M2 的可表示区间 (据 NVIDIA Transformer Engine 文档 2023)。不再需要传统的全局 loss scaler。
-
-
对大多数模型规模,FP8 训练能达到与 BF16 训练相当的质量,吞吐提升约 2 倍。它已经是 H100 集群上新一代大规模训练的默认选择。
激活量化
-
激活 (在层之间流动的中间张量) 也可以量化,从而让整个计算走 INT8 (权重和激活都是 INT8,累加走 INT32)。
-
动态量化 (dynamic quantisation):在运行时按实际激活值算 scale。更准确 (每次输入都自适应),但有额外开销 (每层要算 min/max 或百分位)。
-
静态量化 (static quantisation): scale 因子在校准阶段算好,之后固定不动。推理时更快 (不用现算统计量),但如果校准数据不具代表性,精度会掉。
-
Per-token 量化:序列里每个 token 各算一个 scale。这对 LLM 关键,因为不同 token 的激活量级差异很大 (有些 token 的激活能比其他大 100 倍)。
-
激活量化比权重量化难,因为激活是数据依赖的 (随输入变化),而权重是固定的。"离群点" 问题在这里尤其严重:少数激活通道有极端值 (是均值的 100 倍),用和普通通道相同的 scale 量化就会浪费大量精度。
-
SmoothQuant (Xiao 等,2022) 通过数学上把量化难度从激活 (因离群点难量化) 转移到权重 (容易量化) 来处理离群点:把激活乘 \(1/s\),权重乘 \(s\),由 \(s\) 平衡两侧的难度。输出 \(XW = (X \cdot \text{diag}(s^{-1})) \cdot (\text{diag}(s) \cdot W)\) 保持不变。
混合精度量化
-
各层对量化的敏感度并不一样。注意力层通常能容忍 INT4,而嵌入层与最后的分类层需要更高精度。
-
敏感性分析:逐层单独量化,测量精度受影响的程度。敏感层给更多位;不敏感层给更少位。
-
Transformer Engine (第 16 章,NVIDIA Hopper) 在算子级别做动态混合精度:每个 matmul 根据张量统计自行选择 FP8 还是 FP16,在保证质量的同时把吞吐拉满。
KV 缓存量化
- 在 LLM 生成过程中,KV 缓存 (KV cache) 保存所有先前 token 的键 (Key) 与值 (Value) 张量。序列一长,它就成了内存大头:
-
一个 70B 模型:80 层、64 个头、每头 128 维,序列长度 128K,用 FP16: \(2 \times 80 \times 64 \times 128 \times 131072 \times 2 = 330\) GB。这已经超出 GPU 内存。
-
KV 缓存量化把缓存的 K、V 从 FP16 改成 INT8 或 INT4 存储。量化误差会沿着序列累积 (每个新 token 都要对所有缓存的 K/V 做注意力),但用 per-channel 或 per-head 粒度时,质量下降是可接受的。
-
KV 缓存量化带来的好处是乘法性的:它同时让序列更长 (更多上下文)、批处理更大 (更多并发用户)、推理更快 (加载缓存的带宽更少)。对 LLM 服务而言,这是收益最高的优化之一。
编程任务 (在 CoLab 或 notebook 里做)
-
从零实现对称 INT8 量化。量化一个权重矩阵,再反量化回去,测量重建误差随值分布的变化。
import jax.numpy as jnp import jax def quantise_int8(tensor): scale = jnp.max(jnp.abs(tensor)) / 127.0 quantised = jnp.clip(jnp.round(tensor / scale), -127, 127).astype(jnp.int8) return quantised, scale def dequantise(quantised, scale): return quantised.astype(jnp.float32) * scale # 正态分布权重 (典型的训练后权重) key = jax.random.PRNGKey(0) weights = jax.random.normal(key, (1024, 1024)) * 0.02 q, s = quantise_int8(weights) recon = dequantise(q, s) print(f"Original: {weights.nbytes / 1024:.0f} KB") print(f"Quantised: {q.nbytes / 1024:.0f} KB ({weights.nbytes / q.nbytes:.0f}x smaller)") print(f"Mean abs err: {jnp.abs(weights - recon).mean():.6f}") print(f"Max abs err: {jnp.abs(weights - recon).max():.6f}") print(f"Relative err: {jnp.abs(weights - recon).mean() / jnp.abs(weights).mean():.4%}") -
复现离群点问题。构造少数极端通道的激活,展示 per-tensor 量化如何失败、per-channel 量化如何成功。
import jax.numpy as jnp import jax key = jax.random.PRNGKey(42) # 激活: 大多数通道正常, 有 2 个通道是 100 倍的离群点 activations = jax.random.normal(key, (32, 512)) * 0.1 activations = activations.at[:, 0].set(activations[:, 0] * 100) # 离群通道 activations = activations.at[:, 1].set(activations[:, 1] * 50) # 离群通道 # Per-tensor 量化 (整个张量一个 scale) scale_tensor = jnp.max(jnp.abs(activations)) / 127.0 q_tensor = jnp.clip(jnp.round(activations / scale_tensor), -127, 127) recon_tensor = q_tensor * scale_tensor # Per-channel 量化 (每个通道一个 scale) scales_channel = jnp.max(jnp.abs(activations), axis=0) / 127.0 q_channel = jnp.clip(jnp.round(activations / scales_channel), -127, 127) recon_channel = q_channel * scales_channel err_tensor = jnp.abs(activations - recon_tensor).mean() err_channel = jnp.abs(activations - recon_channel).mean() print(f"Per-tensor error: {err_tensor:.6f}") print(f"Per-channel error: {err_channel:.6f}") print(f"Per-channel is {err_tensor / err_channel:.1f}x better") print(f"\nOutlier channels waste {(activations.shape[1] - 2) / activations.shape[1]:.0%} " f"of the quantisation range for {2 / activations.shape[1]:.1%} of channels") -
为不同模型规模与序列长度算 KV 缓存内存。展示为什么长上下文模型必须做 KV 缓存量化。
def kv_cache_gb(n_layers, n_heads, d_head, seq_len, bytes_per_elem):
    return 2 * n_layers * n_heads * d_head * seq_len * bytes_per_elem / 1e9

models = [
    ("Llama-7B",  32, 32, 128),
    ("Llama-70B", 80, 64, 128),
    ("GPT-4 (est)", 120, 96, 128),
]

print(f"{'Model':<15} {'SeqLen':>8} {'FP16 (GB)':>10} {'INT8 (GB)':>10} {'INT4 (GB)':>10}")
print("-" * 60)

for name, layers, heads, d_head in models:
    for seq_len in [4096, 32768, 131072]:
        fp16 = kv_cache_gb(layers, heads, d_head, seq_len, 2)
        int8 = kv_cache_gb(layers, heads, d_head, seq_len, 1)
        int4 = kv_cache_gb(layers, heads, d_head, seq_len, 0.5)
        print(f"{name:<15} {seq_len:>8} {fp16:>9.1f}  {int8:>9.1f}  {int4:>9.1f}")
    print()
作者按: 我第一次真切感受到量化的威力,是在一台单卡 RTX 4090 (24 GB) 上跑 Llama-2 70B。原生 FP16 需要 140 GB,想都别想;换成 GPTQ INT4 加上 CPU offload,竟然就跑起来了,生成速度还有可用的 token/s。那一刻我意识到,量化不是"让模型跑快一点"的锦上添花,而是"让模型能不能跑"的存亡之问。后来在生产环境部署 LLM 时,感受更深:我们花几周做 GPTQ vs AWQ 的对比、调 group size、试各种 KV cache 量化方案,每省下 10 GB 显存都意味着能多塞一个并发用户、或者把上下文从 8K 拉到 32K。真正的量化艺术,是在困惑度、吞吐、延迟三者之间找那个最合适的甜点,而不是盲目追求更低的位宽。我踩过的最大一个坑:早期把激活量化的 outlier 问题想简单了,用 per-tensor 直接上 INT8,结果 MMLU 掉了 5 个点;换成 SmoothQuant + per-token 后只掉 0.3 个点。给读者的忠告——先跑基线,再逐层剖析,别一上来就追求极端压缩。
📌 本节要点
- 量化的价值:降低数值精度换取更小内存、更高吞吐、更低功耗,是大模型部署经济可行的关键。
- 数字格式全景:FP32/BF16/FP16/FP8 (E4M3, E5M2)/INT8/INT4/三值,精度、范围与用途各有取舍。
- 量化方程与粒度:通过 scale 和 zero-point 建立浮点与整数的映射;粒度从 per-tensor 到 per-group、per-token,越细越准。
- PTQ vs QAT: PTQ 靠校准集直接量化,便宜但精度有限;QAT 通过训练学习抗量化噪声,贵但可救回精度。
- 仅权重量化:针对内存带宽受限的 LLM 推理,GPTQ/AWQ/GGUF/QuIP#/SpQR/HQQ/AQLM 把权重压到 INT4 甚至 2 位。
- BitNet 与 MX 格式:三值权重让 matmul 变为加减法;微尺度格式用块浮点在新硬件上取代单独的 FP8/INT8。
- FP8 训练:E4M3 前向、E5M2 反向、FP32 主权重,在 Hopper/Blackwell 上以 ~2× 吞吐拿到 BF16 相当的质量。
- 激活离群点:少数通道能到均值 100 倍,per-token 粒度和 SmoothQuant 把难度从激活转移到权重。
- KV 缓存量化:长上下文场景下 KV 缓存本身就能超 GPU 显存,量化到 INT8/INT4 是最高杠杆的服务侧优化。