几何深度学习
一句话总结:几何深度学习揭示 CNN、Transformer、GNN 其实是同一原理的不同实例——都在利用数据的对称性;本节讲对称群、群作用、不变性、等变性、五大几何域和尺度分离。
🗺️ 本章导览
- 本章覆盖图神经网络:几何深度学习 → 图论 → GNN → 图注意力 → 3D 等变
- 01. 几何深度学习 (本节):对称与不变性、群论视角、五大几何域
- 02. 图论基础:图、邻接、度、路径、连通性
- 03. 图神经网络:消息传递、GCN、GraphSAGE
- 04. 图注意力网络: GAT、Graph Transformer
- 05. 3D 图网络: SE(3) 等变、SchNet、EGNN
几何深度学习是一个统一框架,它揭示了 CNN、Transformer 和 GNN 其实都是同一原理的实例:利用对称性。 本节涵盖对称群、群作用、不变性、等变性、五大几何域,以及尺度分离.
-
一路走来,我们研究了许多架构:用于图像的卷积神经网络 (Convolutional Neural Network, CNN) (第 8 章)、用于语言的 Transformer (第 7 章)、以及用于序贯决策的强化学习策略 (第 6 章). 表面上,这些模型完全不同,是为完全不同的问题量身打造的。 但底下藏着一个更深的模式。
-
几何深度学习告诉我们,上述所有架构其实都是同一个想法的实例:构建尊重数据对称性的网络。 CNN 利用图像的平移对称性。 Transformer 利用序列的置换对称性 (注意力不依赖于绝对位置). 图神经网络 (Graph Neural Network, GNN) 利用图的置换对称性。 一旦看清这点,五花八门的架构动物园就收敛成一个连贯的统一框架。
对称与群
-
一个对象的对称就是保持它不变的变换。 正方形有 8 个对称:4 个旋转 (0°、90°、180°、270°) 加 4 个反射。 圆有无穷多个:绕圆心的任意旋转都算。 关键洞察是:对称告诉你什么不重要,而"知道什么不重要"对学习来说威力惊人。
-
用机器学习的话说:如果任务有某种对称性,模型无论看到输入的哪个"版本",都应给出同样的答案。 猫的检测器无论猫在图像左上角还是右下角都得能工作。 这就是平移对称性。
-
对称在数学上被形式化为群 (group). 一个群 \(G\) 是一组变换,满足四条性质:
- 封闭性:两个变换的复合仍在群里。 旋转 90° 再旋转 90° 得 180°,仍属于该集合。
- 结合律: \((g_1 \circ g_2) \circ g_3 = g_1 \circ (g_2 \circ g_3)\). 复合的括号怎么加都无所谓 (回忆第 2 章矩阵乘法的结合律).
- 单位元:存在一个"啥也不干"的变换 \(e\),使得 \(e \circ g = g \circ e = g\).
- 逆元:每个变换都有一个撤销操作:\(g \circ g^{-1} = e\).
-
这些公理和向量空间 (第 1 章) 的公理如出一辙,只不过操作对象从向量换成了变换。 这个联系非常深:群作用在向量空间上,而神经网络必须尊重这种作用。
-
深度学习里常见的几个群:
- 平移群 \((\mathbb{R}^n, +)\):对图像或信号的平移。 这是 CNN 利用的对称性。
- 对称群 (symmetric group) \(S_n\): \(n\) 个元素的所有排列。 这是 GNN 和 Transformer 利用的对称性 (重排节点或 Token 不应改变结果).
- 旋转群 \(SO(n)\): \(n\) 维空间的全部旋转。 \(SO(2)\) 是平面旋转,\(SO(3)\) 是 3D 旋转 (对分子和 3D 视觉任务至关重要).
- 欧几里得群 \(E(n)\):全部旋转、反射与平移。 物理空间的对称性。
- 特殊欧几里得群 \(SE(n)\):旋转与平移 (无反射). 刚体运动的对称性。
-
群作用 (group action) 描述群如何变换数据。 若 \(G\) 是一个群,\(X\) 是数据空间,则作用 \(\rho: G \times X \to X\) 把每个群元素 \(g\) 和数据点 \(x\) 映到变换后的点 \(\rho(g, x)\). 对图像来说,平移群通过挪动像素坐标来作用。 对图来说,对称群通过给节点重新贴标签来作用。
不变性与等变性
-
给定一个对称群,函数可以以两种重要方式与之相关:
-
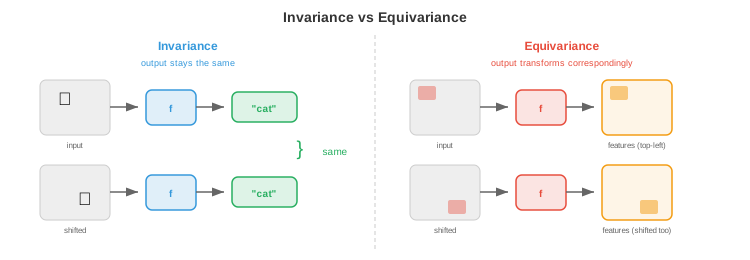
函数 \(f\) 对群 \(G\) 不变 (invariant),是指输入被变换后输出不变:
-
例:平移一张图,它的总亮度不会变。 图像分类应该是平移不变的:不管猫坐在哪,类别都是"猫".
-
函数 \(f\) 对 \(G\) 等变 (equivariant),是指输入变换会引起输出以对应方式变换:
- 例:把图像向右平移 5 像素,CNN 的特征图也随之向右平移 5 像素。 卷积操作是平移等变的:它保留了空间关系。 目标检测应当是等变的:猫一动,边界框也得跟着动。
-
这个区分很重要:中间层通常应当等变 (为下游层保留结构),而最终输出应当不变 (答案不该依赖于变换). CNN 的做法是堆叠等变的卷积层,最后套一个全局池化 (它是不变的).
-
把等变性内建进架构,比从数据里学出来高效得多。 一个带权重共享的平移等变 CNN,所需参数远少于必须独立学习"猫在 (10,10)"和"猫在 (200,150)"两种情形的全连接网络。 对称约束把假设空间指数级地缩小。
五大几何域
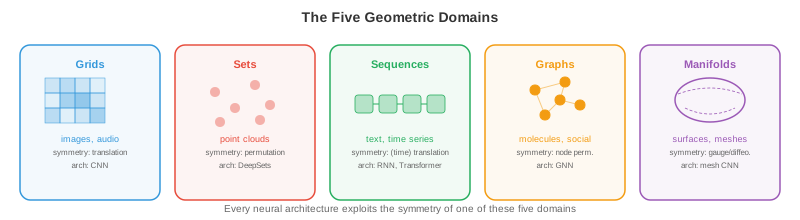
- 几何深度学习识别出五种基本的数据域,每一种都有自己的对称群。 每一个神经网络架构,都可以理解为在利用其中某个域的对称性。
-
1. 网格 (欧几里得数据):图像、音频频谱图、体数据。 底层结构是一个规则网格,具有平移对称性。 群是平移群 (可能再加旋转与反射). 利用此对称性的架构就是 CNN:卷积正是那个对平移等变的操作。 空间位置间的权重共享,就是把平移等变具体化。
-
2. 集合 (无序集合):点云、粒子系统。 对称性是置换不变:元素顺序无关。 架构是 DeepSets (以及第 8 章的 PointNet):对每个元素应用一个共享函数,再用一个置换不变的操作 (求和、求均值或求最大) 聚合。 形式上,\(f(\{x_1, \ldots, x_n\}) = \phi\left(\sum_i \psi(x_i)\right)\).
-
3. 序列 (有序数据):文本、时间序列。 序列是 1D 的网格,但对称性更微妙:绝对位置可能重要也可能不重要。 循环神经网络 (Recurrent Neural Network, RNN) 自回归地处理序列。 带位置编码的 Transformer 可以关注任意位置,而它的自注意力在加入位置编码前是置换等变的。 这正是 Transformer 泛化能力强的原因:它一开始就是置换等变的,再补上刚好够用的位置结构。
-
4. 图 (关系型数据):社交网络、分子、知识图谱。 对称性是节点的置换:给节点重新贴标签不该改变图的性质。 架构就是 GNN:相连节点之间做消息传递,使用与节点顺序无关的共享函数。 这也是本章后续内容的重点。
-
5. 流形与网格 (mesh):曲面、3D 形状。 对称性包括微分同胚 (光滑形变). 架构使用内在算子 (如 Laplace-Beltrami 算子),这些算子由曲面几何本身定义,与曲面如何嵌入到空间中无关。 这与微分几何相通,在形状分析、球面上的气候建模、以及蛋白质表面分析中都用得上。
-
这个框架的威力在于统一. CNN 就是网格图上的 GNN. Transformer 就是全连接图上的 GNN. DeepSets 就是没有边的 GNN. 把它们视为同一原理的实例,就能指导新架构的设计:找出数据的对称性,再构建一个尊重它的网络。
尺度分离与粗化
-
现实世界的数据在多个尺度上都有结构。 一张图像有细粒度纹理 (像素级)、局部模式 (边缘、角点)、物体部件 (轮子、窗户),以及全局结构 (整个场景). 一个分子有原子级特征、官能团、以及整体分子形状。
-
尺度分离 (scale separation) 就是这样一个原则:这些不同层次的细节可以被分层处理——先捕捉局部结构,再逐级聚合成越来越粗的表示。 这就是粗化 (coarsening) 或池化 (pooling).
-
在 CNN 里,池化层 (最大池化、平均池化) 对空间分辨率做下采样,迫使更高层去捕捉更大尺度的模式。 从感受野的视角看 (第 8 章),更深的层"看到"的图像范围更大。 这就是尺度分离在起作用。
-
在图上,粗化意味着把一组节点聚成一个"超节点",得到一个更小但保留了核心结构的图。 这就是图池化,我们会在第 3 节详细讲。 它与图像池化的类比很直接:降低分辨率,同时保留重要特征。
-
在序列里,分层处理 (例如 句子 → 段落 → 文档) 捕捉不同时间或语义尺度上的结构。 Swin Transformer (第 8 章) 把这个思路搬到了图像上,用的是移位窗口的层级结构。
-
数学上,粗化定义出一个逐渐抽象的表示层级:
-
在每一级上,表示都对该级的对称群等变。 最终的全局表示是不变的,它抓住了输入的本质,而不再对无关变换敏感。
-
这也是为什么深网络在处理结构化数据时比浅网络更好用:每一层都增加一级抽象,而许多等变层的复合,从简单的局部特征逐步搭建出复杂的不变特征。
编程练习 (在 CoLab 或 notebook 中做)
-
验证卷积的平移等变性。 对一张图像做卷积,再把图像平移后重新卷积。 检查两次的输出是否互为平移版本。
import jax import jax.numpy as jnp # 1D 信号和一个简单滤波器 signal = jnp.array([0, 0, 0, 1, 2, 3, 2, 1, 0, 0, 0], dtype=float) kernel = jnp.array([1, 0, -1], dtype=float) # 先卷积, 再平移 conv_result = jnp.convolve(signal, kernel, mode="same") shifted_signal = jnp.roll(signal, 3) conv_shifted = jnp.convolve(shifted_signal, kernel, mode="same") shifted_conv = jnp.roll(conv_result, 3) print(f"Conv then shift: {shifted_conv}") print(f"Shift then conv: {conv_shifted}") print(f"Equivariant: {jnp.allclose(shifted_conv, conv_shifted, atol=1e-5)}") -
验证 DeepSets 风格聚合的置换不变性。 对集合中每个元素施加一个共享函数,把结果求和,检查输出是否与元素顺序无关。
import jax import jax.numpy as jnp # 一个由 4 个向量组成的"集合" (顺序不该影响结果) x = jnp.array([[1.0, 2.0], [3.0, 4.0], [5.0, 6.0], [7.0, 8.0]]) # 简单的共享函数: 逐元素平方 psi = lambda v: v ** 2 # 用求和做聚合 def deepsets(points): return jnp.sum(jax.vmap(psi)(points), axis=0) # 原始顺序 result1 = deepsets(x) # 打乱顺序 perm = jnp.array([2, 0, 3, 1]) result2 = deepsets(x[perm]) print(f"Original order: {result1}") print(f"Permuted order: {result2}") print(f"Invariant: {jnp.allclose(result1, result2)}") -
探索群结构。 通过验证封闭性、结合律、单位元、逆元,确认 2D 旋转矩阵构成一个群。
import jax.numpy as jnp

def rot2d(theta):
    return jnp.array([[jnp.cos(theta), -jnp.sin(theta)],
                       [jnp.sin(theta),  jnp.cos(theta)]])

R1 = rot2d(jnp.pi / 6)
R2 = rot2d(jnp.pi / 4)
R3 = rot2d(jnp.pi / 3)

# 封闭性: 两个旋转的乘积仍是一个旋转
R12 = R1 @ R2
print(f"Closure (det=1, orthogonal): det={jnp.linalg.det(R12):.4f}, "
      f"R^T R = I: {jnp.allclose(R12.T @ R12, jnp.eye(2), atol=1e-5)}")

# 结合律
print(f"Associative: {jnp.allclose((R1 @ R2) @ R3, R1 @ (R2 @ R3), atol=1e-5)}")

# 单位元
I = rot2d(0.0)
print(f"Identity: {jnp.allclose(R1 @ I, R1, atol=1e-5)}")

# 逆元
R1_inv = rot2d(-jnp.pi / 6)
print(f"Inverse: {jnp.allclose(R1 @ R1_inv, jnp.eye(2), atol=1e-5)}")
📌 本节要点
- 对称性:对象在某种变换下保持不变的性质,告诉模型"什么不重要",是学习效率的关键杠杆。
- 群的四条公理:封闭性、结合律、单位元、逆元——刻画一切"变换集合"的最小结构。
- 深度学习常见群:平移群、对称群 \(S_n\)、旋转群 \(SO(n)\)、欧几里得群 \(E(n)\)、特殊欧几里得群 \(SE(n)\).
- 不变性 vs 等变性:不变 = 变换输入输出不变;等变 = 变换输入输出跟着一起变。
- 架构设计原则:中间层等变以保留结构,最终输出不变以稳定答案。
- 五大几何域:网格 (CNN)、集合 (DeepSets)、序列 (RNN / Transformer)、图 (GNN)、流形 (内在算子).
- 架构统一视角: CNN 是网格图上的 GNN, Transformer 是全连接图上的 GNN, DeepSets 是无边图上的 GNN.
- 尺度分离:通过粗化 / 池化把数据分层抽象——从局部特征到全局表示。
- 粗化层级: \(x \to h^{(1)} \to h^{(2)} \to \cdots \to y\),每级对该级的对称群等变,最终全局表示不变。
- 深比浅好的深层原因:多层等变复合能把简单的局部特征逐步构造出复杂的不变特征。