离散数学
一句话总结:离散数学是关于可数、分离结构的数学,覆盖逻辑、集合、函数、图论、递推、可计算性与复杂性,是整个计算学科的根基。
🗺️ 本章导览
- 本章覆盖计算与操作系统:离散数学 → 计算机架构 → 操作系统 → 并发与并行 → 编程语言
- 01. 离散数学 (本节):命题与谓词逻辑、证明、集合、关系、函数、图论、递推、可计算性、复杂性
- 02. 计算机架构:冯诺依曼、CPU 流水线、缓存
- 03. 操作系统:进程、内存管理、文件系统
- 04. 并发与并行:线程、锁、无锁数据结构
- 05. 编程语言:类型系统、内存模型、抽象层次
离散数学是研究可数、分离结构的数学,也是计算所依赖的基础。 本节涵盖命题逻辑与谓词逻辑、证明技巧、集合、关系、函数、图论基础以及递推关系.
-
前面几章里,我们打交道的都是连续数学:微积分 (第 3 章)、概率分布 (第 5 章),以及在实数参数上做优化 (第 6 章). 但计算机在本质上是离散机器。 它们存储比特 (0 或 1)、处理整数、按分支逻辑执行,并在有限数据结构上运算。 离散数学给了我们一套形式化语言,用来讨论这些结构。
-
本章的每一块内容都建立在离散数学之上:处理器逻辑门就是布尔代数,调度算法需要正确性证明,内存管理用到集合运算,算法分析离不开递推关系。
命题逻辑
-
命题逻辑 (propositional logic) 是关于真/假陈述的代数。 命题 (proposition) 是要么为真 (T)、要么为假 (F) 的陈述,不能既真又假。 "正在下雨"是命题。 "现在几点了?"不是 (它是问题,没有真值).
-
命题可以用逻辑联结词 (logical connectives) 组合起来:
- 与 (合取,conjunction, \(p \wedge q\)):只有当 \(p\) 和 \(q\) 都为真时才为真。
- 或 (析取,disjunction, \(p \vee q\)):只要 \(p\) 或 \(q\) 至少有一个为真就为真。
- 非 (否定,negation, \(\neg p\)):翻转真值。
- 蕴涵 (implication, \(p \to q\)):只有当 \(p\) 为真且 \(q\) 为假时才为假。 "如果下雨,地就湿了"这句话,只有在"下雨了但地是干的"时才被推翻。
- 当且仅当 (双条件,biconditional, \(p \leftrightarrow q\)):两者真值相同时为真。
-
真值表 (truth table) 穷举所有输入组合以及对应输出。 对 \(n\) 个命题,表有 \(2^n\) 行。 这是我们验证逻辑等价的方式:
| \(p\) | \(q\) | \(p \wedge q\) | \(p \vee q\) | \(p \to q\) |
|---|---|---|---|---|
| T | T | T | T | T |
| T | F | F | T | F |
| F | T | F | T | T |
| F | F | F | F | T |
-
蕴涵表中 \(p\) 为假的那两行值得注意:\(F \to q\) 永远为真,不管 \(q\) 是什么。 这叫空真 (vacuous truth). "如果猪会飞,那我就是英国国王"在逻辑上是真的,因为前提假。 看上去反直觉,但对数学推理不可或缺。
-
逻辑等价 (logical equivalences) 是对所有真值都成立的恒等式:
-
德摩根律 (De Morgan's laws): \(\neg(p \wedge q) \equiv \neg p \vee \neg q\) 和 \(\neg(p \vee q) \equiv \neg p \wedge \neg q\). 否定一个"与",就分别否定两部分并换成"或" (反过来也一样). 这些规则在编程里直接可见:
!(a && b)等价于(!a || !b). -
逆否 (contrapositive): \(p \to q \equiv \neg q \to \neg p\). "如果下雨,地就湿了"等价于"如果地不湿,就没下雨". 这是很强大的证明技巧。
-
双重否定 (double negation): \(\neg(\neg p) \equiv p\).
-
分配律 (distributive): \(p \wedge (q \vee r) \equiv (p \wedge q) \vee (p \wedge r)\).
-
-
对所有真值指派都为真的公式叫永真式 (tautology). 始终为假的叫矛盾式 (contradiction). 有时真有时假的叫可满足式 (contingent). 例如 \(p \vee \neg p\) 是永真式,\(p \wedge \neg p\) 是矛盾式。
谓词逻辑与量词
-
命题逻辑没法表达关于集合中所有或某些元素的陈述。 "每个大于 2 的素数都是奇数"就需要谓词逻辑 (predicate logic),它在命题逻辑上加入变量、谓词和量词。
-
谓词 (predicate) 是依赖于变量的陈述:\(P(x)\) = "\(x\) 是偶数". 当 \(x\) 取具体值时,它就变成命题:\(P(4)\) 为真,\(P(7)\) 为假。
-
量词 (quantifiers) 表达作用范围:
- 全称量词 (universal quantifier) (\(\forall\)): "对所有". \(\forall x \, P(x)\) 意思是"对论域中每一个 \(x\), \(P(x)\) 都为真".
- 存在量词 (existential quantifier) (\(\exists\)): "存在". \(\exists x \, P(x)\) 意思是"至少存在一个 \(x\),使 \(P(x)\) 为真".
-
否定量词会翻转它们:\(\neg(\forall x \, P(x)) \equiv \exists x \, \neg P(x)\). "不是所有人都通过"意味着"有人没通过". 以及 \(\neg(\exists x \, P(x)) \equiv \forall x \, \neg P(x)\). "没有完美的算法"意味着"每个算法都有缺陷".
-
嵌套量词表达复杂关系。 \(\forall x \, \exists y \, (y > x)\) 意思是"对每个数,都存在一个更大的数" (对整数为真). 顺序很重要:\(\exists y \, \forall x \, (y > x)\) 意思是"存在一个数比所有其他数都大" (对整数为假).
-
谓词逻辑是形式化规约的语言。 当我们说算法"正确"时,意思是 \(\forall \text{inputs} \, x, \, \text{output}(x) = \text{desired}(x)\). 当我们说它"会终止"时,意思是 \(\forall x \, \exists t \, \text{halts}(x, t)\).
证明技巧
-
证明 (proof) 是逻辑论证,用来无可争议地确立一个陈述的真值。 与经验证据 (只显示某事在测过的例子上成立) 不同,证明保证它对所有情形都成立。 这是计算机科学里的正确性标准。
-
直接证明 (direct proof):假设前提,通过逻辑推导出结论。 要证"如果 \(n\) 是偶数,则 \(n^2\) 是偶数":假设 \(n = 2k\) (某个整数 \(k\)),那么 \(n^2 = 4k^2 = 2(2k^2)\),是偶数。
-
反证法 (proof by contradiction):假设陈述为假,推出矛盾。 要证 \(\sqrt{2}\) 是无理数:假设 \(\sqrt{2} = a/b\) (已完全约分). 那么 \(2 = a^2/b^2\),所以 \(a^2 = 2b^2\),意味着 \(a^2\) 是偶数,因此 \(a\) 是偶数,记 \(a = 2c\). 那么 \(4c^2 = 2b^2\),于是 \(b^2 = 2c^2\),说明 \(b\) 也是偶数。 但我们说过 \(a/b\) 已经完全约分了 —— 矛盾。
-
归纳证明 (proof by induction):通过以下两步证明关于所有自然数的陈述:(1) 基础情况 (base case) 成立 (通常是 \(n = 0\) 或 \(n = 1\)), (2) 归纳步骤 (inductive step):若陈述对 \(n = k\) 成立 (归纳假设),则对 \(n = k + 1\) 也成立。
-
例如,证 \(\sum_{i=1}^{n} i = \frac{n(n+1)}{2}\):
- 基础情况:\(n = 1\): \(1 = \frac{1 \cdot 2}{2} = 1\). 成立。
- 归纳步骤:假设 \(\sum_{i=1}^{k} i = \frac{k(k+1)}{2}\). 那么 \(\sum_{i=1}^{k+1} i = \frac{k(k+1)}{2} + (k+1) = \frac{k(k+1) + 2(k+1)}{2} = \frac{(k+1)(k+2)}{2}\). 这正是 \(n = k+1\) 时的公式。 完成。
-
归纳法是证明递归算法和递归数据结构性质的主力工具。 每个递归算法都隐含一个归纳法正确性证明:基础情况就是终止条件,归纳步骤就是递归调用。
-
强归纳 (strong induction) 假设陈述对所有直到 \(k\) 的值都成立 (不只是 \(k\)),然后证明它对 \(k + 1\) 成立。 当递归依赖不止于前一个值时特别有用。
-
鸽笼原理 (pigeonhole principle):若把 \(n+1\) 个物体放进 \(n\) 个盒子,则至少有一个盒子装了两个物体。 简单但意外地强大。 它证明了任意 13 个人里必有至少两个人生日在同一月份。 在网络中,它证明了当条目多于桶时哈希冲突不可避免。
集合
-
集合 (set) 是由互异元素组成的无序集合。 集合是数学里最原始的数据结构,它撑起了从类型系统到数据库查询的一切。
-
集合运算 (与第 5 章我们在概率中用到的相接):
- 并 (union) \(A \cup B\):属于 \(A\) 或 \(B\) 或两者的元素。
- 交 (intersection) \(A \cap B\):同时属于 \(A\) 和 \(B\) 的元素。
- 补 (complement) \(\bar{A}\):不在 \(A\) 中的元素 (相对于全集).
- 差 (difference) \(A \setminus B\):属于 \(A\) 但不属于 \(B\) 的元素。
- 笛卡尔积 (Cartesian product) \(A \times B\):所有有序对 \((a, b)\),其中 \(a \in A, b \in B\).
-
幂集 (power set) \(\mathcal{P}(A)\) 是 \(A\) 所有子集组成的集合。 若 \(|A| = n\),则 \(|\mathcal{P}(A)| = 2^n\). 对 \(A = \{1, 2\}\): \(\mathcal{P}(A) = \{\emptyset, \{1\}, \{2\}, \{1, 2\}\}\).
-
基数 (cardinality) 衡量集合大小。 有限集的基数是整数。 无穷集有不同的"大小":自然数 \(\mathbb{N}\) 和有理数 \(\mathbb{Q}\) 是可数无穷 (countably infinite) (能被列举),而实数 \(\mathbb{R}\) 是不可数无穷 (uncountably infinite) (无法被列举,由康托尔对角线论证证明). 这一区分在可计算性理论中很关键:函数不可数多,但程序只可数多,所以大多数函数是不可计算的。
关系
-
\(A\) 上的关系 (relation) \(R\) 是 \(A \times A\) 的一个子集:一组有序对,指定了哪些元素之间有关系。 例如,整数上的 \(\leq\) 就是集合 \(\{(a, b) : a \leq b\}\).
-
关系的重要性质:
- 自反 (reflexive):每个元素与自身有关系。 对所有 \(a\), \(a R a\). 例:\(\leq\) (每个数都 \(\leq\) 自己).
- 对称 (symmetric):若 \(a R b\) 则 \(b R a\). 例:"是……的兄弟姐妹".
- 反对称 (antisymmetric):若 \(a R b\) 且 \(b R a\) 则 \(a = b\). 例:\(\leq\).
- 传递 (transitive):若 \(a R b\) 且 \(b R c\) 则 \(a R c\). 例:\(<\), \(\leq\), "是……的祖先".
-
等价关系 (equivalence relation) 同时是自反的、对称的和传递的。 它把集合划分成等价类 (equivalence classes),类内所有元素之间有关系,与其他类的元素则没有。 模运算就是等价关系:\(a \equiv b \pmod{n}\) 把整数划分成 \(n\) 个类。 编程语言里的类型等价也是等价关系。
-
偏序 (partial order) 是自反、反对称、传递的关系。 它定义了一种"小于或等于"结构,但可能有一些元素互不可比。 文件系统目录构成偏序 (父子关系),但兄弟目录之间不可比。 全序 (total order) 是每一对都可比的偏序 (像整数上的 \(\leq\)).
-
偏序在并发中至关重要:事件之间的"发生在……之前 (happens-before)"关系就是一个偏序。 未被 happens-before 排序的事件是并发的,可以以任意相对顺序执行。
函数
-
函数 (function) \(f: A \to B\) 把 \(A\) (定义域) 的每个元素映射到 \(B\) (陪域) 的恰好一个元素。 函数是确定性计算的数学模型:给定输入,输出恰好只有一个。
-
单射 (injective,一对一):不同输入总给出不同输出。 \(f(a) = f(b) \implies a = b\). 无损压缩是单射:不同输入必须压缩到不同输出 (否则你没法唯一解压).
-
满射 (surjective,到上): \(B\) 的每个元素都被 \(A\) 中某个元素命中。 值域等于陪域。 把字符串映射到 256 位哈希的函数,如果字符串数量少于可能的哈希,就不是满射。
-
双射 (bijective):既是单射也是满射。 \(A\) 与 \(B\) 之间完美的一对一对应。 双射有逆。 加密必须是双射:每个明文映射到唯一的密文,解密函数就是它的逆。
-
复合 (composition) \((g \circ f)(x) = g(f(x))\):先应用 \(f\),再应用 \(g\). 函数复合满足结合律 (第 2 章:与矩阵乘法结合律同源). 软件里的流水线就是函数复合:数据流过一连串变换。
图论基础
-
我们在第 12 章 (图神经网络) 已经详细讨论了图,包括邻接矩阵、图的类型、拉普拉斯以及谱理论。 这里我们聚焦与计算机科学相关的算法和结构性质。
-
树 (tree) 是连通且无环的图。 等价地,它有 \(n\) 个节点和 \(n-1\) 条边。 树是文件系统、XML/HTML 文档、决策过程和递归分解的结构。 有根树 (rooted tree) 指定了一个根节点;其他每个节点都恰好有一个父节点。
-
图 \(G\) 的生成树 (spanning tree) 是一棵树,它使用 \(G\) 边的子集包含 \(G\) 的所有节点。 最小生成树 (Minimum Spanning Tree, MST) 使总边权最小。 克鲁斯卡尔算法 (Kruskal's algorithm,边排序后贪心地加入不形成环的最轻边) 和普里姆算法 (Prim's algorithm,从起点开始扩展,每次加入通往新节点的最轻边) 都能在 \(O(|E| \log |V|)\) 时间内找到 MST.
-
平面性 (planarity):若图能画在平面上且没有边相交,则称为平面图。 由欧拉公式 (Euler's formula),对连通平面图:\(|V| - |E| + |F| = 2\),其中 \(|F|\) 是面数 (含外部面). 由此可推出平面图有 \(|E| \leq 3|V| - 6\),所以平面图是稀疏的。 电路板走线与地图着色利用了平面性。
-
图着色 (graph colouring) 给节点上色,使相邻两节点颜色不同。 所需最少颜色数是色数 (chromatic number) \(\chi(G)\). 四色定理 (four-colour theorem) 说,对任意平面图 \(\chi(G) \leq 4\). 在计算机科学中,图着色可建模寄存器分配 (给变量分配 CPU 寄存器,使同时活跃的变量得到不同寄存器) 和调度 (把任务分到时间片,使冲突任务不重叠).
-
欧拉路径 (Euler paths) 恰好访问每条边一次。 当且仅当图恰好有 0 个或 2 个奇度节点时它才存在。 哈密顿路径 (Hamiltonian paths) 恰好访问每个节点一次。 判断哈密顿路径是否存在是 NP 完全问题 —— 计算机科学里的经典难题之一。 这个对比 (欧拉:多项式,哈密顿:NP 完全) 说明:听起来相似的问题,计算复杂度可以天差地别。
递推关系
-
递推关系 (recurrence relation) 定义一个序列,每一项都依赖前几项。 它们自然地从递归算法中冒出来。
-
最简单的例子:\(T(n) = T(n-1) + 1\), \(T(0) = 0\). 展开:\(T(n) = T(n-1) + 1 = T(n-2) + 2 = \cdots = n\). 这是 \(O(n)\),即简单循环的时间复杂度。
-
归并排序 (merge sort) 给出 \(T(n) = 2T(n/2) + O(n)\):把数组分成两半 (两个规模为 \(n/2\) 的子问题),递归排序每一半,然后合并 (\(O(n)\) 工作量). 解为 \(T(n) = O(n \log n)\).
-
主定理 (Master Theorem) 求解形如 \(T(n) = aT(n/b) + O(n^d)\) 的递推:
- 若 \(d > \log_b a\): \(T(n) = O(n^d)\) (每层的工作量主导)
- 若 \(d = \log_b a\): \(T(n) = O(n^d \log n)\) (各层工作量均衡)
- 若 \(d < \log_b a\): \(T(n) = O(n^{\log_b a})\) (子问题数量主导)
-
对归并排序:\(a = 2, b = 2, d = 1\). 因为 \(d = \log_2 2 = 1\),落在均衡情形:\(T(n) = O(n \log n)\).
-
斐波那契递推 (Fibonacci recurrence) \(F(n) = F(n-1) + F(n-2)\), \(F(0) = 0, F(1) = 1\) 有闭式解 \(F(n) = \frac{\phi^n - \psi^n}{\sqrt{5}}\),其中 \(\phi = \frac{1+\sqrt{5}}{2}\) (黄金比例), \(\psi = \frac{1-\sqrt{5}}{2}\). 这说明斐波那契序列以 \(O(\phi^n)\) 指数增长,也是为什么朴素递归的斐波那契慢到指数级别。
-
组合数学 (combinatorics) (排列、组合、二项式定理和容斥原理) 在第 5 章 (概率) 中已讲。 这些计数技术是算法分析的必备工具 (有多少可能输入?多少次比较?),但这里不再重复。
可计算性
-
并非所有东西都能被计算。 这是整个数学中最深刻的结果之一,它划定了计算机能做什么的根本边界。
-
图灵机 (Turing machine) 是计算的抽象模型:一条无穷长的格子带 (每格存一个符号),一个读/写头,以及一组有限状态和转移规则。 尽管极其简单,图灵机能计算任何真实计算机能计算的东西。 这就是丘奇-图灵论题 (Church-Turing thesis):任何可有效计算的函数都能被图灵机计算。
-
每一种编程语言 (Python, C, Haskell) 都是图灵完备 (Turing complete) 的:它能模拟一台图灵机,因而能计算任何可计算的东西。 语言之间的差别在于方便、速度和安全性,而不在于它们本质上能计算什么。
-
停机问题 (halting problem) 问:给定一个程序和一个输入,程序最终会停下,还是会永远运行下去?图灵 (1936) 证明了没有算法能在一般情形下解决它。 证明用反证:假设停机检测器 \(H(P, x)\) 存在。 构造一个程序 \(D\),它跑 \(H(D, D)\) 并做与 \(H\) 说的相反的事。 如果 \(H\) 说 \(D\) 停机,\(D\) 就无限循环。 如果 \(H\) 说 \(D\) 死循环,\(D\) 就停机。 矛盾。
-
这不是当前技术的局限;它是数学上的不可能。 再多算力、再聪明、再强的 AI 都无法一般性地解决停机问题。 它是计算机科学里的哥德尔不完备性定理。
-
实际后果:你无法写出完美的死锁检测器、完美的病毒扫描器或完美的优化编译器。 每一个都需要一般性地解决停机问题 (或与之等价的不可判定问题). 真实工具只能用启发式和近似,在常见情形下有效,但不能保证对所有输入正确。
-
若存在一个总能以正确的是/否答案终止的算法,则称问题可判定 (decidable). 否则称不可判定 (undecidable). 停机问题不可判定。 素性测试可判定。 大多数编程语言中的类型检查也是可判定的 (设计使然).
复杂性理论
- 即便在可计算的问题里,有些也远比另一些难。 复杂性理论 (complexity theory) 按输入增长时所需的资源 (时间、空间) 对问题分类。
-
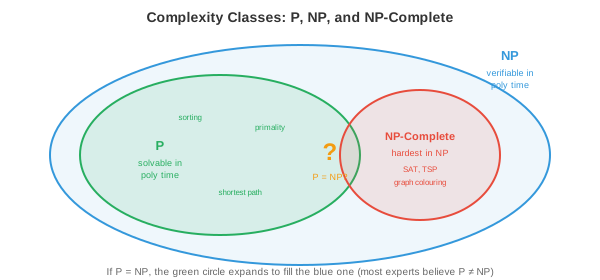
P (多项式时间,Polynomial time):可在 \(O(n^k)\) 时间内求解的问题 (某常数 \(k\)). 排序 (\(O(n \log n)\))、最短路径 (\(O(|V|^2)\))、矩阵乘法 (\(O(n^3)\)). 这些被视为"高效"或"可处理".
-
NP (非确定性多项式时间,Nondeterministic Polynomial time):一个候选解能在多项式时间内被验证的问题,即便找到解可能需要指数时间。 例如,给定一条声称的哈密顿路径,你可以在 \(O(n)\) 内检查每条边。 但找到一条可能要试指数级多种可能。
-
P 中的每个问题都在 NP 中 (若能快速求解,当然也能快速验证). 核心问题是 \(P = NP\) 是否成立:每一个解能被快速验证的问题,是否也都能被快速求解?这是计算机科学最重要的开放问题,有 100 万美元的克雷千禧年大奖。
-
大多数专家相信 \(P \neq NP\),也就是有些问题从根本上就更难解、易验。 若 \(P = NP\),密码学会崩溃 (破解加密属于 NP),优化、调度和药物设计会变得轻而易举。
-
NP 完全 (NP-complete) 问题是 NP 中最难的一批。 一个问题 NP 完全,当且仅当:(1) 它在 NP 中,(2) 每一个其他 NP 问题都可以在多项式时间内归约 (reduce) 到它。 只要能高效解决任一 NP 完全问题,就能解决所有 NP 完全问题 (且 \(P = NP\)).
-
归约 (reduction) 把一个问题变换到另一个问题。 若问题 A 可以归约到问题 B,那么 B 至少和 A 一样难。 库克 (Cook, 1971) 证明了 SAT (布尔可满足性,Boolean satisfiability):给定一个逻辑公式,是否存在使它为真的变量赋值?—— 是 NP 完全的。 卡普 (Karp, 1972) 通过把 SAT 归约到 21 个经典问题,证明了它们也都是 NP 完全的。
-
著名的 NP 完全问题:
- 旅行商问题 (Travelling Salesman Problem, TSP):找访问所有城市各一次的最短路线。
- 图着色:用 \(k\) 种颜色给节点上色,使相邻节点颜色不同 (\(k \geq 3\)).
- 子集和 (Subset sum):给定一组整数,是否存在和为目标值的子集?
- 布尔可满足性 (SAT):是否存在使公式为真的真值指派?
- 哈密顿路径 (上文图论中提过).
-
实际遇到 NP 完全问题时,你不会在大规模输入上精确求解。 相反,你用:近似算法 (approximation algorithms) (在保证的最优比因子内给出解)、启发式 (heuristics) (贪心、局部搜索、模拟退火),或特殊情形求解器 (special-case solvers) (许多 NP 完全问题在受限输入上很容易). 例如现代 SAT 求解器,尽管最坏情况指数复杂,却能常规地解含数百万变量的实例 —— 靠的就是利用实际实例中的结构。
-
NP 难 (NP-hard) 问题至少和 NP 完全一样难,但可能不属于 NP (它们的解甚至可能无法在多项式时间内验证). NP 完全问题的优化版本通常是 NP 难:"找最短 TSP 巡回"是 NP 难,而"是否存在长度短于 \(k\) 的 TSP 巡回"是 NP 完全。
编程任务 (使用 CoLab 或 notebook)
-
构建一个真值表生成器。 给定一个逻辑表达式,枚举所有输入组合并计算输出。
import itertools def truth_table(n_vars, expr_fn): """为 n_vars 个变量的布尔函数生成真值表.""" headers = [f"p{i}" for i in range(n_vars)] print(" | ".join(headers + ["result"])) print("-" * (len(headers) * 4 + 10)) for vals in itertools.product([False, True], repeat=n_vars): result = expr_fn(*vals) row = [str(v)[0] for v in vals] + [str(result)[0]] print(" | ".join(f"{r:>2}" for r in row)) # 德摩根律: NOT(p AND q) == (NOT p) OR (NOT q) print("De Morgan's Law verification:") truth_table(2, lambda p, q: (not (p and q)) == ((not p) or (not q))) -
用归纳法证明求和公式 —— 先在多个值上数值验证,再实现闭式解。
-
用主定理求解归并排序递推,并通过统计操作数进行经验验证。
import jax.numpy as jnp

def merge_sort_ops(n):
    """统计归并排序中的比较次数 (递推: T(n) = 2T(n/2) + n)."""
    if n <= 1:
        return 0
    half = n // 2
    return merge_sort_ops(half) + merge_sort_ops(n - half) + n

for n in [8, 64, 512, 4096, 32768]:
    ops = merge_sort_ops(n)
    predicted = n * jnp.log2(n)
    ratio = ops / predicted
    print(f"n={n:5d}  ops={ops:>10d}  n log n={int(predicted):>10d}  ratio={ratio:.3f}")
📌 本节要点
- 命题逻辑:用与/或/非/蕴涵/双条件在真值上做代数,真值表穷举所有情形。
- 德摩根律与逆否:否定"与/或"要翻转联结词;\(p \to q\) 与 \(\neg q \to \neg p\) 等价,是关键证明技巧。
- 谓词逻辑与量词: \(\forall\) 和 \(\exists\) 表达"所有/存在",嵌套顺序改变含义,是形式化规约的语言。
- 证明技巧:直接、反证、归纳、强归纳、鸽笼原理五大工具,递归算法的正确性天然对应归纳。
- 集合与基数:集合是最原始的数据结构;自然数可数、实数不可数,由此绝大多数函数不可计算。
- 关系:自反/对称/反对称/传递决定关系类型;等价关系划分等价类,偏序建模 happens-before.
- 函数:单射/满射/双射对应无损压缩、哈希、加密等计算原语;函数复合就是软件流水线。
- 图论:树、生成树、平面性、图着色、欧拉/哈密顿路径;哈密顿判定 NP 完全,与欧拉的多项式反差鲜明。
- 递推与主定理:主定理三种情形一眼定复杂度;归并排序落在均衡情形得 \(O(n \log n)\).
- 可计算性与复杂性:停机问题不可判定;P vs NP 是 CS 最重要开放问题,NP 完全问题通过归约互相等价。