强化学习¶
一句话总结:强化学习让智能体通过与环境交互、试错并最大化累计奖励来学会决策;本节梳理 MDP、值函数、贝尔曼方程、Q 学习、策略梯度、Actor-Critic、PPO 与 RLHF 这条主线。
强化学习通过试错与最大化累计奖励,训练智能体做出序贯决策。本节涵盖 MDP、值函数、贝尔曼方程、Q 学习、策略梯度、Actor-Critic 方法、PPO 以及 RLHF——这些正是玩游戏的智能体和大语言模型对齐背后的框架。
-
监督学习需要带标签的数据。无监督学习则在无标签数据里找规律。强化学习 (Reinforcement Learning, RL) 跟两者都不同:智能体通过与环境交互、执行动作、接收奖励来学习。这里没有"正确标签"这回事;智能体只能靠试错去摸索出好的行为。
-
想象一下教狗学新把戏。你不会给它看一个"正确行为数据集"。你只是让它自己尝试,做对了给零食,做错了不给,久而久之它就琢磨出你要什么。RL 就是把这个过程数学化。
-
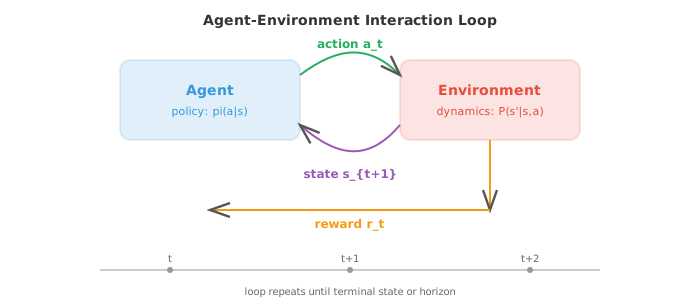
RL 的设定有五个核心组件。智能体 (agent) 是学习者、也是决策者。环境 (environment) 是智能体之外、与它交互的一切。每个时间步,智能体观察一个状态 (state) \(s_t\),选一个动作 (action) \(a_t\),收到奖励 (reward) \(r_t\),然后转移到新状态 \(s_{t+1}\)。它的目标是最大化随时间累积起来的总奖励。
-
策略 (policy) \(\pi\) 就是智能体的行动方案:从状态到动作的映射。确定性策略每个状态给一个动作:\(a = \pi(s)\)。随机策略给出动作上的概率分布:\(\pi(a \mid s)\)。RL 的目标就是找出最优策略——那个能最大化期望累计奖励的策略。
-
RL 的数学框架是马尔可夫决策过程 (Markov Decision Process, MDP),由五元组 \((S, A, P, R, \gamma)\) 定义:状态集合 \(S\)、动作集合 \(A\)、转移概率 \(P(s' \mid s, a)\)、奖励函数 \(R(s, a)\),以及折扣因子 \(\gamma\)。
-
马尔可夫性 (Markov property) (第 05 章讲过) 说:未来只取决于当前状态,跟你怎么走到这里无关:\(P(s_{t+1} \mid s_t, a_t, s_{t-1}, \ldots) = P(s_{t+1} \mid s_t, a_t)\)。也就是说,当前状态已经包含了做决策所需的全部信息。
-
折扣因子 (discount factor) \(\gamma \in [0, 1)\) 决定了智能体多在意未来的奖励、多在意眼前的奖励。从时刻 \(t\) 开始的折扣回报为:
-
\(\gamma = 0\) 时,智能体完全短视,只在乎下一步的奖励。\(\gamma\) 接近 1 时,则目光长远。折扣因子还保证了这个求和收敛 (只要奖励有界),这对数学定义的良好性很关键。
-
值函数 (value function) 用来衡量"待在某个状态里"或"在某个状态下采取某个动作"的好坏程度。状态值函数 (state-value function) \(V^\pi(s)\) 是从状态 \(s\) 出发、遵循策略 \(\pi\) 的期望回报:
- 动作值函数 (action-value function) \(Q^\pi(s, a)\) 是从状态 \(s\) 出发、先执行动作 \(a\)、之后再遵循 \(\pi\) 的期望回报:
-
两者的关系:\(V^\pi(s) = \sum_a \pi(a \mid s) \, Q^\pi(s, a)\)。状态值就是动作值按策略概率加权后的平均。
-
贝尔曼方程 (Bellman equation) 描述了一个递归关系:一个状态的值等于即时奖励,加上下一状态的折扣值。对状态值函数:
- 对于最优值函数 \(V^{*}(s)\),智能体每次都挑最好的动作:
- 类似地,贝尔曼最优方程 (Bellman optimality equation) 之于 \(Q^{*}\):
-
一旦有了 \(Q^{*}\),最优策略就非常简单:永远挑 Q 值最大的动作:\(\pi^{*}(s) = \arg\max_a Q^{*}(s, a)\)。
-
动态规划 (dynamic programming) 方法适用于你已知转移概率和奖励 (即完整模型) 的场景。策略评估 (policy evaluation) 通过反复应用贝尔曼方程、直到收敛,来计算给定策略下的 \(V^\pi\)。策略改进 (policy improvement) 拿到值函数后,通过贪心选择来构造一个更好的策略:\(\pi'(s) = \arg\max_a \sum_{s'} P(s' \mid s, a)[R(s,a) + \gamma V^\pi(s')]\)。
-
策略迭代 (policy iteration) 就是在评估和改进之间来回切换,直到策略不再变化。它保证收敛到最优策略。
-
值迭代 (value iteration) 把两步合并成一步:反复应用贝尔曼最优方程直到 \(V^{*}\) 收敛,然后再提取策略。
-
动态规划需要知道 \(P(s' \mid s, a)\),而现实里这通常不可行。大多数真实问题里,智能体并不知道环境的动力学,只能跟它交互。这时就轮到无模型 (model-free) 方法出场了。
-
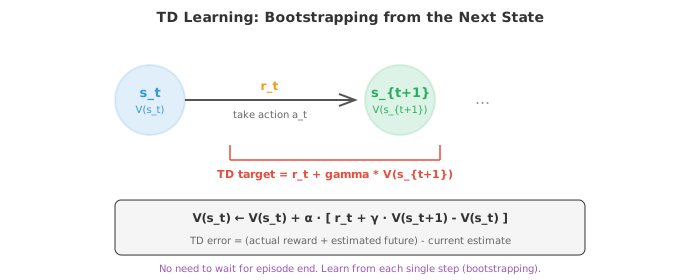
时序差分 (Temporal Difference, TD) 学习从经验里学习,无需环境模型。核心思想是自举 (bootstrapping):不等到一整个 episode 结束再算真实回报 \(G_t\),而是用当前值函数去估计它:
- 中括号里的这一项叫 TD 误差 (TD error):TD 目标 (TD target) (\(r_t + \gamma V(s_{t+1})\)) 与当前估计 \(V(s_t)\) 之差。TD 误差为正,说明这个状态比预期好,就把它的值调高;为负则调低。
-
TD 学习每走一步就更新一次 (不用等整个 episode 结束),所以比蒙特卡罗方法高效得多。它在连续型 (非 episodic) 环境里也能用。
-
SARSA (State-Action-Reward-State-Action) 就是把 TD 学习套到 Q 值上。智能体在状态 \(s\) 里执行动作 \(a\),观察到奖励 \(r\) 和下一状态 \(s'\),然后按当前策略选出下一个动作 \(a'\):
-
SARSA 是同策略 (on-policy):它用的是智能体实际执行的那个动作来更新,这里面包含了探索。因此 SARSA 更"保守":它学到的策略会把自己的探索噪声也考虑进去。
-
Q 学习 (Q-learning) 是最有名的 RL 算法。它跟 SARSA 类似,但不用智能体实际执行的动作,而是用所有可能动作里最好的那个:
-
Q 学习是异策略 (off-policy):无论正在执行什么策略,它都在学习最优 Q 值。智能体可以随机探索的同时,依然学到最优动作值。这让 Q 学习更"激进"、往往也收敛更快,但可能高估 Q 值。
-
探索与利用 (exploration vs exploitation) 是 RL 的根本困境:智能体应该利用已知的信息 (选估值最高的动作),还是去探索未知的动作 (说不定会更好)?
-
最简单的策略是 ε-贪心 (epsilon-greedy):以概率 \(\epsilon\) 随机选一个动作 (探索);以概率 \(1 - \epsilon\) 选贪心动作 (利用)。常见做法是初始 \(\epsilon\) 较大 (多探索),随时间衰减。
-
表格法 (给每个状态-动作对存一个值) 只对小型、离散的状态空间管用。状态空间一大或者连续,就得用函数近似。深度 Q 网络 (Deep Q-Network, DQN) 用一个神经网络来近似 \(Q(s, a; \theta)\),其中 \(\theta\) 是网络权重。
-
DQN 引入了两个至关重要的稳定化技巧。经验回放 (experience replay):不用连续 (高度相关) 的转移数据来学习,而是把转移存到一个回放缓冲区里,训练时从中随机采样小批。这样既打破了相关性,又能重复利用数据。
-
目标网络 (target network):用一份更新缓慢的网络副本来计算 TD 目标。要是没有它,每次更新网络都会让目标跟着动,形成"追自己尾巴"式的不稳定。目标网络可以周期性 (每 \(N\) 步一次硬更新) 或连续 (软更新:\(\theta^{-} \leftarrow \tau\theta + (1-\tau)\theta^{-}\)) 更新。
-
DQN 的损失就是预测 Q 值和 TD 目标之间的均方误差 (Mean Squared Error, MSE):
-
目前介绍的所有方法都是先学值函数、再从值函数导出策略。策略梯度 (policy gradient) 方法走另一条路:直接把策略 \(\pi(a \mid s; \theta)\) 参数化,然后对期望回报做梯度上升。
-
策略梯度定理 (policy gradient theorem) 给出了期望回报对策略参数的梯度:
-
它的意思是:让带来高回报的动作出现概率变高,让带来低回报的动作出现概率变低。log 概率的梯度指出策略要往哪个方向调,\(G_t\) 决定调多大幅度。
-
REINFORCE 是最简单的策略梯度算法。跑一整个 episode,对每一步算出回报 \(G_t\),然后更新:
- REINFORCE 方差很大,因为 \(G_t\) 是期望回报的一个单样本、带噪声的估计。常见的修正是减去一个基线 (baseline) (通常是平均回报或者一个学到的值函数),可以在不引入偏差的前提下降低方差:
-
⚠️ 符号方向陷阱 (sign convention pitfall): REINFORCE 是梯度上升 (gradient ascent)——我们要最大化期望回报 \(J(\theta) = \mathbb{E}_\pi[G_t]\),所以更新是 \(\theta \leftarrow \theta + \alpha \nabla_\theta J\)。别不小心写成减号:现代深度学习框架 (PyTorch、JAX 里的 optax、TensorFlow) 的优化器默认都在做梯度下降 (gradient descent) 最小化损失。所以正确做法是把损失定义成 \(\mathcal{L}(\theta) = -\log \pi(a_t \mid s_t; \theta) \cdot G_t\) (前面加负号),然后交给
optimizer.step();这两处"负号"抵消后,等价于对 \(J\) 做上升。这也是 Sutton & Barto (2018, §13.3) 里 REINFORCE 伪代码同时出现"加号更新式"与"负号损失式"的原因 [Sutton & Barto, Reinforcement Learning: An Introduction, 2nd ed., MIT Press, 2018]。 -
softmax 策略的对数梯度:如果策略是 \(\pi(a \mid s; \theta) = \text{softmax}(\theta_s)_a\),则 \(\nabla_{\theta_s} \log \pi(a \mid s; \theta) = \mathbf{e}_a - \pi(\cdot \mid s; \theta)\),也就是"动作 \(a\) 的 one-hot 向量 减 当前概率分布"。顺序不能反:\(\pi - \mathbf{e}_a\) 号就翻了,梯度上升就退化成了梯度下降,训练里会看到最优臂概率反而降低。这是策略梯度实现里最常见的坐标级 bug 之一,见文末 REINFORCE 老虎机代码里的
grad_log_pi = (-probs).at[action].add(1.0)写法——先把整个概率向量取反、再在采样动作处+1,得到 \(\mathbf{e}_a - \pi\)。写成-probs.at[action].add(1.0)由于运算优先级实际算出的是 \(-(\pi + \mathbf{e}_a)\),完全错。 -
快速自检 (sanity check):跑几百步后,最优臂的概率应该单调上升并逼近 1;如果反而下降或者收敛到均匀分布,八成是符号或梯度公式反了。也可以用
optax.softmax_cross_entropy_with_integer_labels(logits, action)直接得到 \(-\log \pi(a)\),再乘以 \(G_t\) 作为标量损失,交给标准优化器,这条路径能规避手写梯度出错。 -
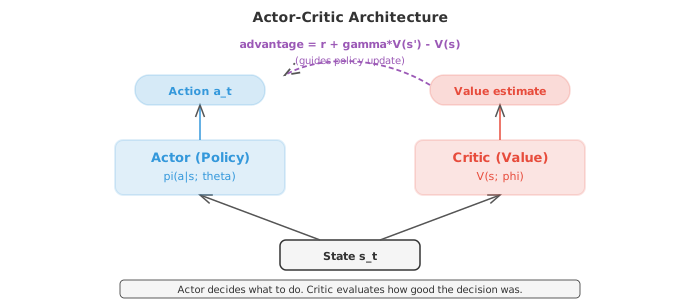
Actor-Critic 方法用两个网络。Actor (演员) 就是策略 \(\pi(a \mid s; \theta)\)。Critic (评论家) 是一个值函数 \(V(s; \phi)\),充当基线。优势 \(A_t = r_t + \gamma V(s_{t+1}) - V(s_t)\) 取代了 \(G_t - b\):
- Critic 通过最小化 TD 误差来更新,跟基于值的方法一样。Actor 则用策略梯度更新,Critic 提供的优势估计负责降低方差。这就是两全其美。
-
PPO (Proximal Policy Optimization,近端策略优化) 是实际中用得最多的策略梯度算法。它解决了一个关键问题:策略一次更新如果太大,性能可能会灾难性崩溃。
-
PPO 用的是裁剪代理目标 (clipped surrogate objective)。设 \(r_t(\theta) = \frac{\pi(a_t | s_t; \theta)}{\pi(a_t | s_t; \theta_{\text{old}})}\) 是新旧策略的概率比。损失为:
-
这里的裁剪 (通常 \(\epsilon = 0.2\)) 阻止概率比偏离 1 太远,从而保持更新幅度小、稳定。优势为正 (动作好),比率被压在 \(1 + \epsilon\);优势为负 (动作差),比率被压在 \(1 - \epsilon\)。这比早期的信赖域方法 (Trust Region Policy Optimization, TRPO) 更简单、也更稳。
-
PPO 就是被用来通过基于人类反馈的强化学习 (Reinforcement Learning from Human Feedback, RLHF) 训练 ChatGPT 那类模型的算法。RLHF 里,先用人类偏好数据 (两个输出里,人更喜欢哪个?) 训一个奖励模型,再用 PPO 优化语言模型的策略,去最大化这个学到的奖励。
-
DPO (Direct Preference Optimization,直接偏好优化) 干脆把奖励模型这一整块去掉,简化了 RLHF。DPO 不训奖励模型、不跑 RL,而是推导出一个闭式损失,直接从偏好数据优化策略:
-
这里 \(y_w\) 是被偏好的 (胜出) 回答,\(y_l\) 是被舍弃的 (落败) 回答。DPO 提升偏好输出的相对概率,实现上比基于 PPO 的 RLHF 简单得多。
-
RL 算法里还有两组重要区分。同策略 vs 异策略 (on-policy vs off-policy):同策略方法 (SARSA、PPO) 只能从当前策略产生的数据里学;异策略方法 (Q 学习、DQN) 可以从任何策略产生的数据里学。异策略更样本高效 (旧数据能复用),但稳定性可能差一些。
-
有模型 vs 无模型 (model-based vs model-free):无模型方法 (前面讨论的都是) 直接从经验中学值或学策略。有模型方法则学一个环境模型 (\(P(s' \mid s, a)\) 和 \(R(s, a)\)),然后用它做规划 (在脑子里想未来的轨迹,不实际执行动作)。有模型方法更样本高效,但要多付一份"学一个准确模型"的复杂度。
-
把 RL 全景总结一下:
| 方法 | 类型 | 核心思想 | 优点 |
|---|---|---|---|
| 值迭代 | 动态规划 (DP),有模型 | 贝尔曼最优 | 精确解 (小型 MDP) |
| SARSA | TD,同策略 | 同策略地学 Q | 保守、安全 |
| Q 学习 | TD,异策略 | 学 Q*,贪心目标 | 简单有效 |
| DQN | 深度、异策略 | 神经 Q + 回放 + 目标网络 | 可扩展到高维状态 |
| REINFORCE | 策略梯度 | log 概率梯度 × 回报 | 最简单的策略优化 |
| Actor-Critic | 策略梯度 + 值 | Actor + Critic 降方差 | 实用、灵活 |
| PPO | 策略梯度,带裁剪 | 类信赖域的稳定性 | 业界标配 |
| DPO | 直接偏好 | 跳过奖励模型 | 更简单的 RLHF |
编程练习 (推荐用 CoLab 或 notebook)¶
-
为一个简单的 gridworld 实现值迭代。计算最优值函数并提取最优策略。用热力图和箭头图分别可视化。
import jax.numpy as jnp import matplotlib.pyplot as plt # 4x4 gridworld: 目标位于 (3,3),每一步 -1,到达目标 0 grid_size = 4 gamma = 0.99 goal = (3, 3) # 动作: 上、下、左、右 actions = [(-1, 0), (1, 0), (0, -1), (0, 1)] action_names = ['up', 'down', 'left', 'right'] action_arrows = ['↑', '↓', '←', '→'] def step(s, a): """确定性转移.""" ns = (max(0, min(grid_size-1, s[0]+a[0])), max(0, min(grid_size-1, s[1]+a[1]))) return ns # 值迭代 V = jnp.zeros((grid_size, grid_size)) for iteration in range(100): V_new = jnp.array(V) for i in range(grid_size): for j in range(grid_size): if (i, j) == goal: continue values = [] for a in actions: ns = step((i, j), a) values.append(-1 + gamma * float(V[ns[0], ns[1]])) V_new = V_new.at[i, j].set(max(values)) if jnp.max(jnp.abs(V_new - V)) < 1e-6: print(f"Converged in {iteration+1} iterations") break V = V_new # 提取策略 policy = [['' for _ in range(grid_size)] for _ in range(grid_size)] for i in range(grid_size): for j in range(grid_size): if (i, j) == goal: policy[i][j] = 'G' continue best_a = max(range(4), key=lambda a: -1 + gamma * float(V[step((i,j), actions[a])[0], step((i,j), actions[a])[1]])) policy[i][j] = action_arrows[best_a] fig, axes = plt.subplots(1, 2, figsize=(10, 4)) im = axes[0].imshow(V, cmap='YlOrRd_r') axes[0].set_title("Optimal Value Function") for i in range(grid_size): for j in range(grid_size): axes[0].text(j, i, f"{V[i,j]:.1f}", ha='center', va='center', fontsize=10) plt.colorbar(im, ax=axes[0]) axes[1].imshow(jnp.ones((grid_size, grid_size)), cmap='Greys', vmin=0, vmax=2) axes[1].set_title("Optimal Policy") for i in range(grid_size): for j in range(grid_size): axes[1].text(j, i, policy[i][j], ha='center', va='center', fontsize=18) plt.tight_layout(); plt.show() -
在一个简单 gridworld 上实现表格式 Q 学习。训练智能体、画出学习曲线、并展示学到的 Q 值。
import jax import jax.numpy as jnp import matplotlib.pyplot as plt grid_size = 5 goal = (4, 4) actions = [(-1,0), (1,0), (0,-1), (0,1)] # Q 表 Q = {} for i in range(grid_size): for j in range(grid_size): Q[(i,j)] = [0.0] * 4 alpha = 0.1 gamma = 0.95 epsilon = 1.0 epsilon_decay = 0.995 min_epsilon = 0.01 def step(s, a_idx): a = actions[a_idx] ns = (max(0, min(grid_size-1, s[0]+a[0])), max(0, min(grid_size-1, s[1]+a[1]))) r = 0.0 if ns == goal else -1.0 done = ns == goal return ns, r, done key = jax.random.PRNGKey(42) rewards_per_episode = [] for ep in range(500): s = (0, 0) total_reward = 0 for _ in range(100): key, subkey = jax.random.split(key) if float(jax.random.uniform(subkey)) < epsilon: key, subkey = jax.random.split(key) a = int(jax.random.randint(subkey, (), 0, 4)) else: a = max(range(4), key=lambda i: Q[s][i]) ns, r, done = step(s, a) total_reward += r # Q 学习更新 Q[s][a] += alpha * (r + gamma * max(Q[ns]) - Q[s][a]) s = ns if done: break rewards_per_episode.append(total_reward) epsilon = max(min_epsilon, epsilon * epsilon_decay) plt.figure(figsize=(8, 4)) # 平滑曲线 window = 20 smoothed = [sum(rewards_per_episode[max(0,i-window):i+1])/min(i+1, window) for i in range(len(rewards_per_episode))] plt.plot(smoothed, color='#3498db', linewidth=1.5) plt.xlabel("Episode"); plt.ylabel("Total Reward (smoothed)") plt.title("Q-Learning on Gridworld") plt.grid(alpha=0.3); plt.show() # 展示学到的策略 arrow = ['↑', '↓', '←', '→'] print("Learned policy:") for i in range(grid_size): row = "" for j in range(grid_size): if (i,j) == goal: row += " G " else: row += f" {arrow[max(range(4), key=lambda a: Q[(i,j)][a])]} " print(row) -
在一个多臂老虎机问题上实现 REINFORCE。展示训练过程中策略是如何逐渐偏向最优臂的。
import jax
import jax.numpy as jnp
import matplotlib.pyplot as plt

# 5 臂老虎机,各臂期望奖励不同
true_rewards = jnp.array([0.2, 0.5, 0.8, 0.3, 0.1])
n_arms = len(true_rewards)

# 策略: 对 logits 做 softmax
logits = jnp.zeros(n_arms)
lr = 0.1
key = jax.random.PRNGKey(42)

policy_history = []
reward_history = []

for step in range(2000):
    probs = jax.nn.softmax(logits)
    policy_history.append(probs)

    # 采样动作
    key, subkey = jax.random.split(key)
    action = jax.random.choice(subkey, n_arms, p=probs)

    # 获取奖励 (Bernoulli)
    key, subkey = jax.random.split(key)
    reward = float(jax.random.uniform(subkey) < true_rewards[action])
    reward_history.append(reward)

    # REINFORCE 更新
    # softmax 参数化下: grad log pi(a) = e_a - probs
    grad_log_pi = (-probs).at[action].add(1.0)  # one-hot(a) - probs
    logits = logits + lr * reward * grad_log_pi

policy_history = jnp.stack(policy_history)

fig, axes = plt.subplots(1, 2, figsize=(12, 4))
colors = ['#3498db', '#e74c3c', '#27ae60', '#9b59b6', '#f39c12']
for i in range(n_arms):
    axes[0].plot(policy_history[:, i], color=colors[i],
                 label=f'Arm {i} (true={true_rewards[i]:.1f})', linewidth=1.5)
axes[0].set_xlabel("Step"); axes[0].set_ylabel("P(arm)")
axes[0].set_title("Policy Evolution (REINFORCE)")
axes[0].legend(fontsize=8); axes[0].grid(alpha=0.3)

# 平滑奖励
window = 50
smoothed = [sum(reward_history[max(0,i-window):i+1])/min(i+1,window)
            for i in range(len(reward_history))]
axes[1].plot(smoothed, color='#27ae60', linewidth=1.5)
axes[1].axhline(y=0.8, color='#e74c3c', linestyle='--', alpha=0.5, label='Best arm')
axes[1].set_xlabel("Step"); axes[1].set_ylabel("Avg Reward")
axes[1].set_title("Reward Over Time"); axes[1].legend()
axes[1].grid(alpha=0.3)
plt.tight_layout(); plt.show()
📌 本节要点¶
- 强化学习范式:智能体通过与环境交互、试错、最大化累计奖励来学习,无需带标签数据。
- MDP 五元组: \((S, A, P, R, \gamma)\),其中马尔可夫性保证当前状态含全部决策信息。
- 值函数与贝尔曼方程: \(V^\pi\)、\(Q^\pi\) 满足递归的贝尔曼方程;最优值函数满足贝尔曼最优方程。
- 动态规划:已知模型时用策略迭代或值迭代求最优策略,需要转移概率已知。
- TD 学习:无模型、自举、单步更新;SARSA 同策略保守,Q 学习异策略激进。
- DQN 稳定化:经验回放打破相关性,目标网络防"追尾"不稳定,损失为 MSE。
- 策略梯度:直接优化参数化策略;REINFORCE 高方差,用基线降方差。
- Actor-Critic: Actor 学策略、Critic 学值函数当基线,用优势 \(A_t\) 替代原始回报。
- PPO 与 RLHF:裁剪概率比保证稳定;PPO 是训练 ChatGPT 类模型的 RLHF 主力算法。
- DPO 简化:从偏好数据直接推导闭式损失,跳过奖励模型,比 PPO-RLHF 更易落地。