抽样
一句话总结:抽样决定了我们如何收集数据,直接左右每一个结论的可信度;本节梳理四种概率抽样方法、抽样分布与中心极限定理 (Central Limit Theorem, CLT),它们是机器学习中训练/测试划分和数据集构建的基石。
抽样决定了我们如何收集数据,也直接左右我们得出的每一条结论的可靠性。 本节涵盖随机抽样、分层抽样、整群抽样、系统抽样,以及抽样分布、大数定律和自助法,都是机器学习 (Machine Learning, ML) 里做训练/测试划分与数据集构建时不可或缺的方法.
-
理想情况下,你会去测量你关心群体里的每一个个体。 但现实几乎不可能:你没法调查每一位选民、测试每一个灯泡,或扫描每一位病人。 于是我们退而求其次,抽一份样本 (sample),用它来推断整体。
-
总体 (population) 是你想研究的全部个体或事物。 样本 (sample) 是你实际观察到的那一小部分。
-
参数 (parameter) 是描述总体的数字 (例如某国全体成年人的真实平均身高).
-
统计量 (statistic) 是从样本里算出来的数字 (例如你测量的 500 人的平均身高). 我们用统计量去估计参数。
-
结论好不好,完全取决于你怎么选样本。 有偏的样本会导致有偏的结论,无论后续分析多花哨。
-
抽样框 (sampling frame) 是你实际用来抽样的完整名单。 理想情况下它和总体完全吻合,但现实里总有缺口。
-
举个例子,如果你用电话调查,你就漏掉了所有没电话的人。 抽样框和总体之间的差距叫做覆盖误差 (coverage error).
-
抽样误差 (sampling error) 是样本统计量与总体参数之间天然存在的偏差。
-
即使是一个完全随机的样本,也不会与总体完全一致。 样本越大,抽样误差越小。
-
抽样大致分两大类:概率抽样与非概率抽样。
-
概率抽样 (probability sampling) 意味着总体中每个成员都有一个已知的、非零的入选概率。 这样才能量化不确定性,也才能把结果推广到总体。
-
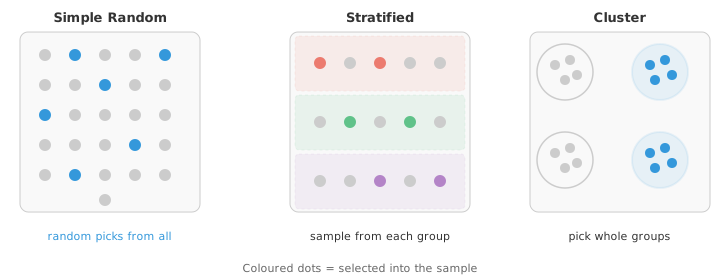
简单随机抽样 (simple random sampling):每个个体的入选机会均等,每个大小为 \(n\) 的可能样本被抽到的概率也相同。 想象把每个人的名字写进帽子里,闭着眼睛往外摸。
-
分层抽样 (stratified sampling):按某个共同特征 (如年龄段、地区) 把总体划分成互不重叠的组 (层),然后在每一层里各自随机抽样。 这样能保证每组都有代表,当各层差异较大时还能降低估计的方差。
-
整群抽样 (cluster sampling):把总体分成若干群 (cluster),随机挑几个群,然后把选中群里的所有人都纳入样本。 当总体在地理上分散时,这种方法特别实用,比如抽整所学校而不是跨全区抽学生个体。
-
系统抽样 (systematic sampling):先随机取一个起点,然后每隔 \(k\) 个抽一个。 例如从第 7 个人开始,之后取第 17、27、…… 个。 实现简单,但如果名单本身有隐藏的周期规律,就可能引入偏差。
-
非概率抽样 (non-probability sampling) 不给每个成员一个已知的入选概率。 结果无法严格推广到总体,但这类方法通常更快、更便宜。
-
便利抽样 (convenience sampling):谁最好找就选谁。 在商场门口做街访很方便,但漏掉了不去商场的人。
-
配额抽样 (quota sampling):像分层抽样,但去掉随机性。 研究者按配额 (例如 50 名男性、50 名女性) 在每组里挑容易接触到的人。
-
滚雪球抽样 (snowball sampling):先找几位参与者,再让他们推荐其他人。 适合难以触达的群体 (例如罕见病研究),但严重偏向社交圈广的人。
-
一旦定了抽样方法,一个自然的问题就来了:如果换一批样本,我得到的统计量会不会变?几乎肯定会变。 抽样分布 (sampling distribution) 就是同一统计量 (如样本均值) 在所有等大小样本上取值的分布。
-
想象一下:抽 1,000 份不同的、每份 30 人的样本,分别算出平均身高。 这 1,000 个均值形成一个分布。 有的会略高于真实总体均值,有的略低,但大多数会聚在真实值附近。
-
这个抽样分布的标准差叫做标准误 (standard error, SE):
-
注意,\(n\) 越大,标准误越小。 样本越大,估计越精确。 样本量翻四倍,标准误砍一半。
-
统计学里最重要的结果是中心极限定理 (Central Limit Theorem, CLT). 它说:无论原始总体长什么样,只要样本量足够大,样本均值的分布就会趋近正态分布。
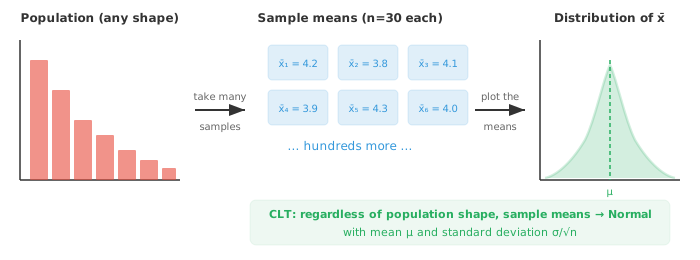
- 更精确地说,如果 \(X_1, X_2, \ldots, X_n\) 是来自任意分布的独立观测,该分布均值为 \(\mu\)、方差有限为 \(\sigma^2\),那么随着 \(n\) 增大:
-
CLT 是推断统计学能跑得起来的根本原因。 它让我们即使在底层数据非正态时,也能用正态分布做近似,前提是样本足够大。
-
那"足够大"到底多大?常见的经验法则是 \(n \ge 30\),但具体要看总体偏离正态的程度。 高度偏态的分布可能需要更多样本;大致对称的总体,甚至 \(n = 10\) 就够用。
-
CLT 有三个关键前提:
- 独立性 (independence):各观测之间不能相互影响
- 方差有限 (finite variance):总体方差必须存在 (这排除了某些异形分布)
- 同分布 (identical distribution):所有观测来自同一个分布
编程练习 (在 CoLab 或 notebook 里运行)
-
用可视化演示 CLT:从一个高度偏态的分布里抽样、计算样本均值,观察均值的直方图逐渐变成钟形。
import jax import jax.numpy as jnp import matplotlib.pyplot as plt key = jax.random.PRNGKey(0) # 指数分布 (高度偏态) population = jax.random.exponential(key, shape=(100_000,)) fig, axes = plt.subplots(1, 4, figsize=(14, 3)) sample_sizes = [1, 5, 30, 100] for ax, n in zip(axes, sample_sizes): keys = jax.random.split(key, 2000) means = jnp.array([jax.random.choice(k, population, shape=(n,)).mean() for k in keys]) ax.hist(means, bins=40, color="#3498db", alpha=0.7, density=True) ax.set_title(f"n = {n}") ax.set_xlim(0, 4) fig.suptitle("CLT: sample means become normal as n increases", fontsize=13) plt.tight_layout() plt.show() -
对比简单随机抽样与分层抽样。 构造一个包含明显不同组的总体,展示分层抽样能让估计的方差更小。
import jax import jax.numpy as jnp key = jax.random.PRNGKey(42) # 总体: 两个明显不同的组 group_a = jax.random.normal(key, shape=(500,)) + 10 # 均值约 10 key, subkey = jax.random.split(key) group_b = jax.random.normal(subkey, shape=(500,)) + 20 # 均值约 20 population = jnp.concatenate([group_a, group_b]) # 简单随机抽样: 1000 次试验, 每次抽 20 个 srs_means = [] for i in range(1000): key, subkey = jax.random.split(key) sample = jax.random.choice(subkey, population, shape=(20,), replace=False) srs_means.append(sample.mean()) srs_means = jnp.array(srs_means) # 分层抽样: 每组各抽 10 个 strat_means = [] for i in range(1000): key, k1, k2 = jax.random.split(key, 3) s_a = jax.random.choice(k1, group_a, shape=(10,), replace=False) s_b = jax.random.choice(k2, group_b, shape=(10,), replace=False) strat_means.append(jnp.concatenate([s_a, s_b]).mean()) strat_means = jnp.array(strat_means) print(f"Simple Random - Mean: {srs_means.mean():.3f}, Std: {srs_means.std():.3f}") print(f"Stratified - Mean: {strat_means.mean():.3f}, Std: {strat_means.std():.3f}") print(f"Stratified sampling reduced variance by {(1 - strat_means.var()/srs_means.var())*100:.1f}%") -
探索样本量如何影响标准误。 画出标准误随样本量的变化,验证 \(1/\sqrt{n}\) 关系。
import jax
import jax.numpy as jnp
import matplotlib.pyplot as plt

key = jax.random.PRNGKey(7)
population = jax.random.normal(key, shape=(50_000,)) * 10 + 50

sample_sizes = [5, 10, 20, 50, 100, 200, 500, 1000]
std_errors = []

for n in sample_sizes:
    means = []
    for _ in range(500):
        key, subkey = jax.random.split(key)
        sample = jax.random.choice(subkey, population, shape=(n,))
        means.append(sample.mean())
    std_errors.append(jnp.array(means).std())

plt.figure(figsize=(8, 4))
plt.plot(sample_sizes, std_errors, "o-", color="#e74c3c", label="Observed SE")
theoretical = population.std() / jnp.sqrt(jnp.array(sample_sizes, dtype=jnp.float32))
plt.plot(sample_sizes, theoretical, "--", color="#3498db", label="σ/√n (theoretical)")
plt.xlabel("Sample size (n)")
plt.ylabel("Standard error")
plt.legend()
plt.title("Standard error shrinks with larger samples")
plt.show()
📌 本节要点
- 总体与样本:总体是你关心的全部个体,样本是你实际观察到的子集;样本质量决定结论质量。
- 参数 vs 统计量:参数描述总体 (通常未知),统计量从样本算出,用来估计参数。
- 概率抽样四大方法:简单随机、分层、整群、系统抽样,每个成员的入选概率已知且非零,结果可推广。
- 非概率抽样:便利、配额、滚雪球抽样,快而便宜,但无法严格推广到总体。
- 抽样误差与覆盖误差:前者是样本与总体的天然偏差,后者源自抽样框与总体的差距。
- 抽样分布:同一统计量在所有等大小样本上的分布,均值围绕真实参数波动。
- 标准误公式: \(SE = \sigma / \sqrt{n}\),样本量翻四倍,标准误砍一半。
- 中心极限定理 (CLT):无论原总体形状如何,样本均值随 \(n\) 增大趋近正态分布,是推断统计的地基。
- CLT 三前提:独立性、有限方差、同分布,三条都要满足。
- 实践意义:分层抽样在训练/测试划分中降低方差,CLT 让我们在非正态数据上仍能用正态近似做推断。